Na maioria das equipas que adotam a programação agêntica, o estrangulamento passa da geração para a revisão; sem corrigir este ciclo, o ganho líquido de velocidade é quase nulo.
Em ambientes de CI de grande escala — milhões de testes noturnos e centenas de engenheiros —, a tarefa de maior valor para um agente é encaminhar os problemas para os responsáveis e fazer a triagem, não gerar código.
Os resultados úteis de um agente resistem a uma análise rigorosa e explicam a causalidade, em vez de se limitarem a identificar padrões.
Conceber a camada de recolha de evidências e composição de contexto é mais importante do que a camada de geração.
Grande parte do debate sobre programação agêntica ainda parte de uma promessa simples: escrever mais código, mais depressa.
Por vezes, esta ideia evolui para uma visão mais ambiciosa, em que os agentes planeiam o trabalho, abrem PR e entregam alterações com uma intervenção humana mínima. Mas, para a maioria das equipas de engenharia, o valor mais evidente a curto prazo é mais específico. Trata-se de reduzir o custo da iteração.
A entrega de software não se resume à geração de código. Escrever código é apenas uma etapa de um ciclo mais longo, que inclui revisão, testes, implementação e investigação quando algo corre mal. A maioria das equipas que adota a programação agêntica sem reformular o ciclo de revisão limita-se a transferir o estrangulamento para uma fase posterior.
Acelerar apenas a geração não torna automaticamente uma equipa mais rápida. Pode simplesmente transferir mais esforço para a revisão, a verificação e a criação de confiança.
Em muitos contextos de engenharia, o mais dispendioso não é produzir um primeiro rascunho, mas adquirir confiança no resultado.
A alteração resolveu realmente o problema ou melhorou o sistema? Introduziu uma regressão noutro ponto? A falha está no código, no ambiente, nos testes ou numa dependência? A correção proposta resolve a causa ou apenas o sintoma visível?
Os agentes podem ajudar, não porque substituam os engenheiros, mas porque conseguem fazer uma primeira análise estruturada de evidências desorganizadas: examinar registos, comparar alterações recentes, resumir sinais relevantes, identificar causas prováveis, executar verificações e devolver algo que uma pessoa possa questionar.
Em muitas equipas, a utilização de maior impacto para um agente não é gerar código de raiz. É reduzir o espaço de procura em torno de um problema antes que alguém passe horas a fazê-lo manualmente.
Isto é particularmente evidente nos fluxos de depuração em grande escala. Imagine uma CI noturna que executa milhões de testes em bases de código alteradas por centenas de engenheiros — uma realidade para um dos nossos clientes. Quando algo falha, é difícil encaminhar o problema para os responsáveis. O problema pode estar no código da aplicação, numa dependência, no harness de testes ou noutro ponto da stack. Os registos podem ocupar gigabytes, e a primeira equipa a detetar o problema nem sempre é a responsável por ele.
Este tipo de fluxo de trabalho não exige naturalmente que um único agente escreva a correção. Foi concebido para um sistema que reduza rapidamente o espaço do problema.
Um pipeline útil pode recolher registos, selecionar as evidências relevantes, resumir o que importa, inspecionar código num ambiente isolado e produzir uma análise estruturada da causa principal, com pontuação de confiança, rastreabilidade e próximos passos sugeridos. Para gerar uma pontuação de confiança, um especialista no domínio avalia o resultado inicial do agente. Esta avaliação é depois fornecida a um LLM como juiz para automatizar as pontuações futuras, mantendo o alinhamento com o juízo humano.
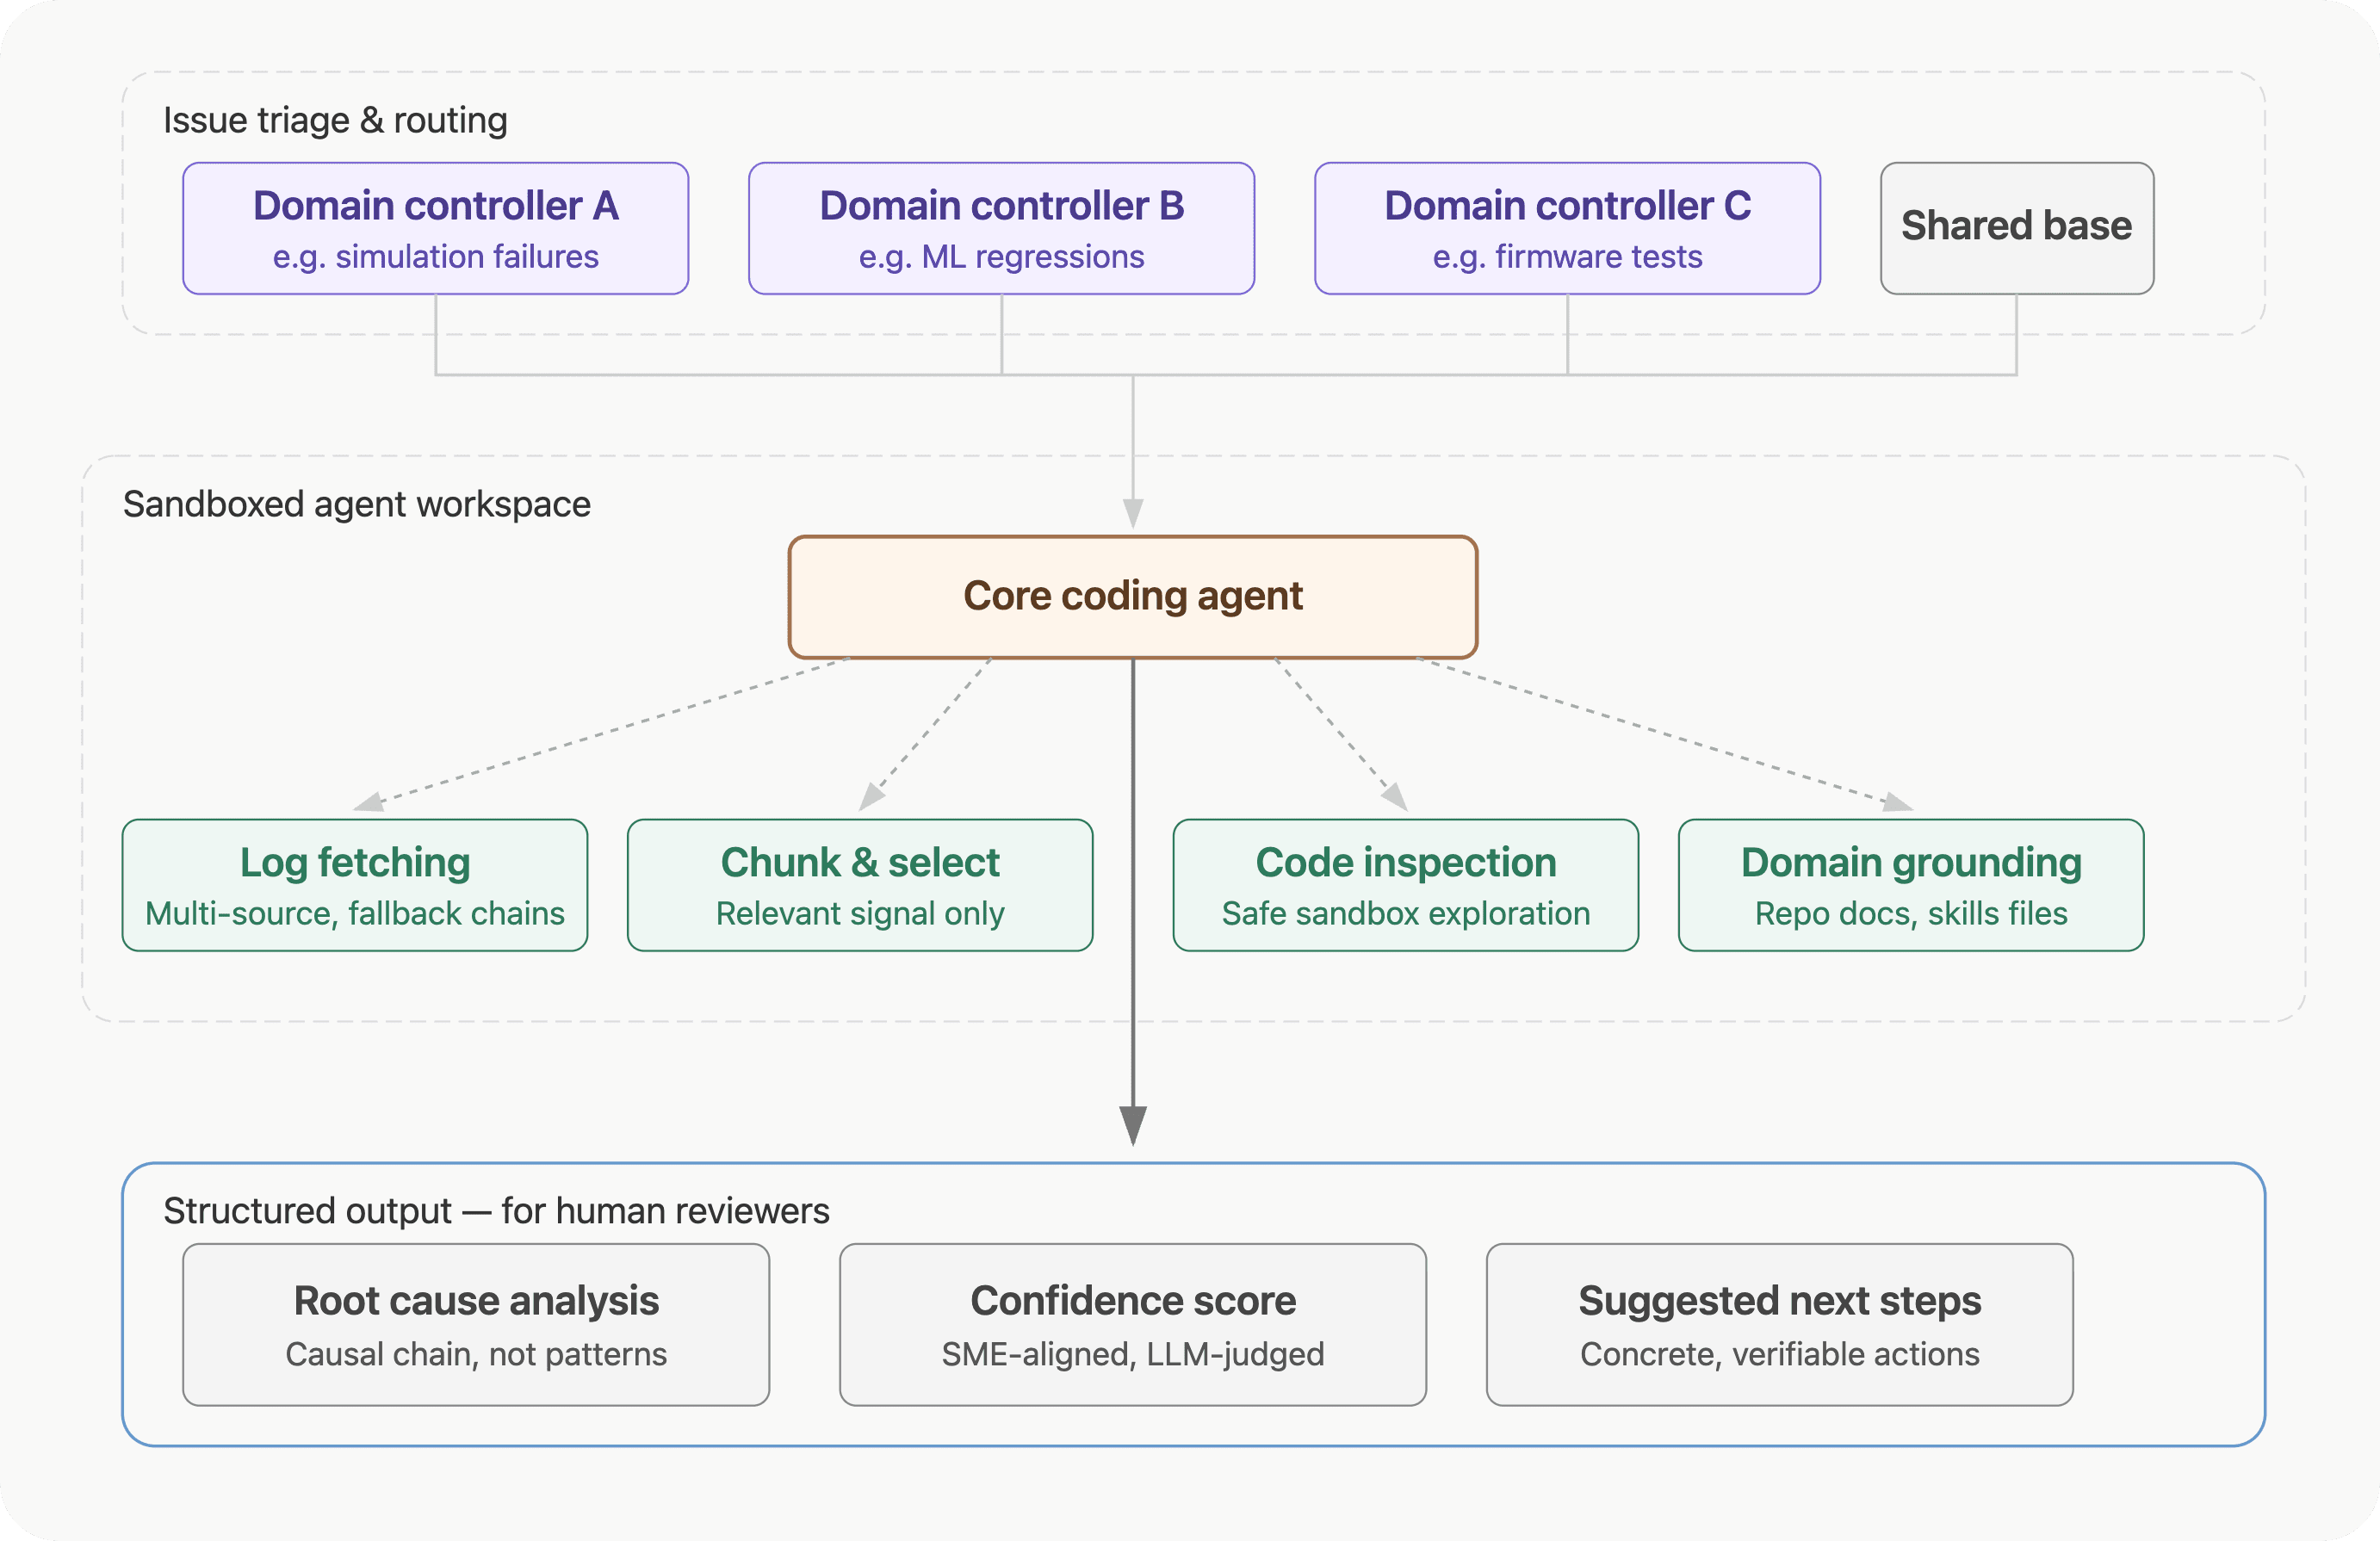
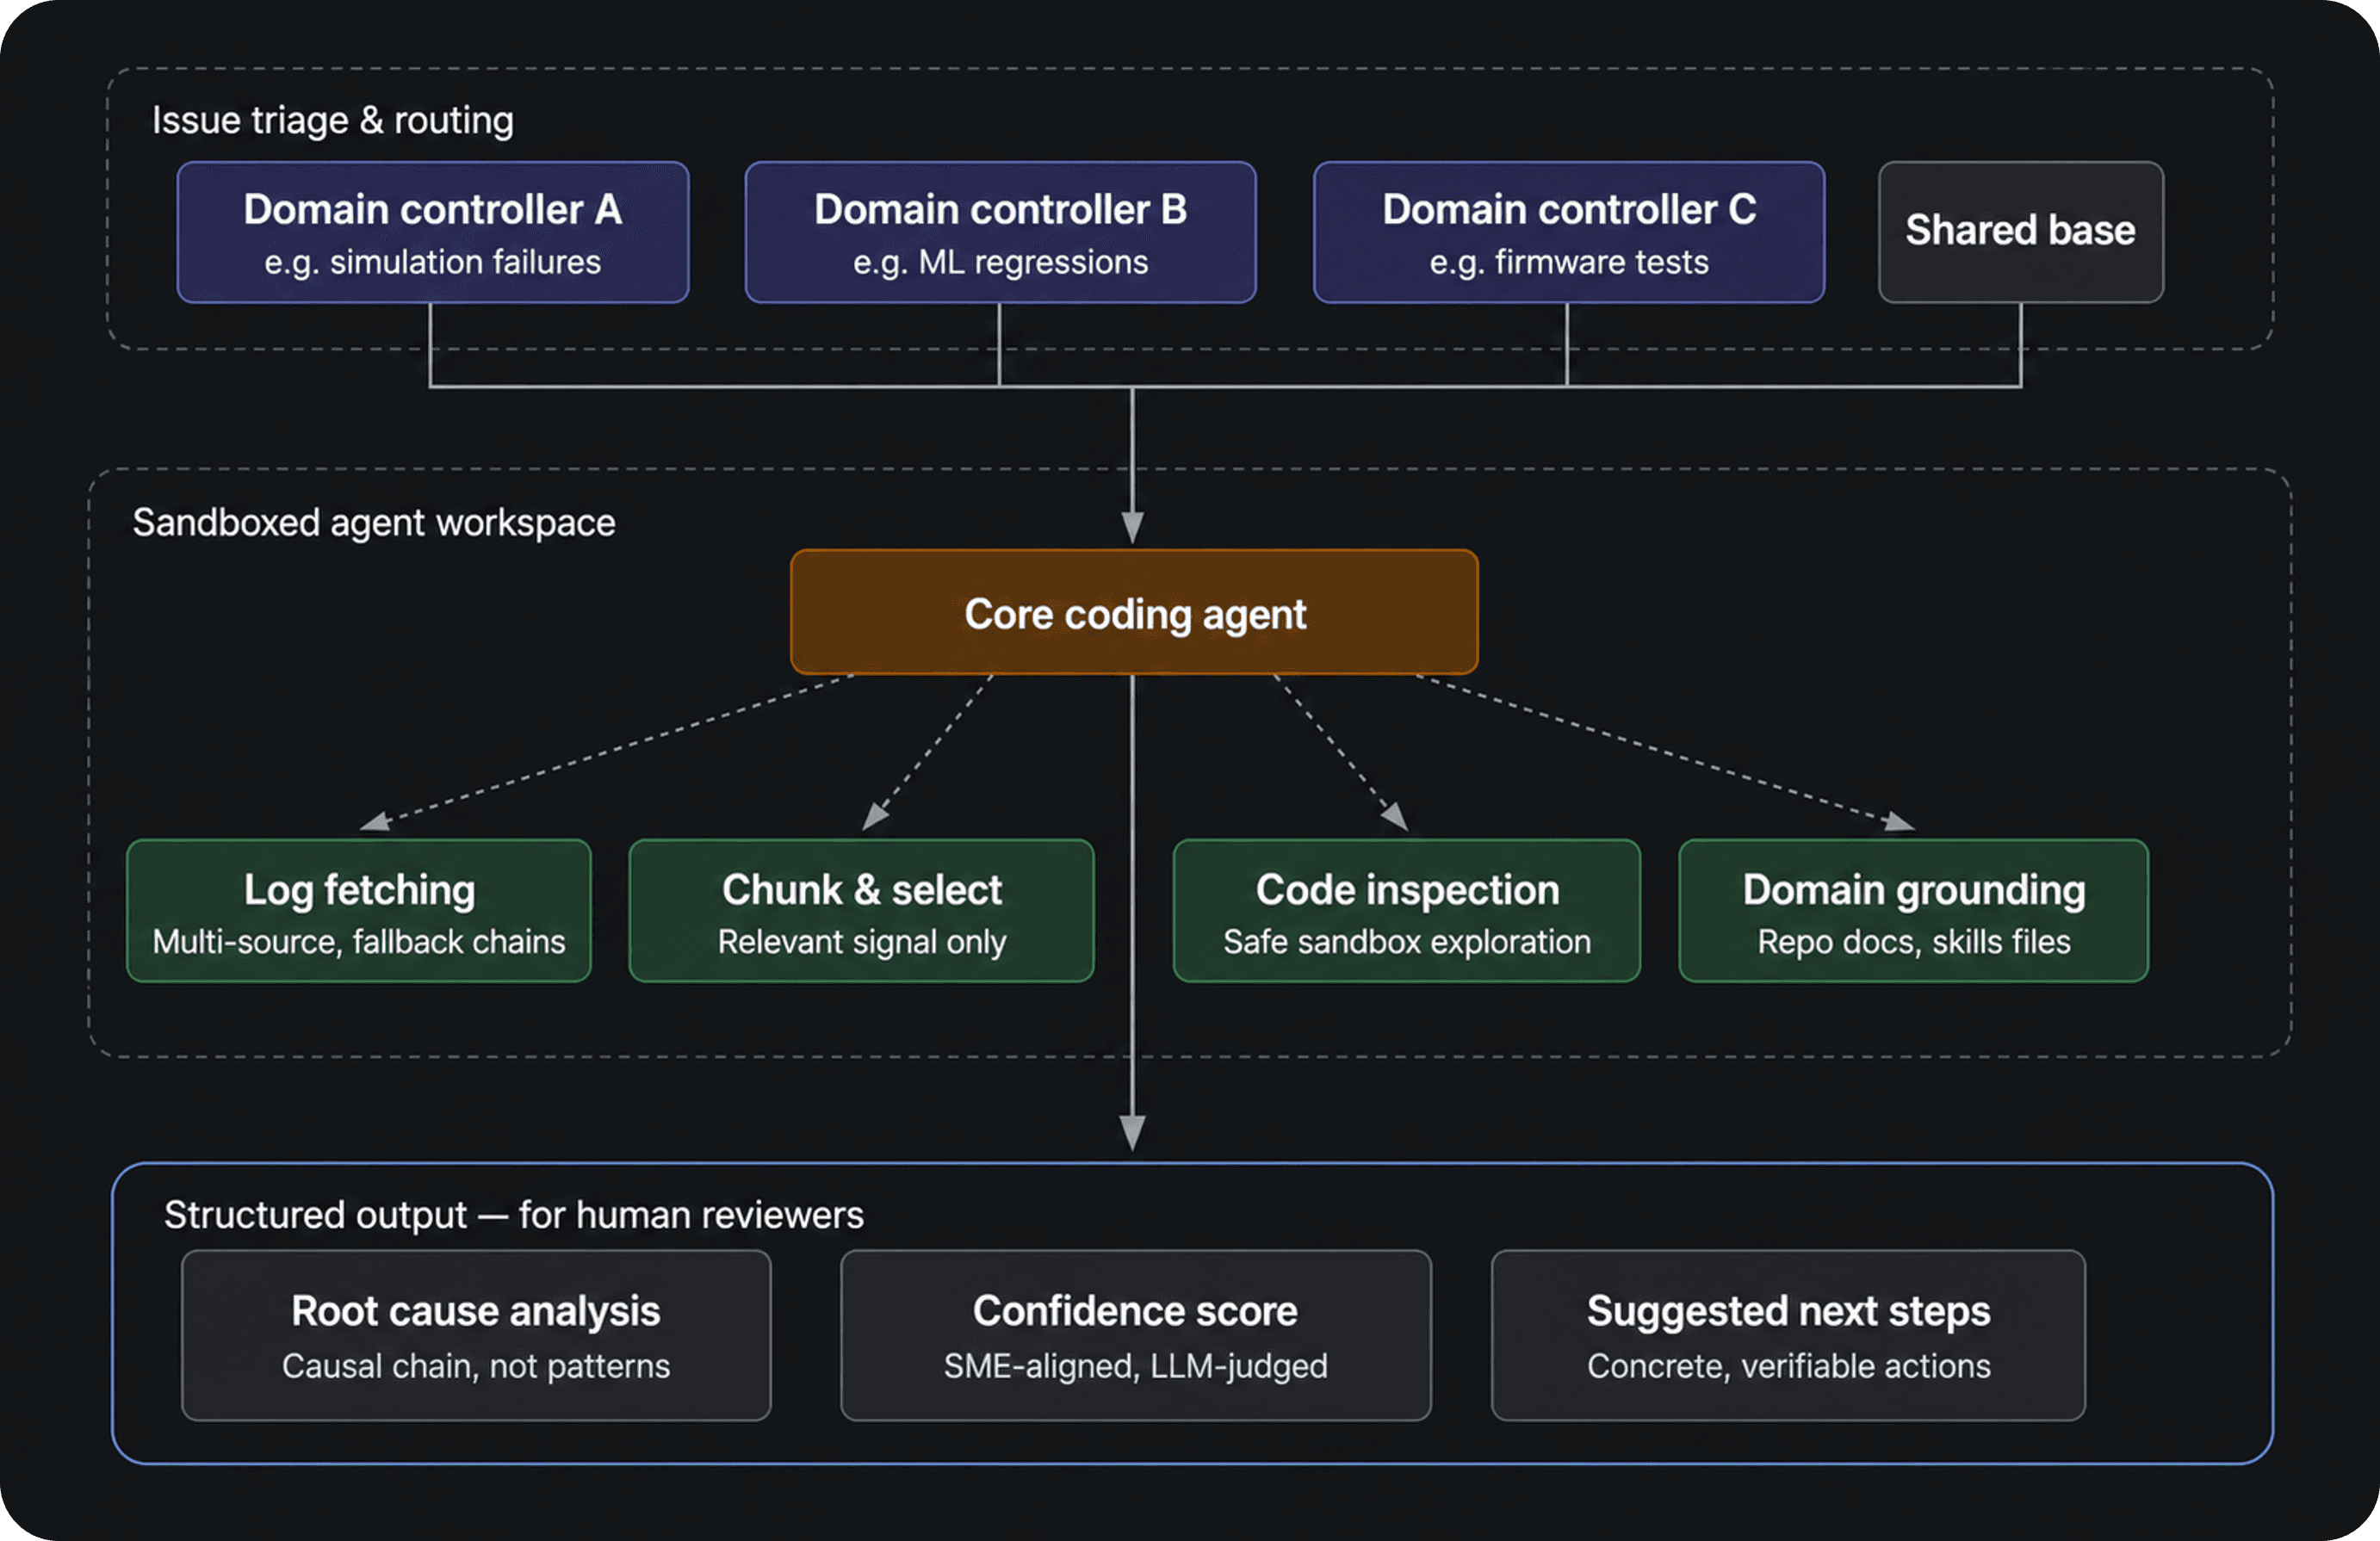
O objetivo não é eliminar o juízo dos engenheiros, mas dar aos revisores um ponto de partida mais sólido. A triagem de regressões, a revisão de PR, a correção de testes, a validação de versões e a investigação após a implementação seguem todas o mesmo padrão. Exigem muitas evidências e revisões e estão repletas de ambiguidades. Não pedem a um agente que substitua o processo de engenharia, apenas que ajude a fazê-lo avançar.
É também por isso que as equipas devem avaliar estes sistemas com cuidado.
A pergunta errada é se um agente consegue produzir isoladamente algo impressionante. A melhor pergunta é se melhora um fluxo de trabalho real sem criar entraves noutro ponto.
Isso implica verificar se o resultado é suficientemente específico para ser validado, se explica a causalidade em vez de se limitar a identificar padrões e se facilita a revisão em vez de a dificultar. Uma resposta plausível não é necessariamente útil. Na prática, as equipas confiam nos resultados de um agente quando estes resistem a uma análise rigorosa e oferecem algo concreto para verificar.
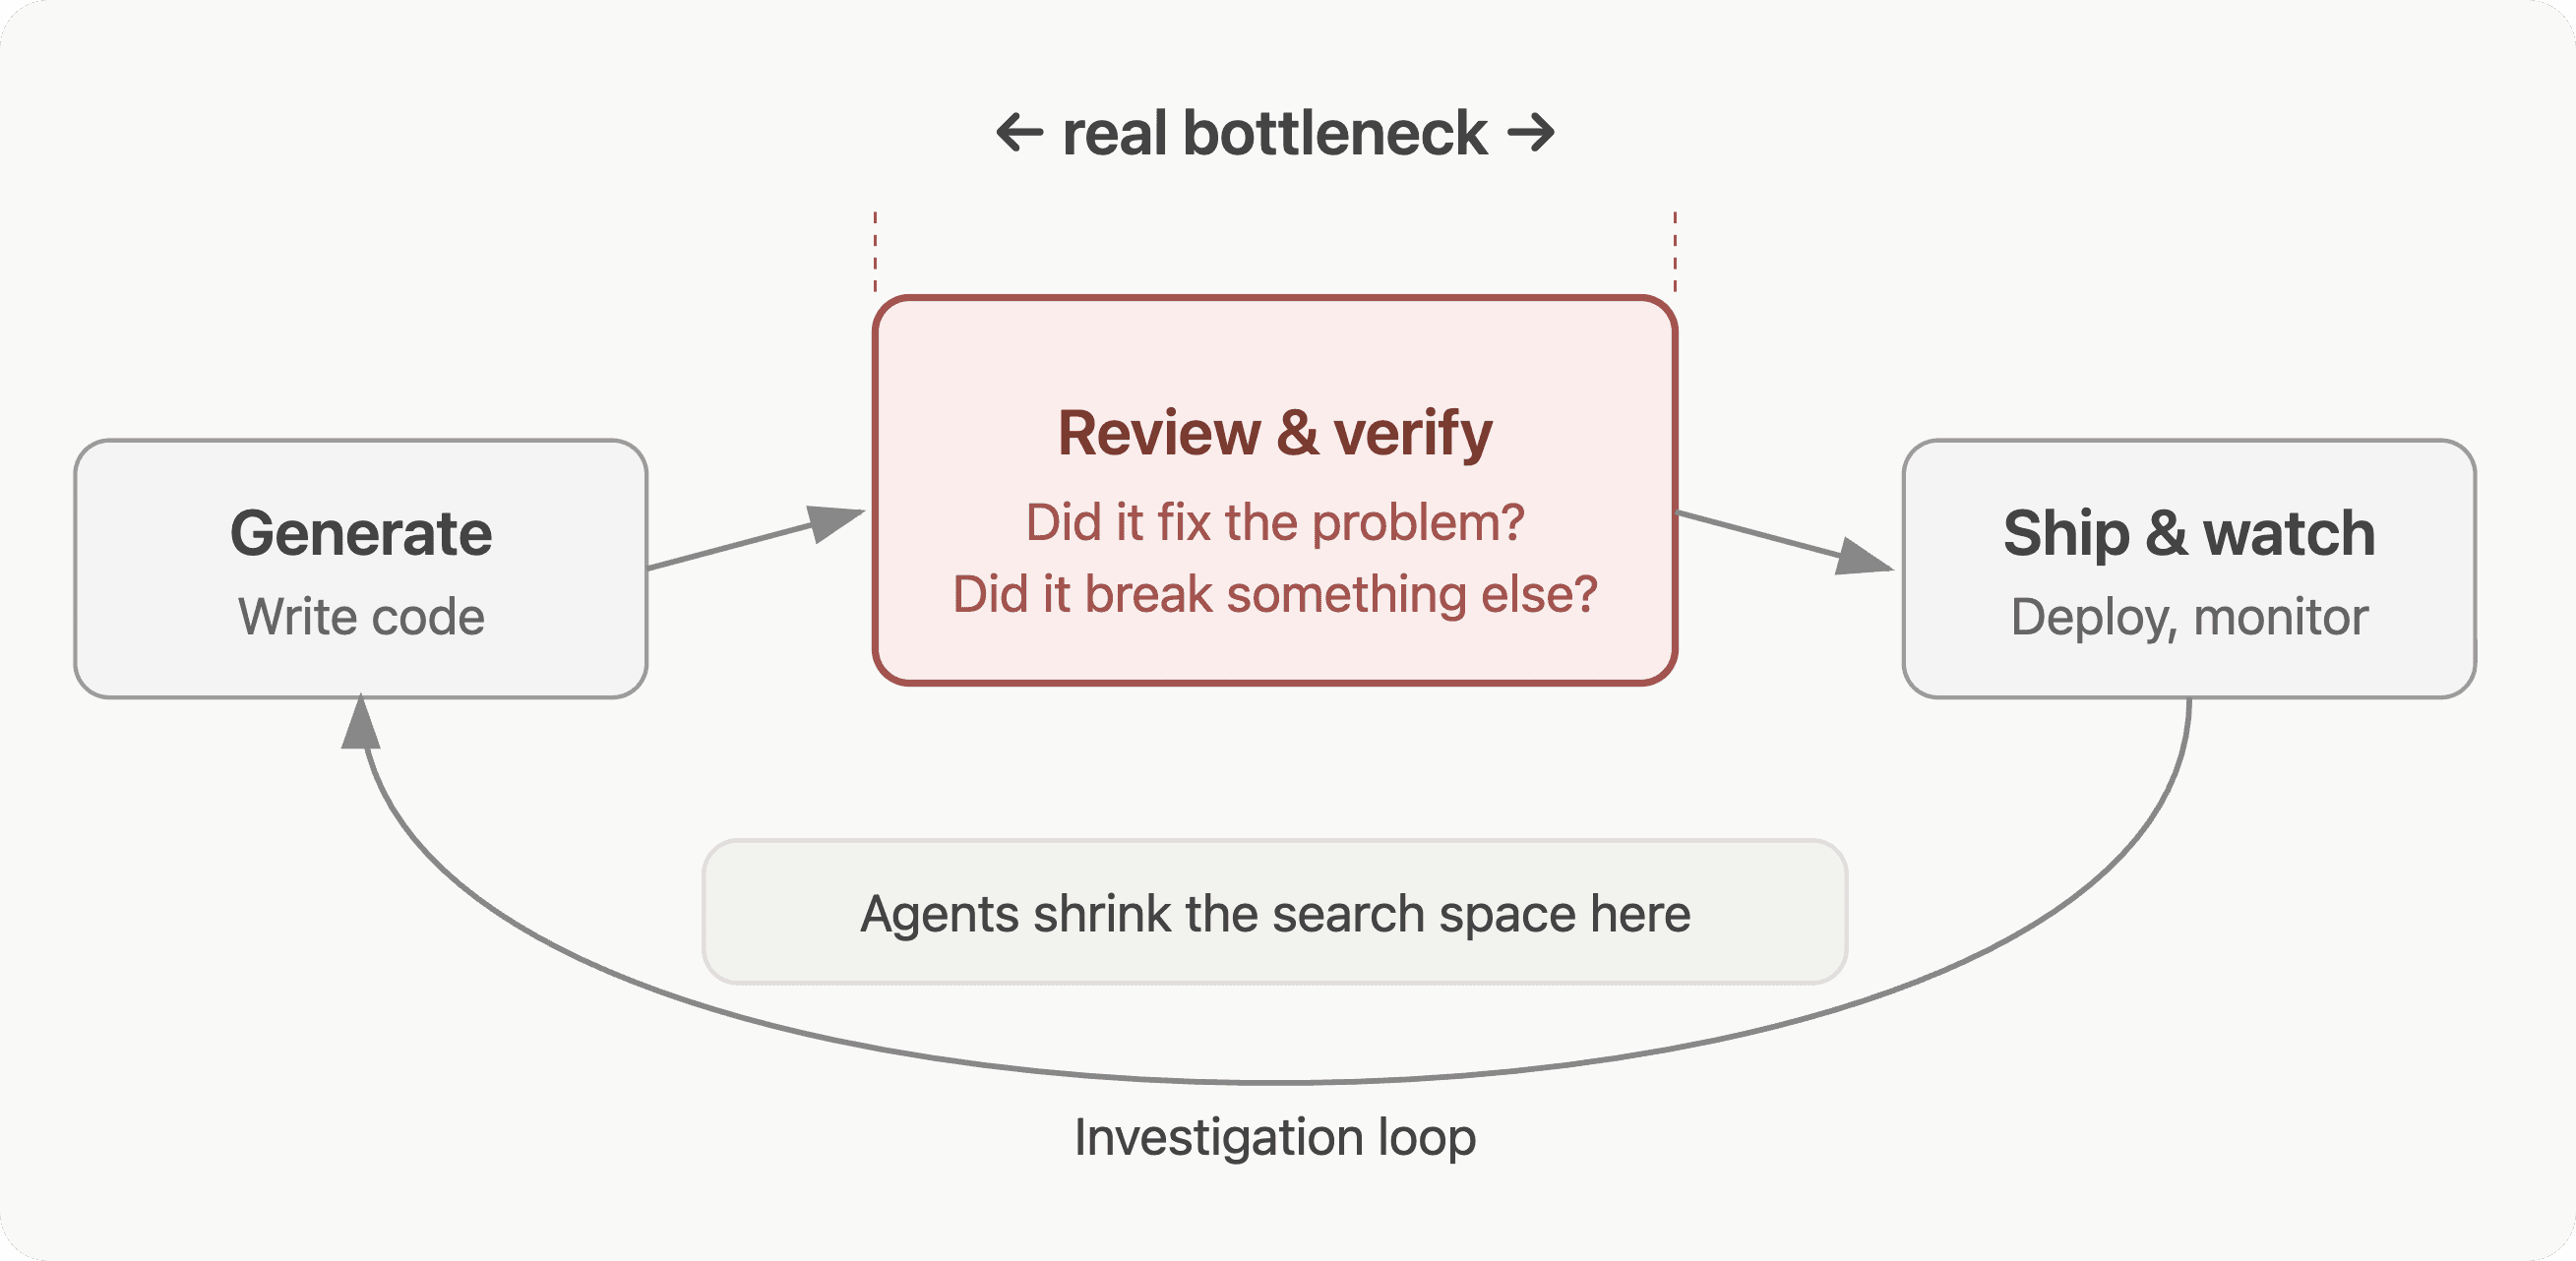
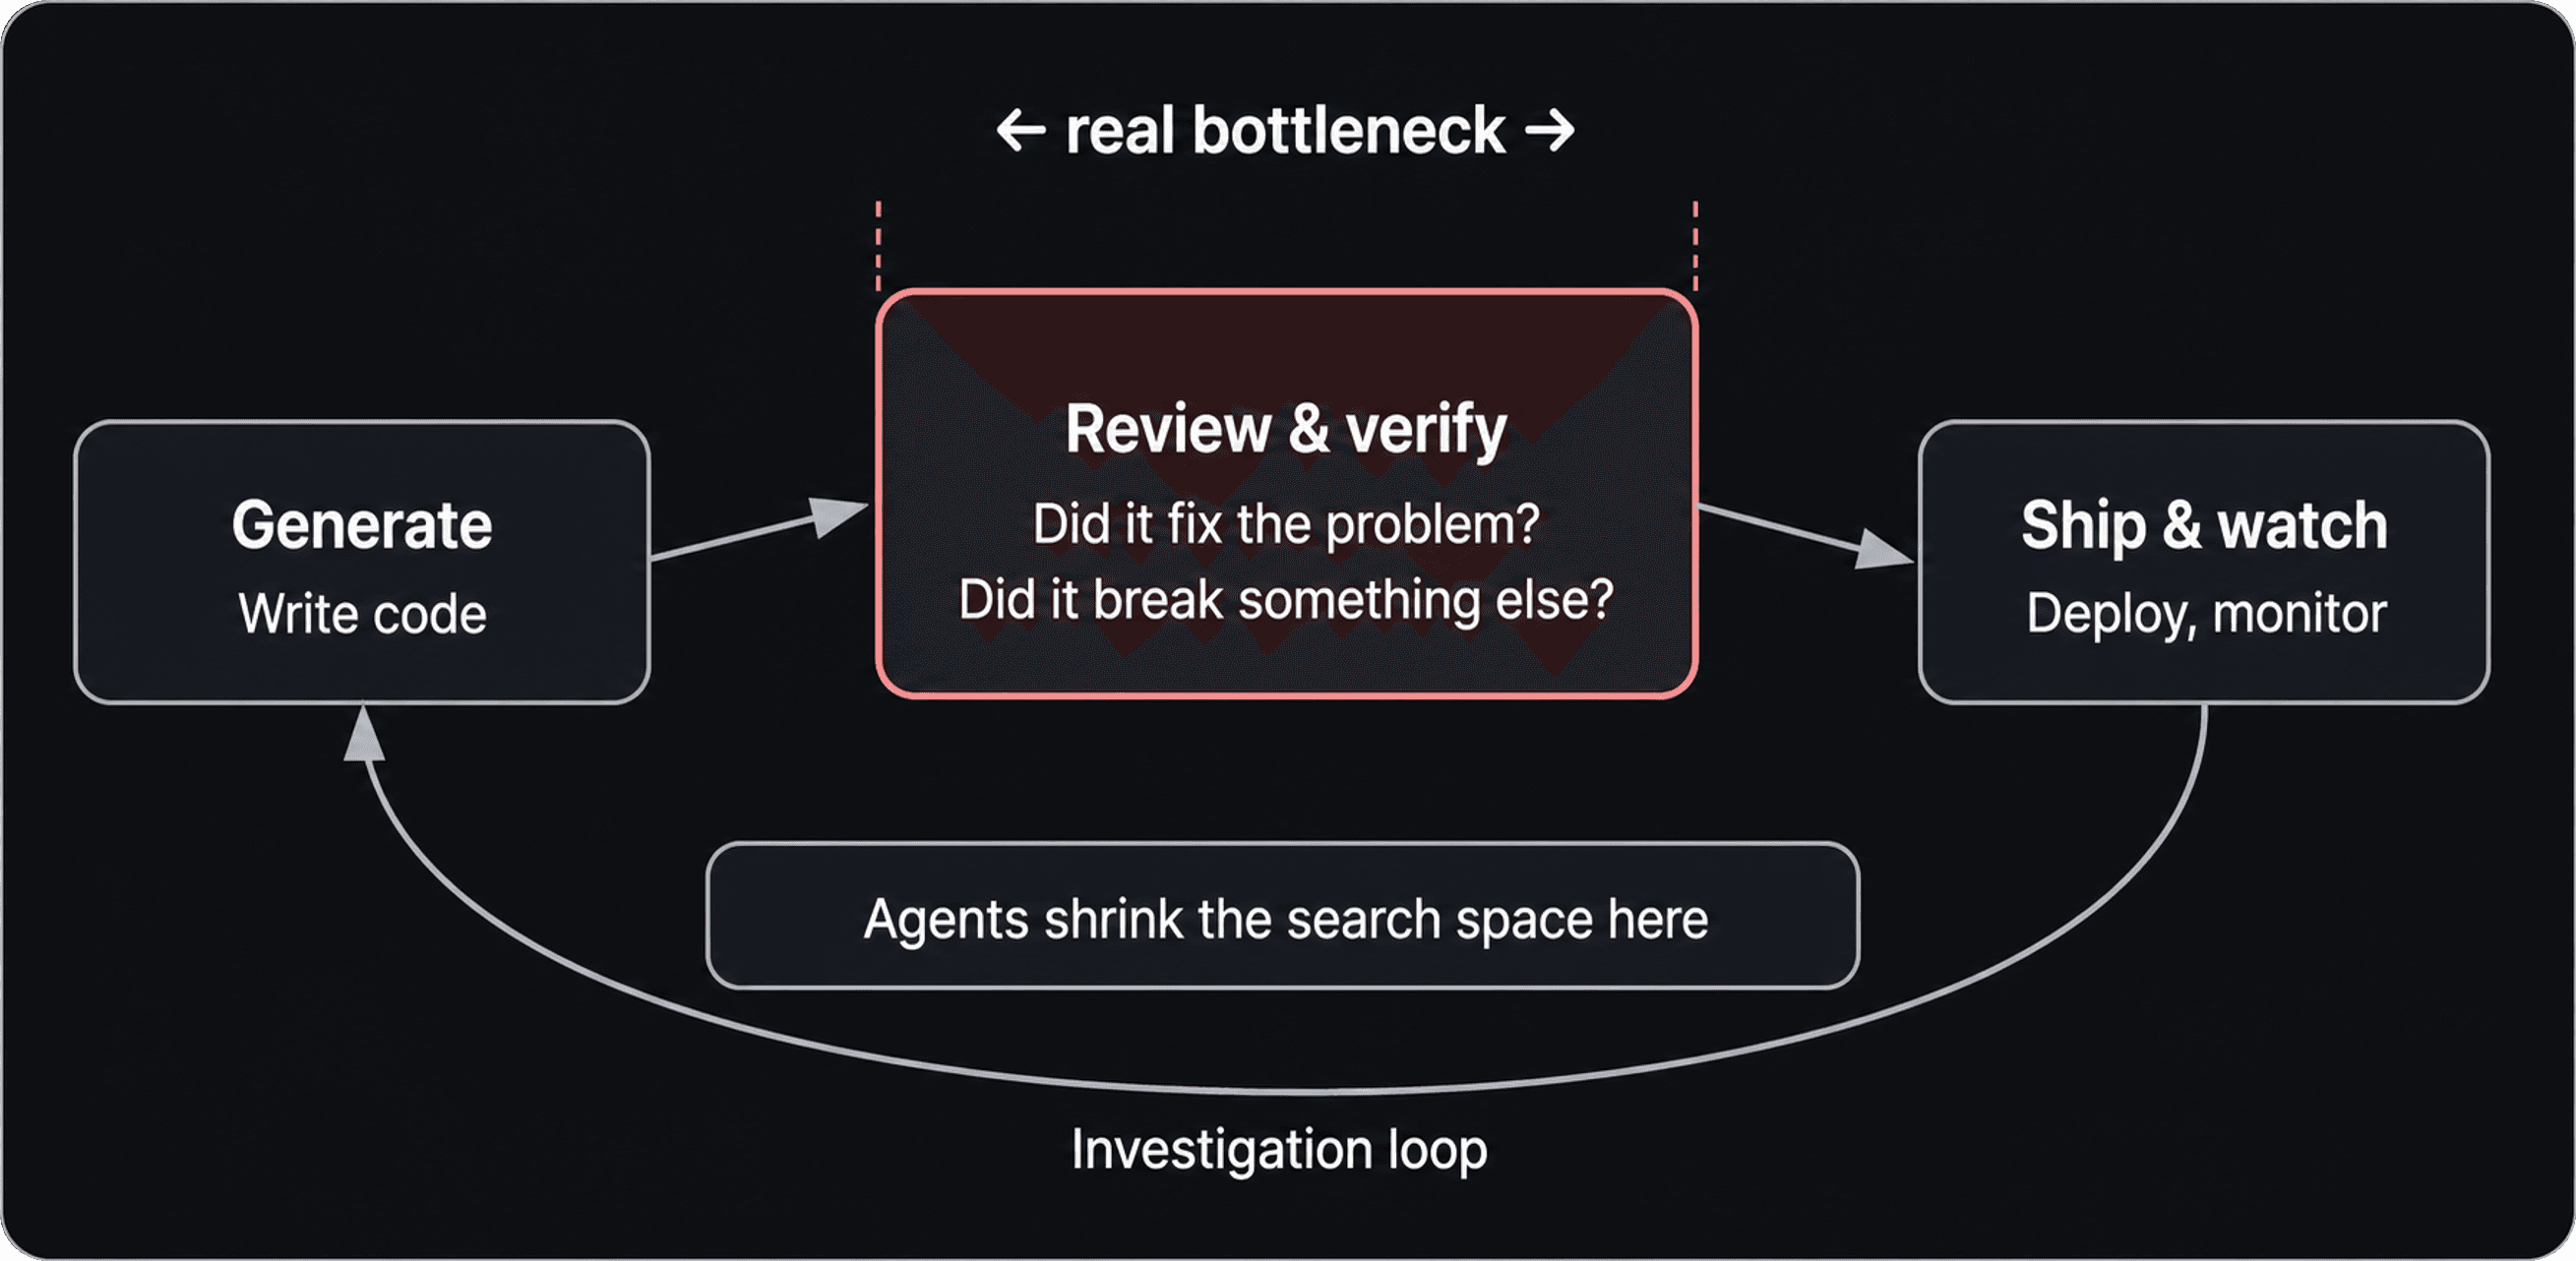
A conclusão mais profunda é que os sistemas agênticos úteis dependem de mais do que a geração. Dependem da forma como se recolhem as evidências, se compõe o contexto, se verificam os resultados e se apresenta a incerteza ao revisor.
É por isso que é pouco provável que o futuro próximo da engenharia agêntica dê um salto único para a autonomia total. É mais provável que consista num conjunto de ciclos rigorosamente concebidos, nos quais os agentes ajudam as equipas a inspecionar, rever, verificar e aperfeiçoar o trabalho, reduzindo o esforço desperdiçado entre etapas.
Pode ser menos espetacular do que a narrativa mais abrangente da autonomia, mas está muito mais próximo da forma como os sistemas úteis são realmente adotados.