الگوهای زبانی بزرگ (LLMها) در هر لحظه فقط میتوانند حجم محدودی از متن را «ببینند»؛ این همان پنجره زمینه است. این روش برای کارهای کوچک مناسب است، اما وقتی پایگاه دانش هزاران صفحه داشته باشد، کارایی خود را از دست میدهد. حتی اگر پنجره زمینه کافی باشد، باز هم ممکن است عملکرد بهدلیل مشکل «پیداکردن سوزن در انبار کاه» افت کند.
RAG («تولید تقویتشده با بازیابی») به الگویی بسیار رایج تبدیل شده است: یک پایگاه دانش شامل اسناد، ویکیها، خطمشیها، رونوشتها و موارد دیگر نگهداری میکنید؛ با استفاده از تعبیهسازی، جستوجویی معنایی روی پرسش کاربر انجام میدهید تا مرتبطترین بخشها را بازیابی کنید؛ سپس آن بخشها را همراه پرسش به الگوهای زبانی بزرگ (LLM) میدهید. این کار زمینه مدل را محدود میکند و اگر درست انجام شود، میتواند کیفیت پاسخ را بهبود دهد و توهمات را کاهش دهد.
pgai افزونهای متنباز برای Postgres، همراه با ابزارهای مکمل، است که به شما کمک میکند گردشکارهای «بازیابی هوش مصنوعی» را بر بستر پایگاه داده متنباز و قابلاعتماد PostgreSQL بسازید.
ایده اصلی این است که بخش بیشتری از خط لوله استاندارد RAG به لایه پایگاه داده منتقل شود (دریافت ← قطعهبندی ← تعبیهسازی ← همگام نگهداشتن تعبیهها)، نه اینکه پایگاه داده صرفاً «محل ذخیرهسازی» تعبیهها باشد.
برداشت اولیه ما این است که این پروژه امیدوارکننده است، اما بهمحض اینکه خط لوله RAG شما حتی اندکی پیچیده شود—بهویژه در روشهای قطعهبندی—دیگر مناسب نیست. بااینحال، این پروژه را از نزدیک دنبال خواهیم کرد.
روشهای زیادی برای ساخت RAG وجود دارد. برای بررسی مفصلتر رویکردهای مختلف، مطلب نمونههای عملی راهکارهای سفارشی RAG. را بخوانید. وقتی کیفیت مهم باشد، فضای طراحی بهطرز شگفتآوری پیچیده میشود. رویکرد «پیشفرض» رایج معمولاً چنین است:
مجموعهای از اسناد را بردارید.
آنها را به قطعههای کوچکتر تقسیم کنید. برای این کار روشهای گوناگونی وجود دارد؛ مانند تقسیمبندی بر اساس پاراگراف یا گروهبندی معنایی.
هر قطعه را به یک تعبیه تبدیل کنید.
تعبیهها را در یک پایگاه داده برداری مانند Pinecone یا Milvus، یا با استفاده از pgvector در Postgres ذخیره کنید.
هنگام اجرای پرسوجو، نزدیکترین قطعهها را جستوجو کنید `و آنها را به الگوهای زبانی بزرگ (LLM) بدهید؛ البته برای این کار نیز روشهای زیادی وجود دارد.
در بسیاری از پشتههای فناوری، مراحل (۱) تا (۳) بیرون از پایگاه داده و در کد برنامه یا خط لوله داده انجام میشوند و پایگاه داده عمدتاً برای این موارد به کار میرود:
ذخیرهسازی تعبیهها
جستوجوی تعبیهها
pgai افزونهای متنباز برای Postgres است که Timescale آن را توسعه داده است و میکوشد مرز میان این بخشها را کمرنگ کند.
بهجای اینکه تعبیهها چیزی باشند که برنامه شما دستی مدیریت میکند، pgai آنها را به یکی از قابلیتهای پایگاه داده تبدیل میکند:
مشخص میکنید کدام جدول یا اسناد باید تعبیه شوند.
مدل تعبیهسازی و راهبرد قطعهبندی را تعیین میکنید.
pgai بقیه کارها را مدیریت میکند؛ از جمله بهروز نگهداشتن تعبیهها همزمان با تغییر دادههای مبدأ.
این وعده جذاب است:
کد واسط سفارشی کمتری برای نگهداری نیاز است.
با تغییر اسناد مبدأ، تازه و بهروز نگهداشتن تعبیهها باید آسانتر شود.
Postgres/pgai تلاشهای مجدد، محدودیت نرخ، کارهای ناموفق و موارد دیگر را مدیریت میکند.
یادداشت برای خواننده: pgai افزونه pgvector، یکی دیگر از افزونههای بسیار محبوب RAG برای Postgres، را در خود دارد. pgvector ذخیرهسازی برداری و جستوجوی شباهت را به Postgres اضافه میکند؛ pgai نیز بر همین پایه، مراحل خط لوله RAG مانند قطعهبندی، تعبیهسازی و بهروز نگهداشتن تعبیهها را خودکار میکند.
۱) راهاندازی آن ساده است.
در حالت عادی، روند کار نسبتاً ساده است:
ایمیجهای Docker متعلق به Timescale را دریافت کنید؛ یکی برای پایگاه داده و دیگری برای worker.
کلید API ارائهدهنده تعبیهسازی را وارد کنید.
چند دستور کوتاه SQL اجرا کنید تا vectoriser را تعریف کنید؛ یعنی چه چیزی تعبیه شود، چگونه قطعهبندی شود و از کدام مدل استفاده شود.
پس از آن، pgai یک worker ویژه vectoriser را در فرایندی جداگانه اجرا میکند تا تعبیهها را بهصورت ناهمگام تولید کند؛ مثلاً هر ۵ دقیقه یا با هر فاصله زمانی دلخواه.
۲) اجرای کل خط لوله در «نزدیکی» پایگاه داده مزیت مهمی است.
pgai میتواند محتوا را از جدولها دریافت کند یا اسناد را از محلهایی مانند S3 بارگذاری کند و سپس آنها را تجزیه، قطعهبندی و تعبیه کند. همچنین میتواند قالبهای مختلف اسناد متنی مانند PDF، Markdown و موارد دیگر را پردازش کند.
۱) بخش زیادی از کنترل را از دست میدهید؛ درحالیکه RAG گاهی به کنترل نیاز دارد.
سامانههای RAG با عملکرد بالا—از نظر کیفیت پاسخ—اغلب به خط لولههای سفارشی نیاز دارند؛ از جمله:
قواعد سفارشی قطعهبندی بر اساس عنوانها، صفحهها، نوبت صحبت افراد و موارد دیگر
قطعهبندی آگاه از فراداده، با حفظ عنوان بخشها، برچسبهای زمانی، نویسندگان و نوع سند
راهبردهای تعبیهسازی متفاوت برای هر نوع سند
pgai برای موارد بالا انعطاف کمتری ارائه میدهد.
در حال حاضر دو راهبرد اصلی قطعهبندی وجود دارد: تقسیمکننده متن بر اساس نویسه و تقسیمکننده بازگشتی متن بر اساس نویسه؛ گزینه بدون قطعهبندی نیز در دسترس است. این قابلیتها شاید برای برخی کاربردها کافی باشند، اما بسیاری از سامانههای عملیاتی RAG به سفارشیسازی بیشتری نیاز دارند.
بسیار جذاب خواهد بود اگر Timescale بتواند برخی راهبردهای پیشرفتهتر قطعهبندی موجود در کتابخانههایی مانند Chonkie را اضافه کند و به همین ترتیب از طراحیهای پیشرفتهای مانند بازیابی زمینهمحور Anthropic پشتیبانی کند.
۲) متنمحور است، نه چندوجهی.
بسیاری از مسائل جذاب RAG دیگر صرفاً متنی نیستند:
فایلهای PDF دارای نمودار
تصاویر و نماگرفتها
ضبطهای صوتی
کلیپهای ویدئویی
حتی اگر بتوان از این منابع «متن استخراج کرد»، باز هم با یک خط لوله تعبیهسازی واقعاً چندوجهی یکسان نیست.
اگر pgai در آینده بهصورت سرتاسری از مدلهای چندوجهی پشتیبانی کند—بارگذاری ← قطعهبندی ← تعبیهسازی برای تصاویر بزرگ، صدا و ویدئوهای ذخیرهشده در S3، همراه با همگامسازی مطمئن—بسیار جذاب خواهد بود؛ اما امروز فقط یک گردشکار تعبیهسازی متن است.
۳) اگر فقط به تعبیهها نیاز دارید، شاید به pgai نیازی نداشته باشید.
اگر خط لوله دریافت داده شما از قبل سفارشی است یا باید سفارشی باشد، «تعبیهسازی قطعههای متن» دشوارترین بخش RAG نیست. در چنین شرایطی، pgai سادهترین بخش مسئله را حل میکند.
همچنین اگر پایگاه دانش شما بهندرت بهروزرسانی میشود، همگامسازی خودکار تعبیهها ارزش چندانی ندارد.
یکی از کاربردهای بسیار مناسب pgai، راهاندازی رابط تبدیل متن به SQL روی پایگاههای داده است. این کار با ماژول semantic_catalog ارائهشده در pgai بهسادگی امکانپذیر است. کافی است آن را به این شکل راهاندازی کنید:
Bash
سپس با دستور pgai semantic-catalog create از کاتالوگ معنایی بخواهید واژهنامههای داده شما را واکشی کند. با این کار، از مخزن داده شما زمینهای تولید میشود که تقریباً چنین شکلی دارد:
Plain Text
اکنون pgai به چند روش میتواند از این زمینه استفاده کند:
از طریق جستوجوی معنایی:
این پرسوجو جدولها، توابع و اشیای دیگری را برمیگرداند که ممکن است با پرسوجوی زبان طبیعی شما مرتبط باشند:
Bash
دریافت زمینه خام:
این دستور، زمینه خام YAML مرتبط با پرسوجوی زبان طبیعی شما را نمایش میدهد:
Bash
تولید SQL:
همچنین میتوانید SQL خام موردنیاز برای پاسخ به پرسوجوی خود را مستقیماً تولید کنید. زمینه مرحله قبل به یک الگوی زبانی بزرگ (LLM) ارسال و پاسخ تولید میشود:
Bash
اگر یک سامانه RAG نسبتاً ساده میسازید، در صورت نیاز به موارد زیر، pgai ارزش امتحانکردن دارد:
استفاده از Postgres بهعنوان مرجع اصلی دادهها،
حداقل کد واسط،
تعبیههایی که خودکار همگام میمانند،
راهی سریع برای افزودن قابلیت تبدیل متن به SQL به پایگاههای داده،
آزمایش ابزارهای جدید RAG و افزونههای Postgres.
اگر خط لوله RAG شما به هر یک از موارد زیر نیاز دارد، احتمالاً بهتر است فعلاً برای استفاده از pgai صبر کنید:
منطق بسیار سفارشی برای دریافت یا قطعهبندی دادهها
انواع متعدد اسناد با نیازهای تجزیه متفاوت
تعبیههای چندوجهی
در پایان، هرچند روشن است که pgvector با استقبال گستردهای روبهرو شده، مشخص نیست pgai نیز به همان اندازه توجه و در نتیجه پشتیبانی جلب کند؛ البته از عرضه آن فقط حدود ۱۸ ماه میگذرد.
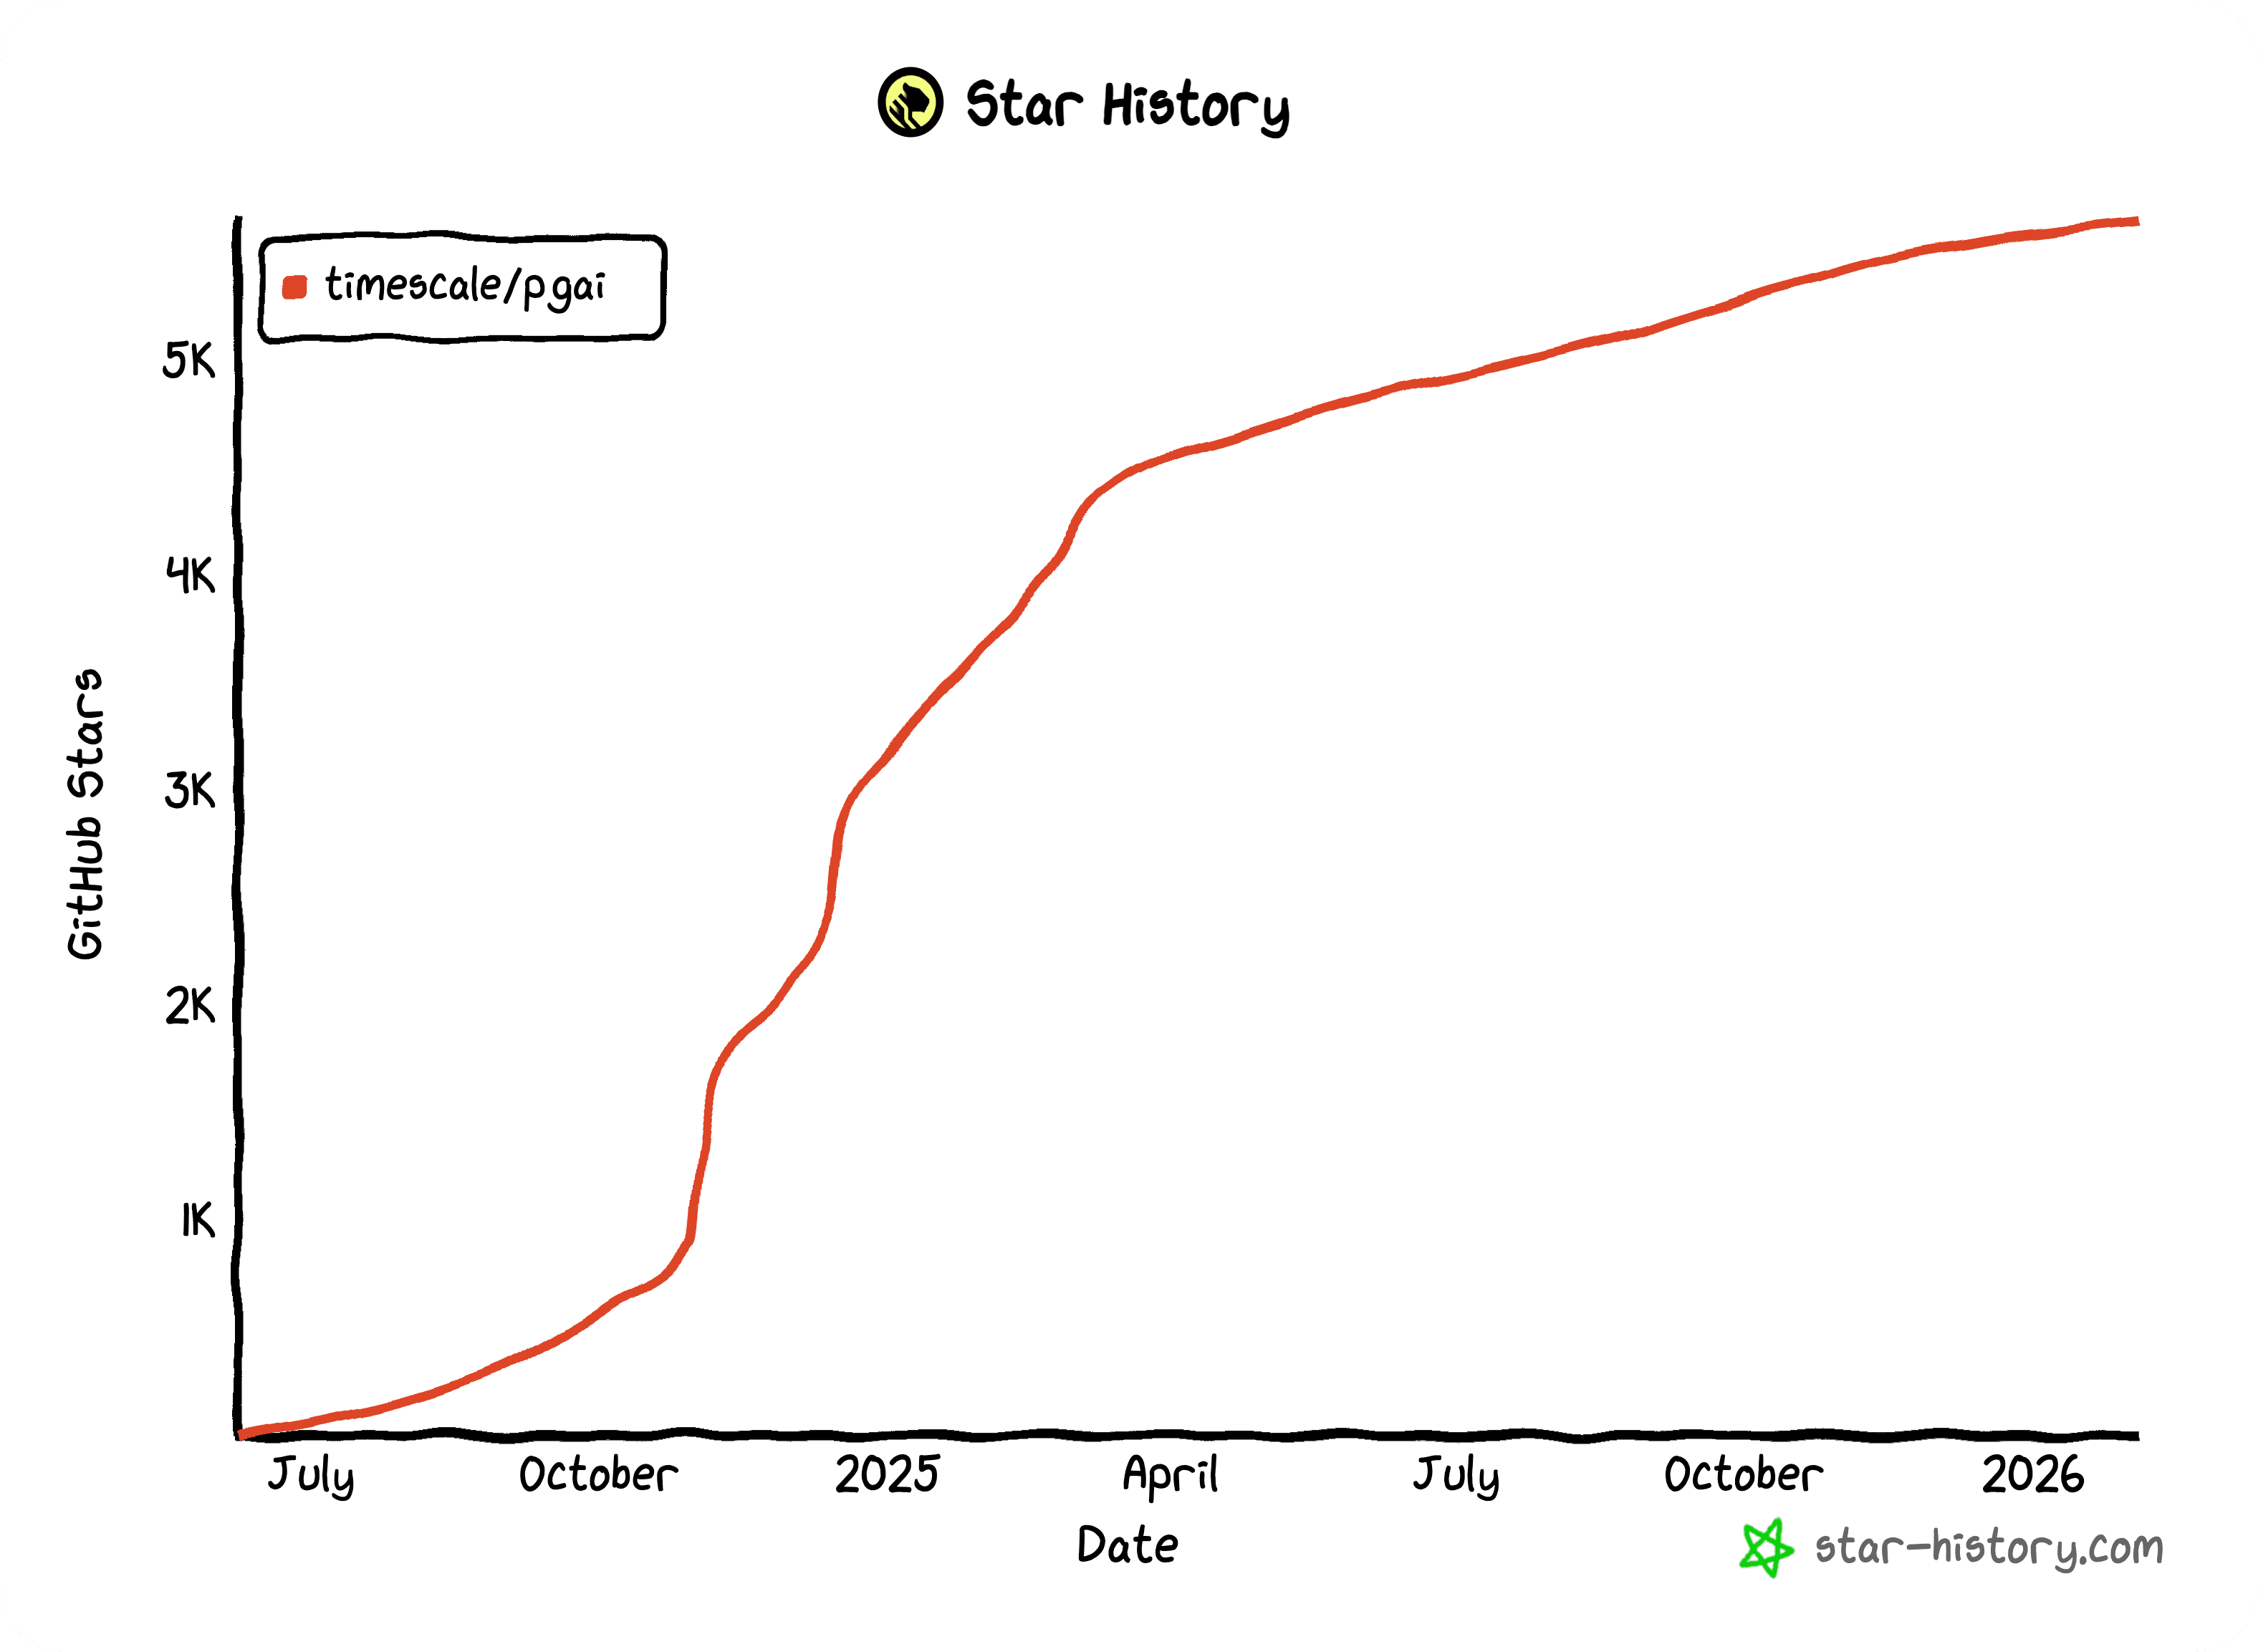
pgai رویکرد جالبی به RAG است که بخش بیشتری از کارهای عملیاتی روزمره را به پایگاه داده میسپارد تا کد برنامه سادهتر شود.
در حال حاضر، این ابزار:
برای پیکربندیهای ساده RAG کاربردی و واقعاً خوشایند است
برای خط لولههای سفارشیتر، بهویژه انواع چندوجهی، انعطاف کافی ندارد
این پروژه امیدوارکننده است و قطعاً ارزش دارد روند پیشرفت آن را دنبال کنیم.