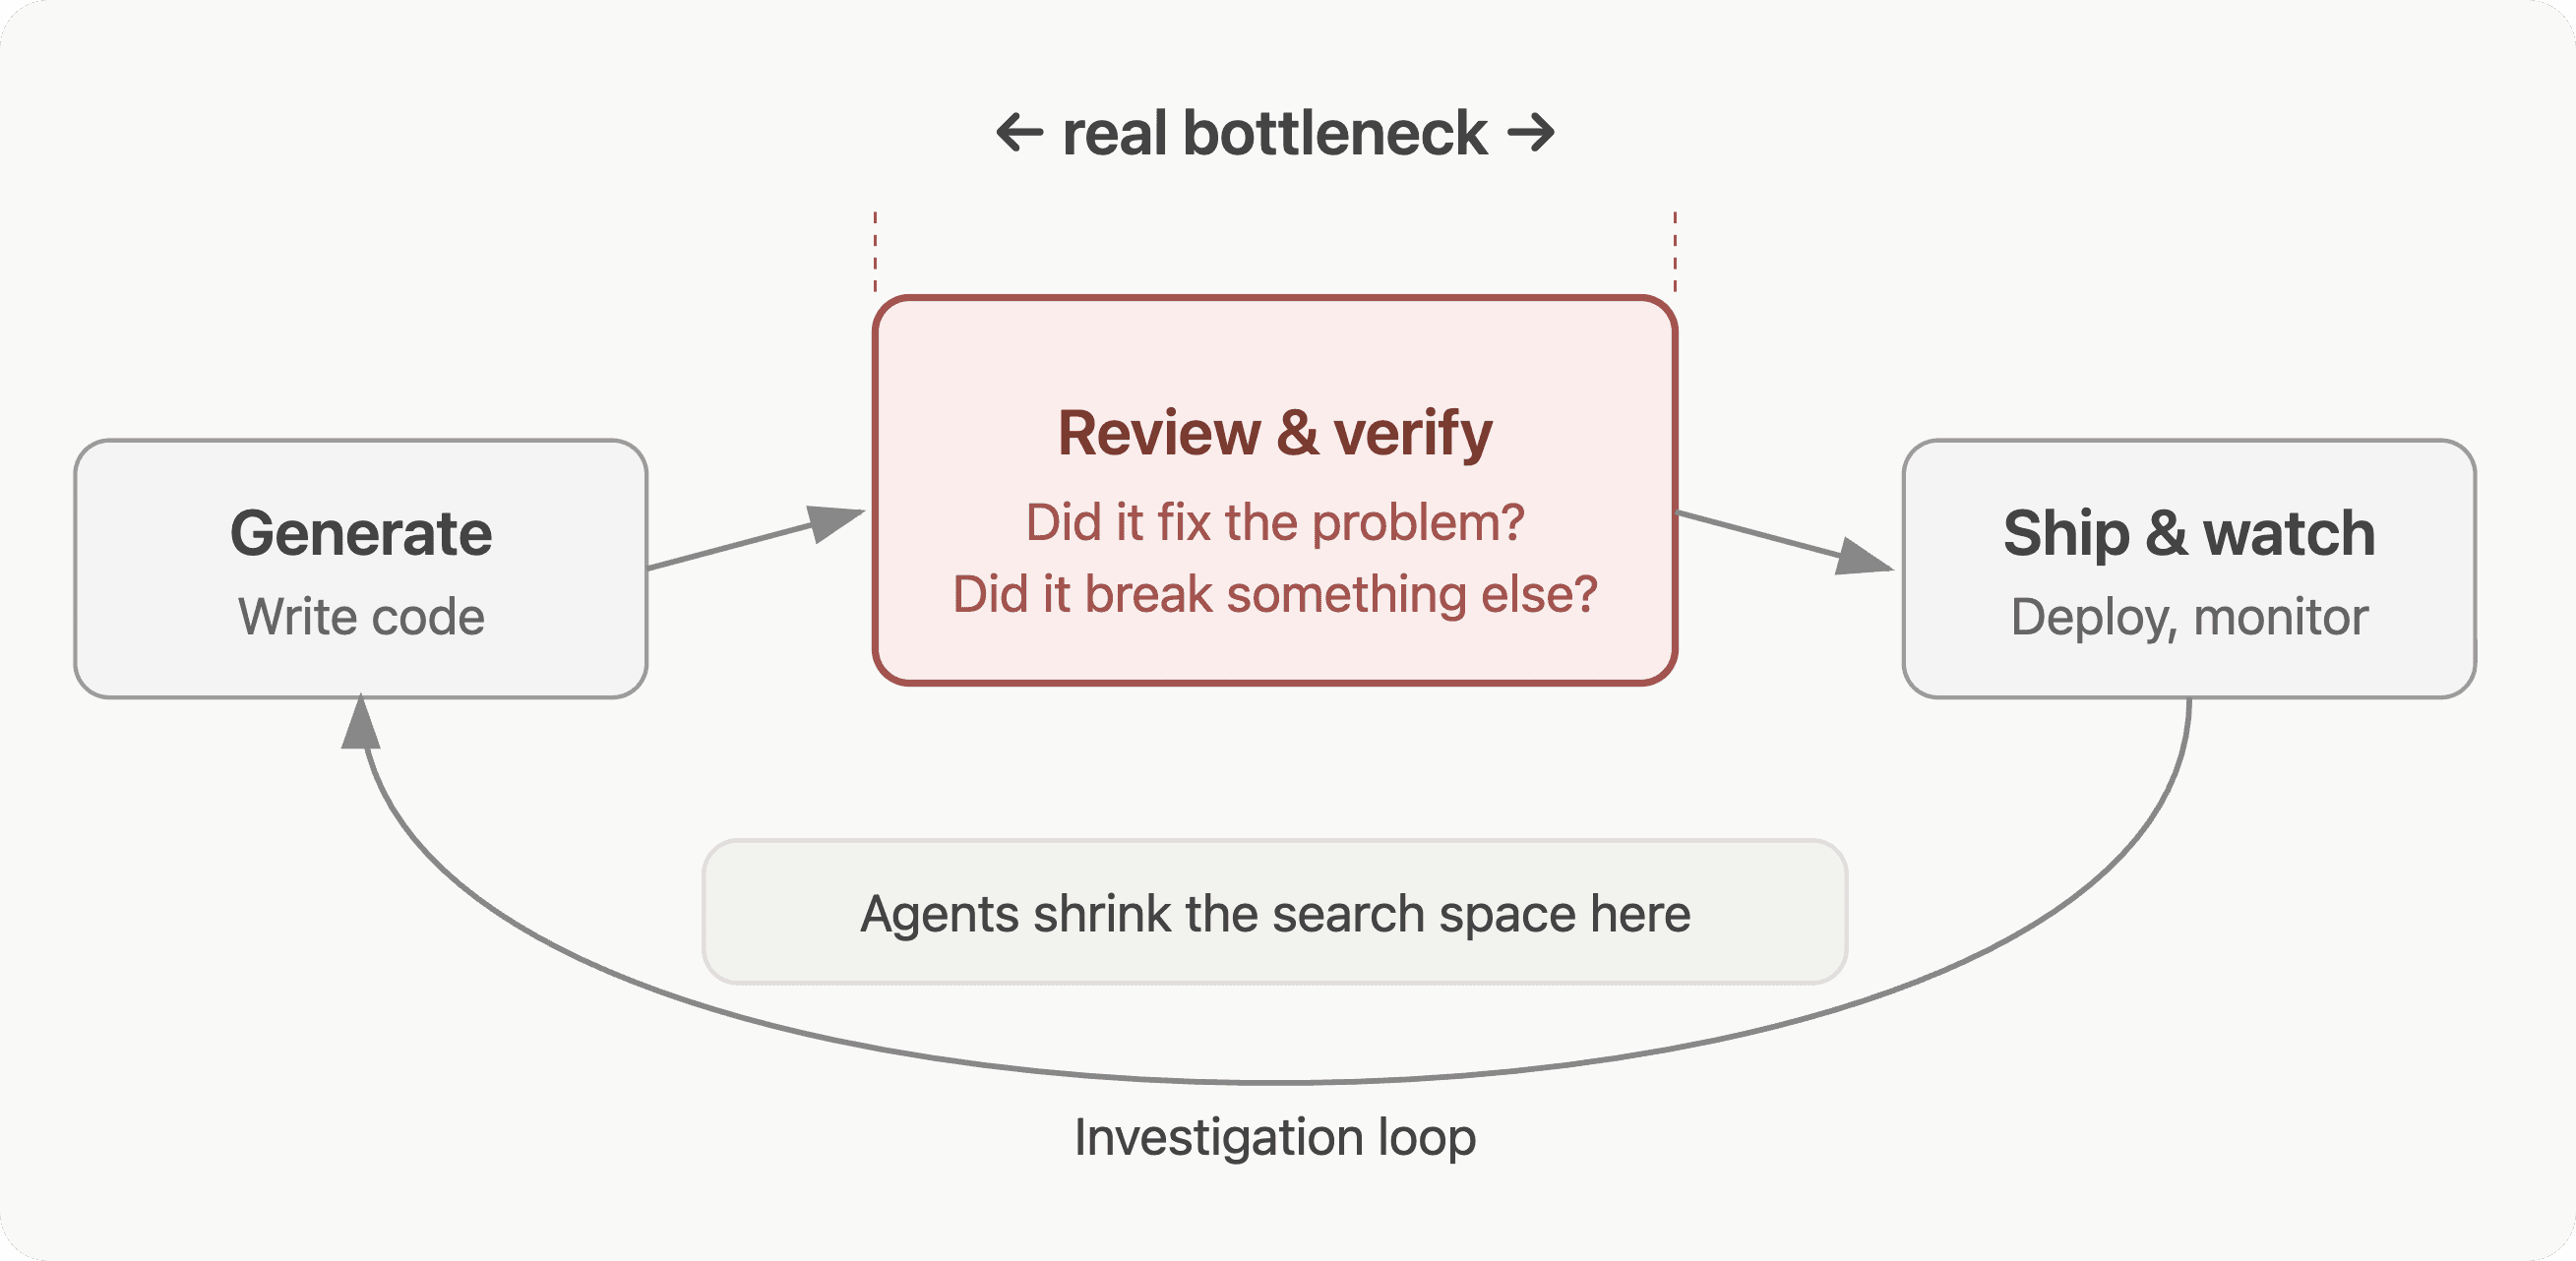
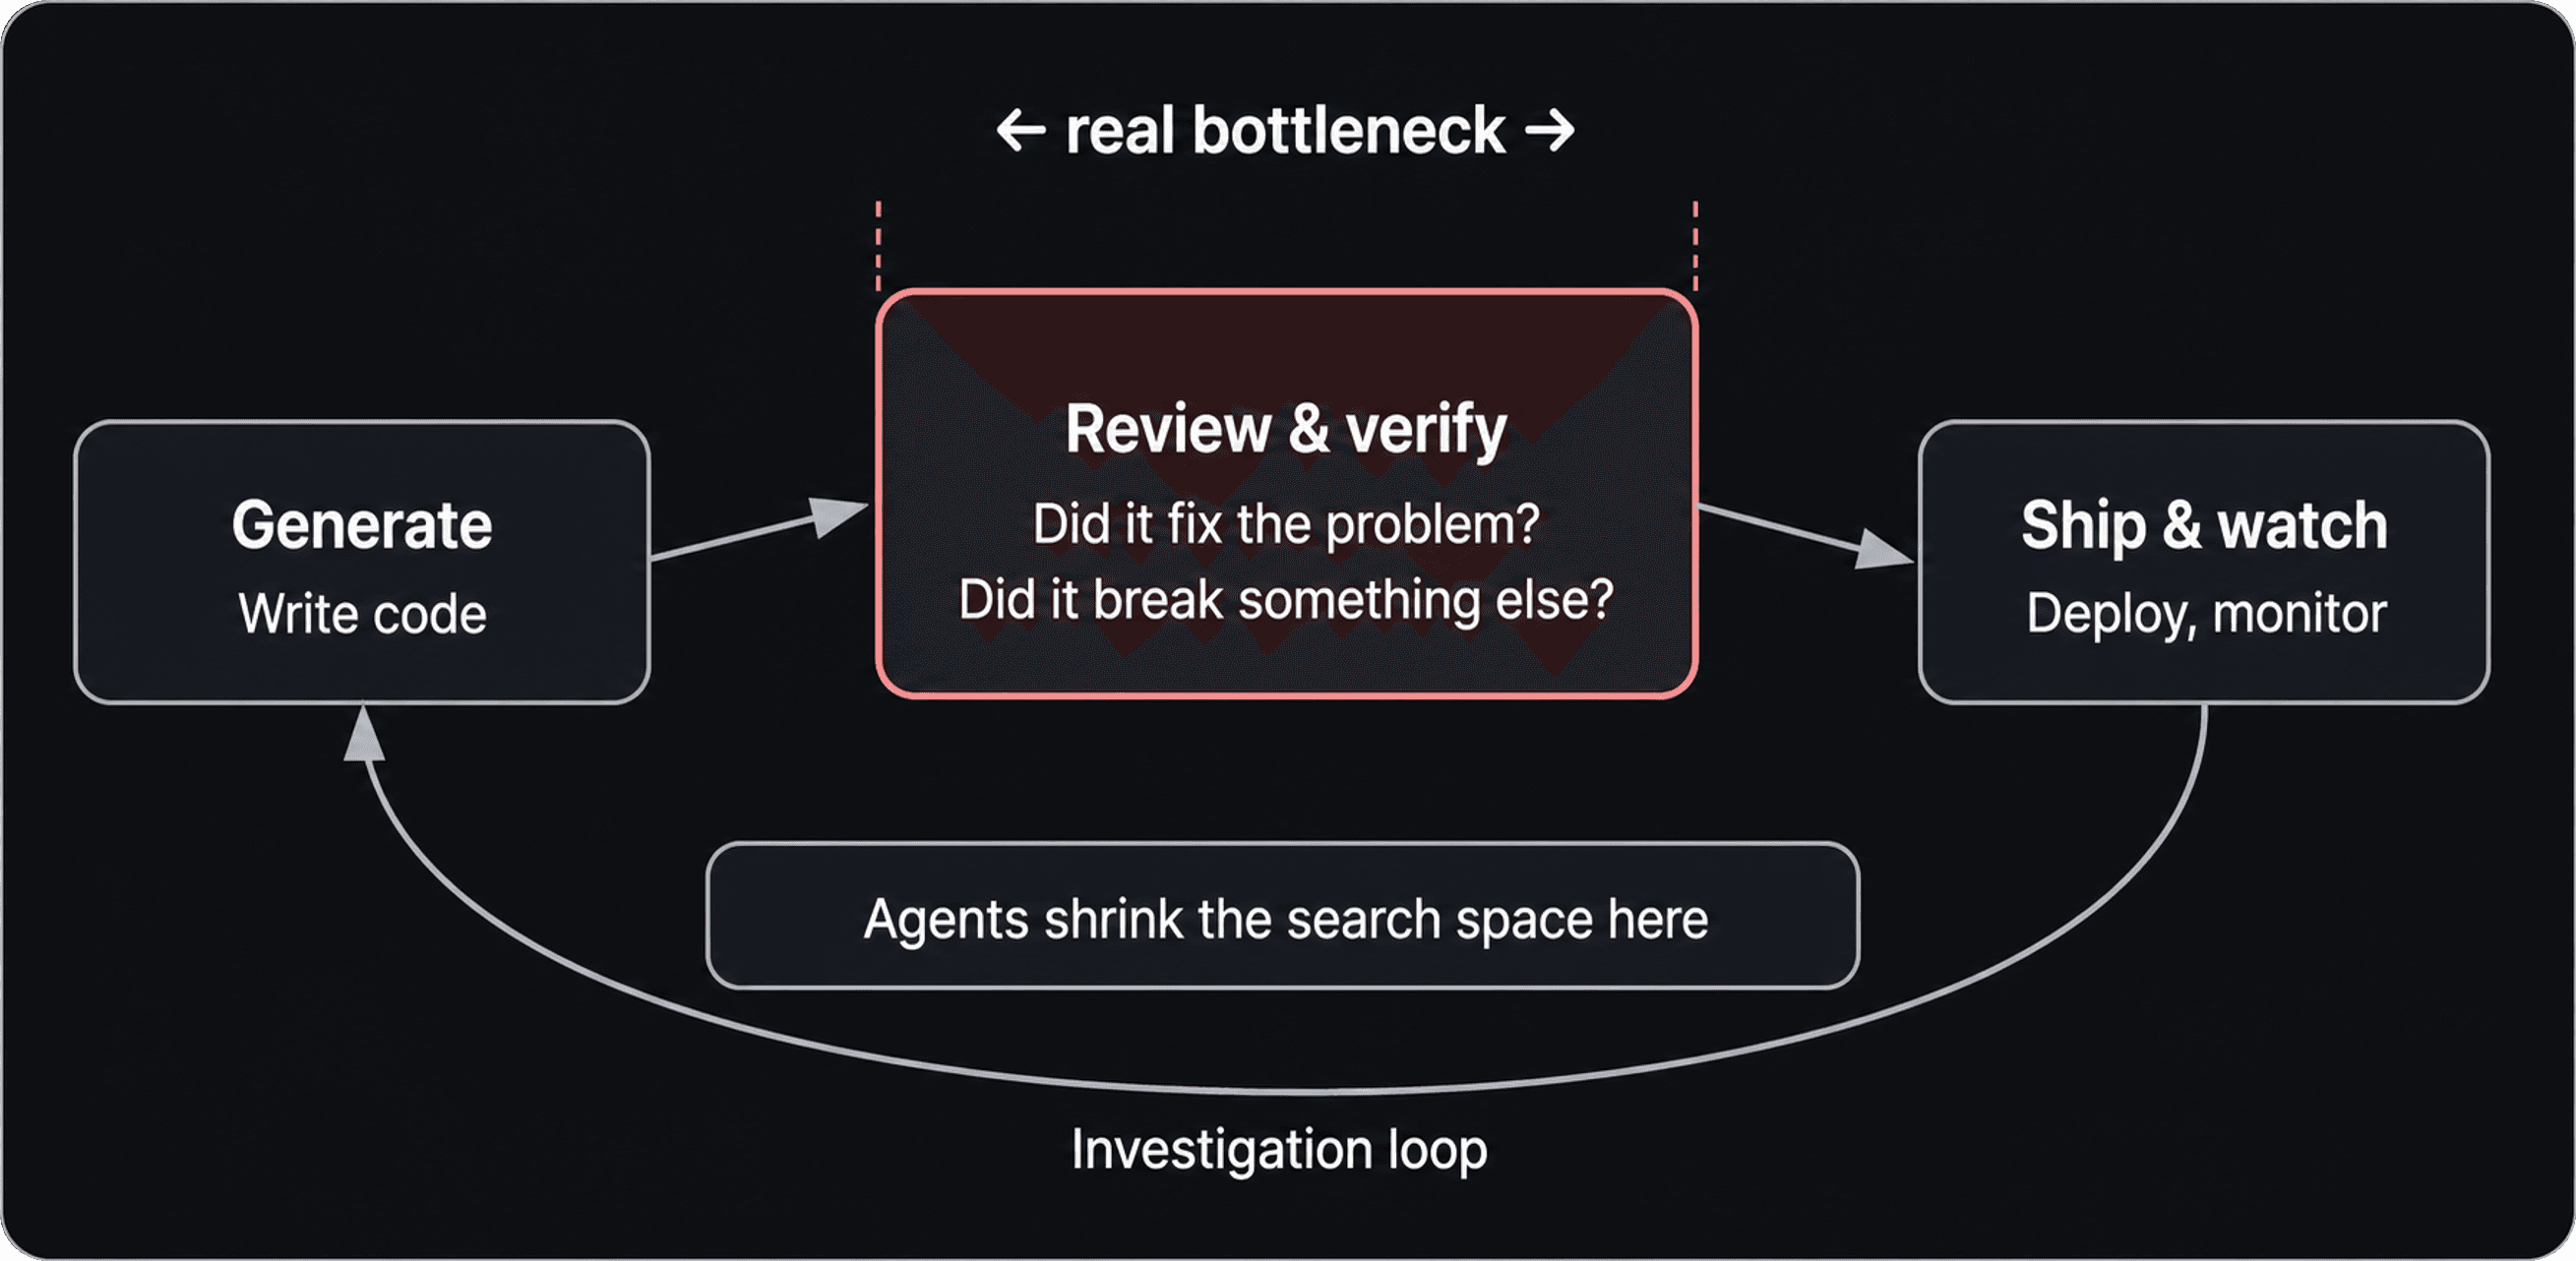
У більшості команд, що впроваджують автономну розробку коду, вузьке місце зміщується з генерації на перевірку, а без удосконалення цього циклу чистий приріст швидкості майже нульовий.
У масштабних середовищах CI — із мільйонами нічних тестів і сотнями інженерів — найцінніше завдання для агента полягає у визначенні відповідальних і первинному аналізі, а не в генерації коду.
Корисний результат роботи агента витримує ретельну перевірку й пояснює причинно-наслідкові зв’язки, а не лише виявлені закономірності.
Проєктування рівня збирання доказів і формування контексту важливіше за рівень генерації.
Більшість розмов про автономну розробку коду досі починаються з простої обіцянки: писати більше коду й робити це швидше.
Іноді ця обіцянка переростає в амбітніше бачення: агенти планують роботу, відкривають PR і випускають зміни з мінімальним втручанням людини. Проте для більшості інженерних команд найочевидніша короткострокова цінність має вужчі межі. Йдеться про зниження витрат на ітерації.
Розробка й постачання програмного забезпечення — це не лише генерація коду. Написання коду — лише один етап тривалішого циклу, що охоплює перевірку, тестування, розгортання та розслідування проблем. Більшість команд, які впроваджують автономну розробку коду, не перебудовуючи цикл перевірки, лише переміщують вузьке місце на наступні етапи.
Саме лише прискорення генерації не робить команду автоматично швидшою. Воно може лише збільшити обсяг роботи, пов’язаної з перевіркою, підтвердженням правильності та формуванням довіри.
У багатьох інженерних середовищах найдорожче — не створити першу версію, а досягти впевненості в її правильності.
Чи справді зміна усунула проблему або поліпшила систему? Чи не спричинила вона регресію деінде? Джерело збою — у коді, середовищі, тестах чи залежності? Запропоноване виправлення усуває причину чи лише видимий симптом?
Саме тут можуть допомогти агенти — не тому, що вони замінюють інженерів, а тому, що здатні провести структурований первинний аналіз неупорядкованих даних: переглянути журнали, зіставити останні зміни, узагальнити важливі сигнали, простежити ймовірні причини, виконати перевірки та надати результат, який людина може критично дослідити.
У багатьох командах найефективніше застосування агента — не генерація коду з нуля. Його цінність у тому, щоб звузити простір пошуку проблеми, перш ніж людина витратить години на це вручну.
Це особливо помітно в масштабних процесах налагодження. Уявіть, що нічна CI запускає мільйони тестів у кодових базах, над якими працюють сотні інженерів. Для одного з наших клієнтів це реальність. Коли щось дає збій, визначити відповідальну команду непросто. Проблема може бути в коді застосунку, залежності, системі harness для тестування або іншій частині технологічного стека. Обсяг журналів може сягати гігабайтів, а команда, яка першою помітила проблему, не завжди відповідає за неї.
Такий процес не передбачає, що один агент має самостійно написати виправлення. Він потребує системи, яка швидко звужує простір пошуку проблеми.
Ефективний конвеєр може отримувати журнали, відбирати релевантні дані, узагальнювати найважливіше, перевіряти код у пісочниці та створювати структурований аналіз першопричини з оцінкою впевненості, можливістю простежити висновки й рекомендаціями щодо подальших дій. Щоб сформувати оцінку впевненості, профільний фахівець оцінює початковий результат роботи агента. Потім ці дані передають моделі LLM у ролі судді, щоб надалі автоматизувати оцінювання, зберігаючи узгодженість із судженням людини.
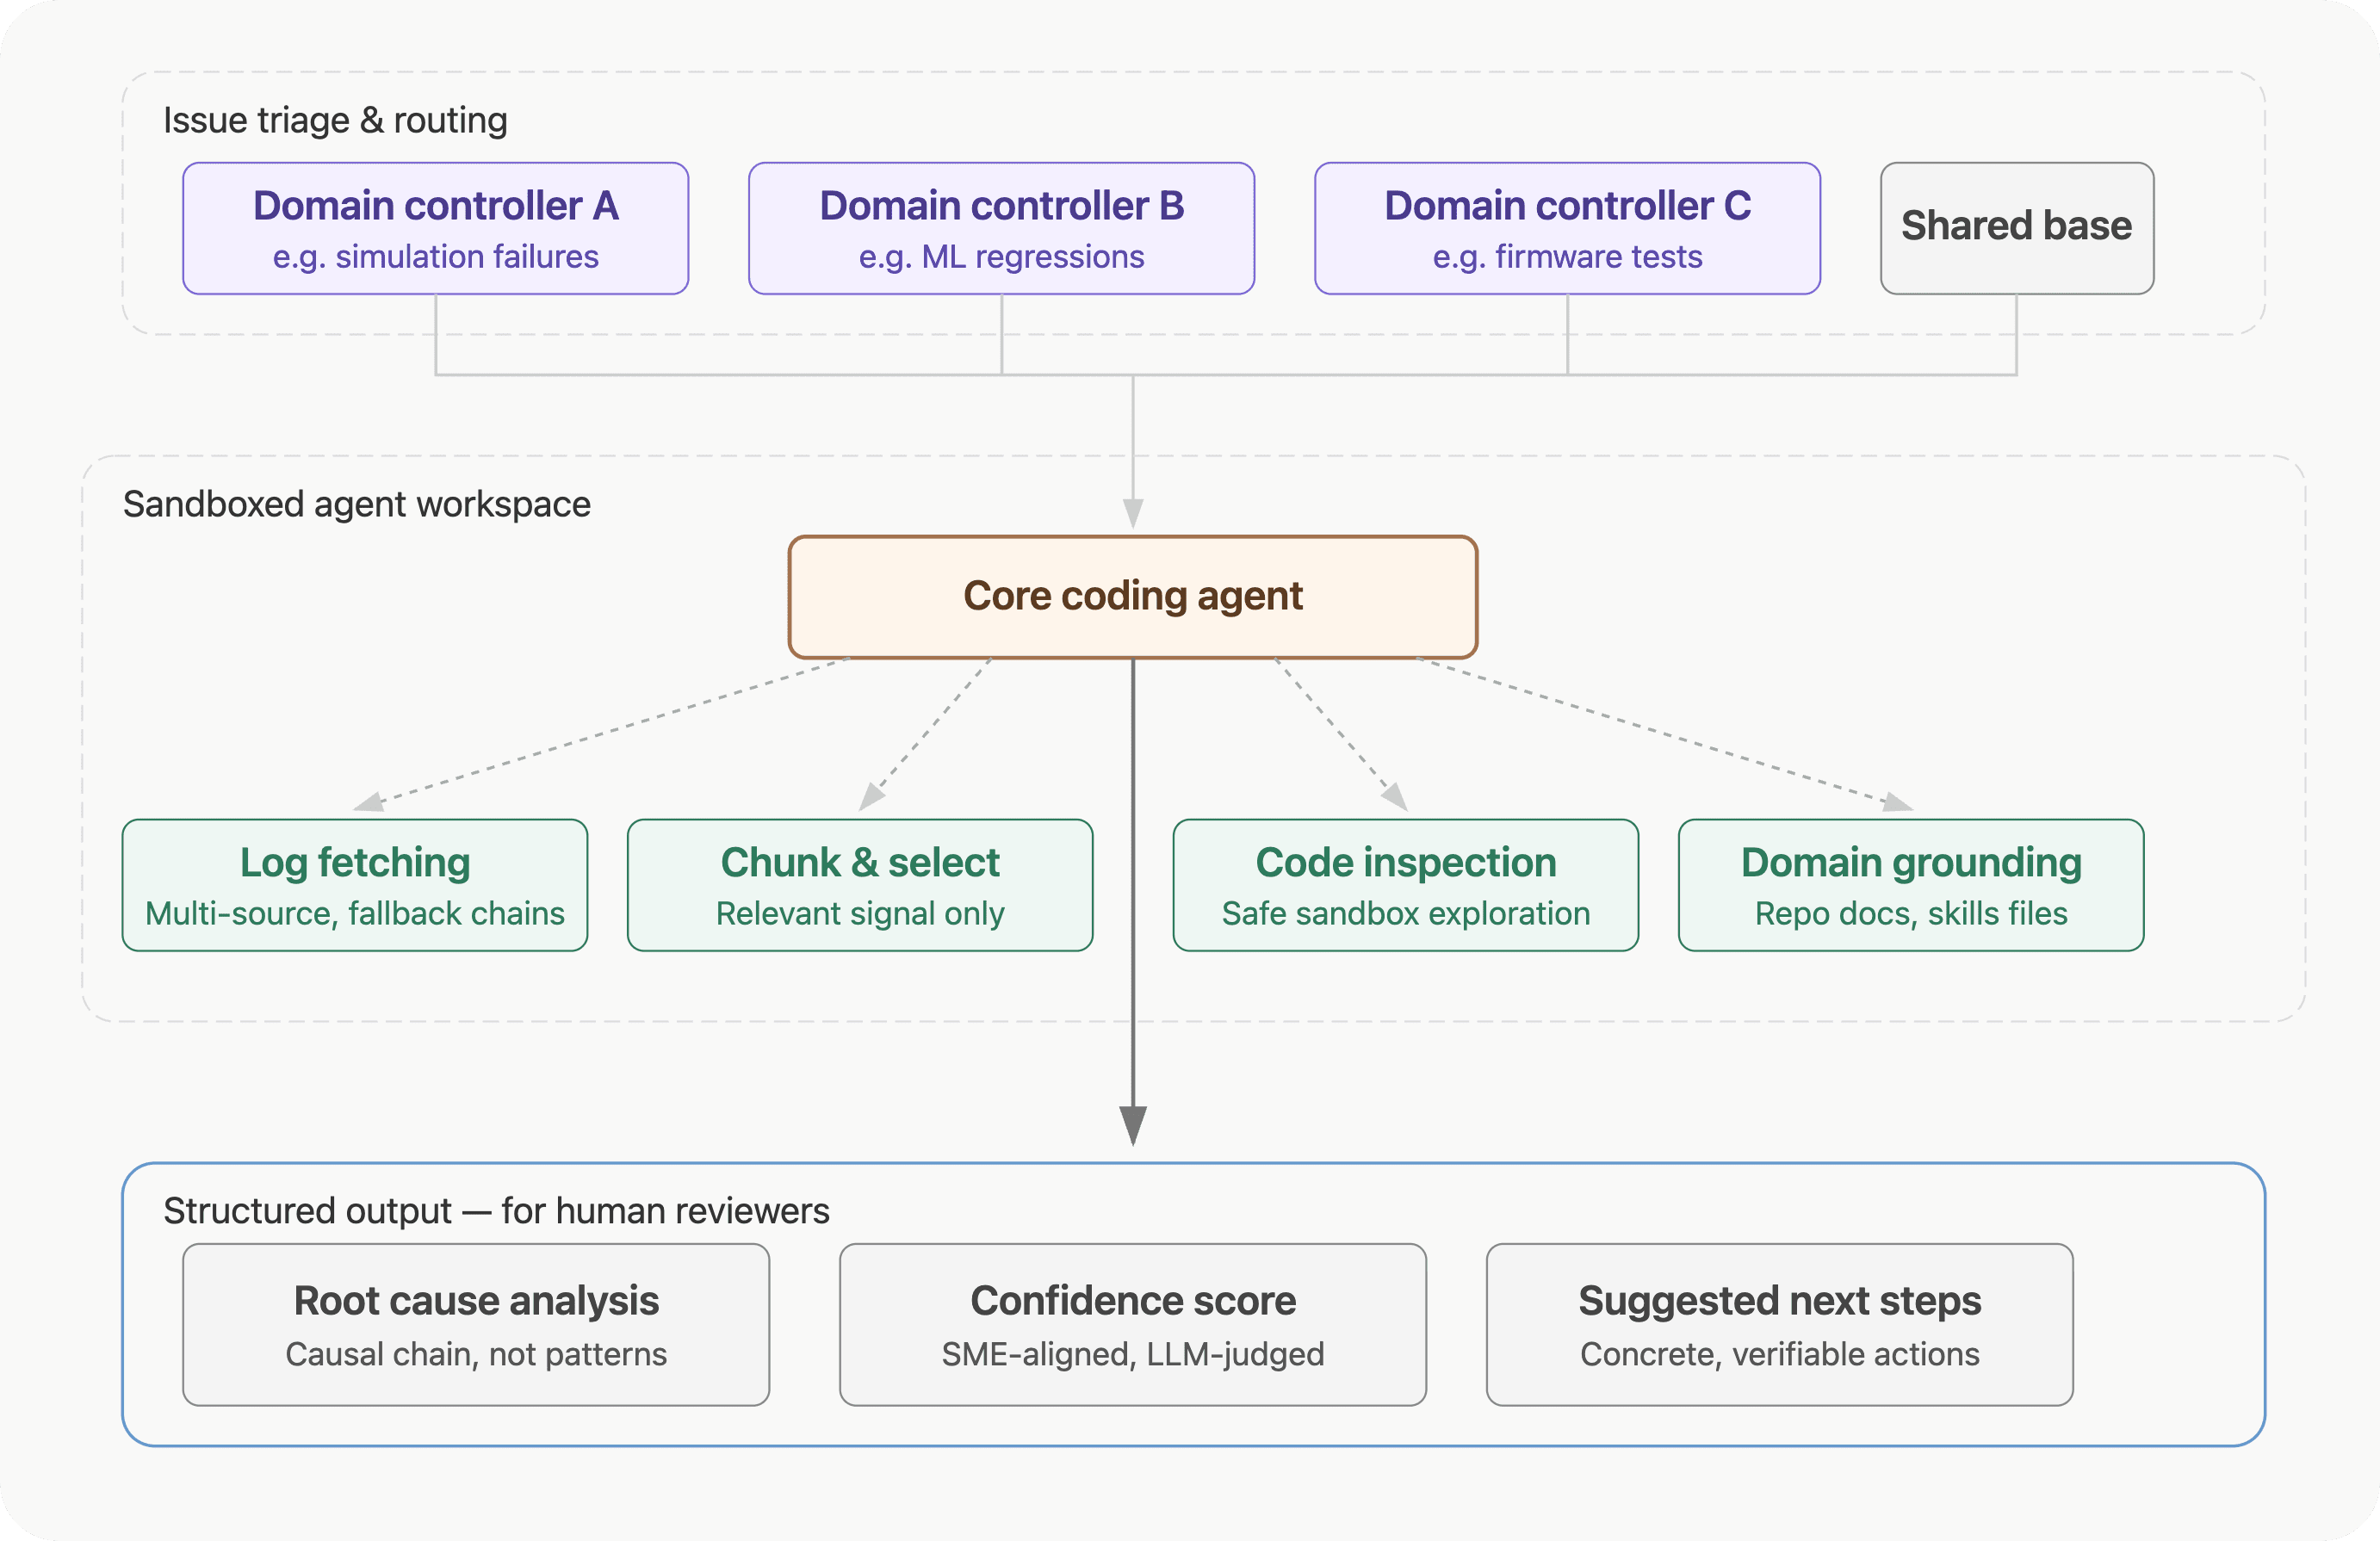
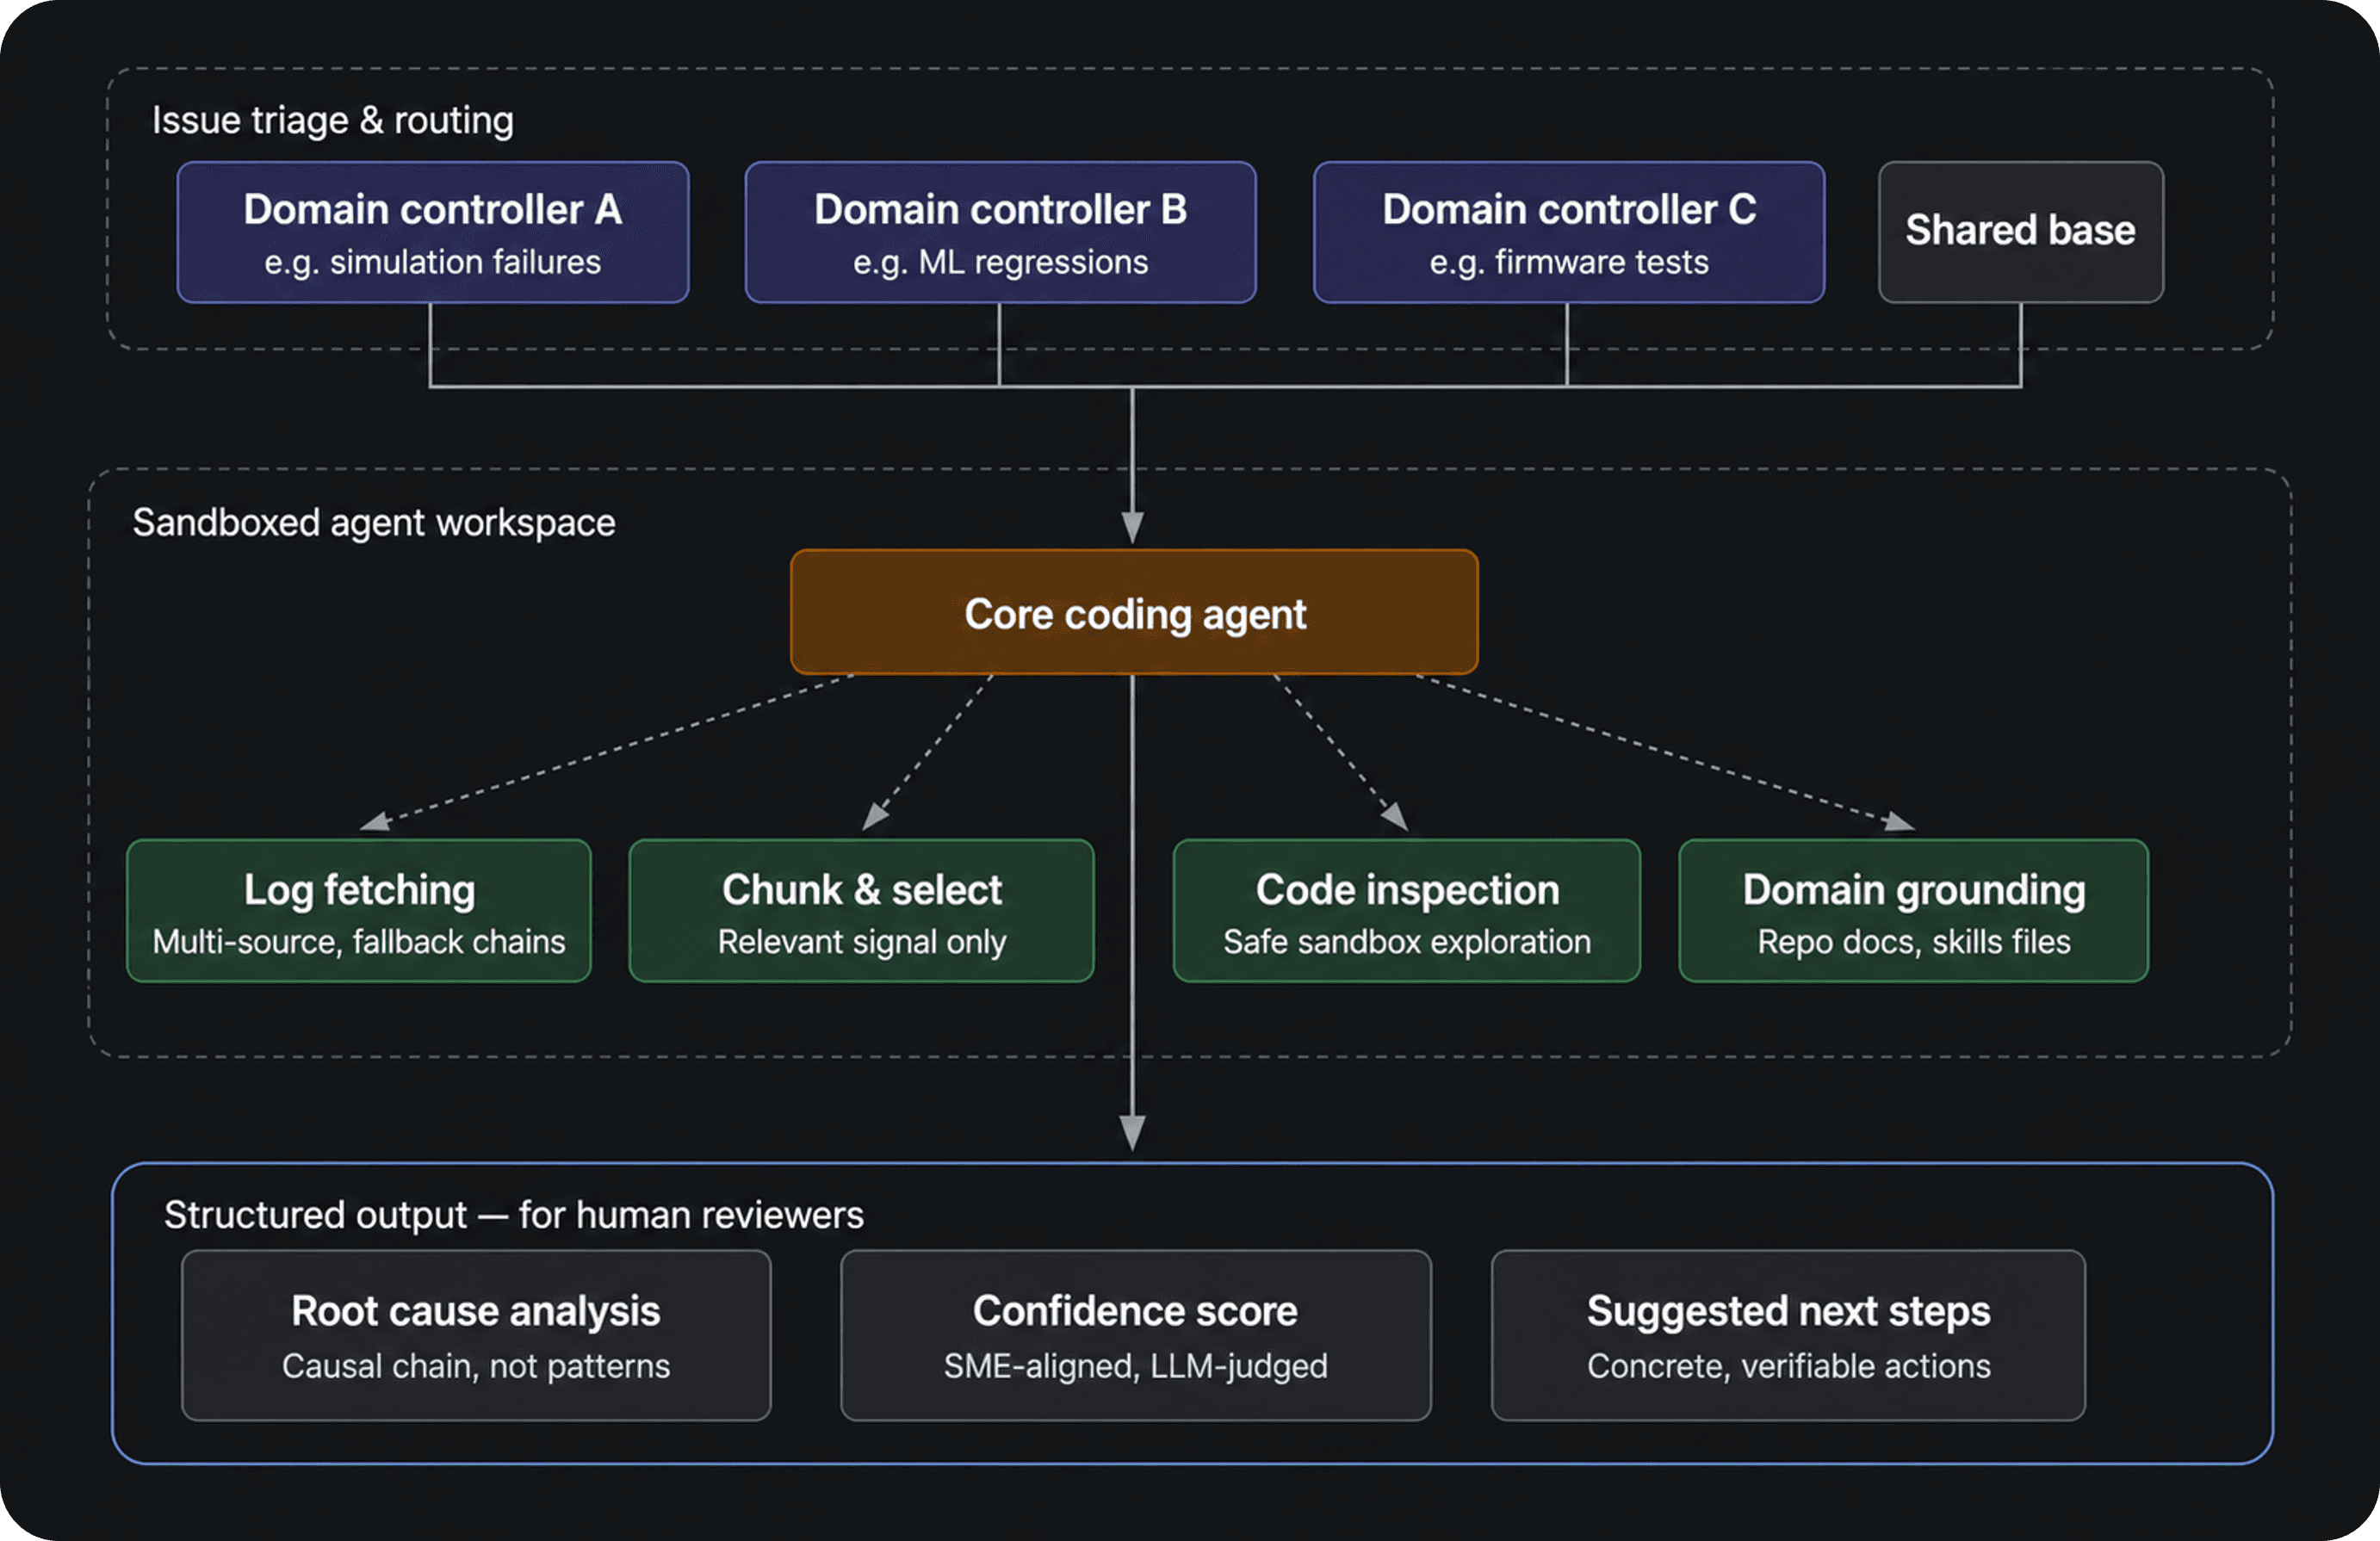
Мета не в тому, щоб усунути інженерне судження, а в тому, щоб дати рецензентам кращу відправну точку. Первинний аналіз регресій, перевірка PR, виправлення тестів, валідація випусків і розслідування після розгортання мають спільну структуру. Усі вони потребують аналізу великого обсягу даних і ретельної перевірки та сповнені неоднозначності. Вони не вимагають від агента замінити інженерний процес — лише допомогти просувати його вперед.
Саме тому командам також слід обережно підходити до оцінювання таких систем.
Неправильно запитувати, чи здатен агент самостійно створити щось вражаюче. Краще запитати, чи вдосконалює він реальний робочий процес, не створюючи перешкод деінде.
Тобто потрібно оцінювати, чи достатньо конкретний результат для перевірки, чи пояснює він причинно-наслідкові зв’язки, а не лише зіставляє закономірності, і чи справді полегшує перевірку. Правдоподібна відповідь — не те саме, що корисна. На практиці команди довіряють результатам роботи агента, коли ті витримують ретельний аналіз і містять конкретні твердження, які можна перевірити.
Глибший висновок полягає в тому, що ефективним агентним системам недостатньо самої генерації. Їхня ефективність залежить від того, як збираються докази, формується контекст, перевіряються результати та як рецензенту повідомляють про невизначеність.
Саме тому найближче майбутнє агентної інженерії навряд чи стане одним великим стрибком до повної автономності. Найімовірніше, це буде набір ретельно спроєктованих циклів, у яких агенти допомагатимуть командам аналізувати, перевіряти, підтверджувати й удосконалювати свою роботу, скорочуючи марні витрати зусиль між етапами.
Це може звучати менш вражаюче, ніж загальна концепція автономності, але набагато точніше відповідає тому, як насправді впроваджують корисні системи.