Nella maggior parte dei team che adotta il coding agentico, il collo di bottiglia passa dalla generazione alla revisione: senza migliorare questo ciclo, l'aumento netto di velocità è quasi nullo.
Negli ambienti CI su larga scala, con milioni di test notturni e centinaia di ingegneri, il compito più utile per un agente è individuare il team responsabile e gestire il triage, non generare codice.
L'output utile di un agente resiste a un esame approfondito e spiega i nessi causali, anziché limitarsi a individuare schemi ricorrenti.
Progettare il livello di raccolta delle evidenze e costruzione del contesto conta più del livello di generazione.
Gran parte del dibattito sul coding agentico parte ancora da una semplice promessa: scrivere più codice, più velocemente.
A volte questa promessa si amplia in una visione più ambiziosa, in cui gli agenti pianificano il lavoro, aprono PR e rilasciano modifiche con un intervento umano minimo. Per la maggior parte dei team di ingegneria, tuttavia, il vantaggio più evidente nel breve termine è più circoscritto. Consiste nel ridurre il costo delle iterazioni.
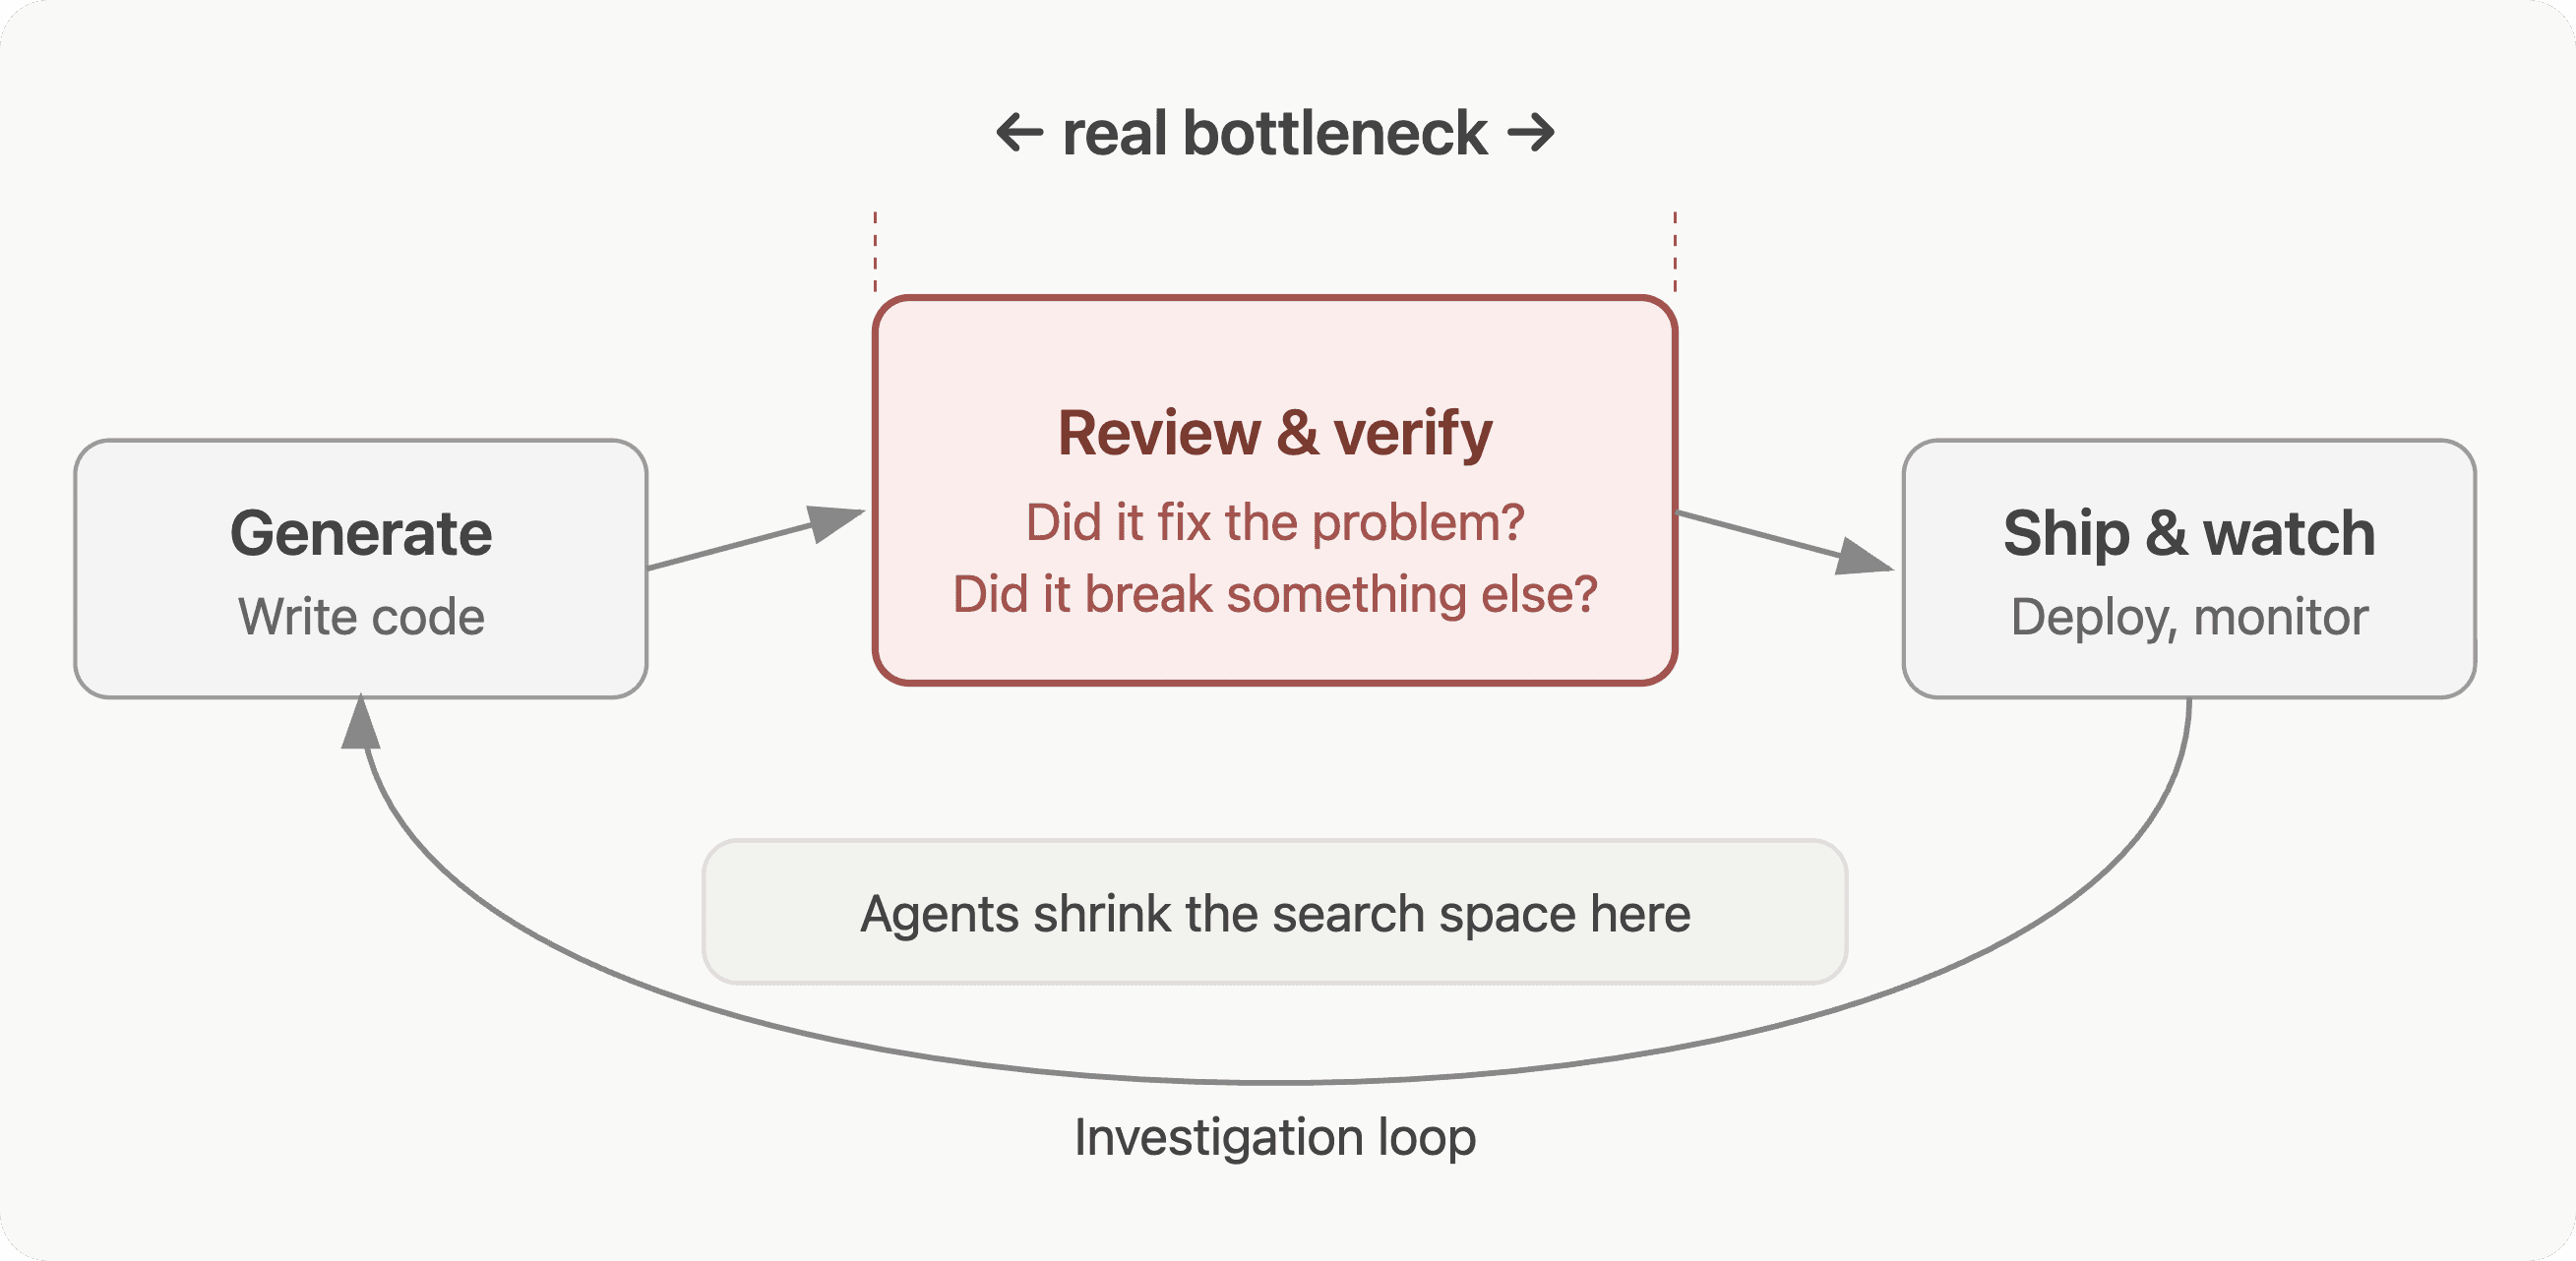
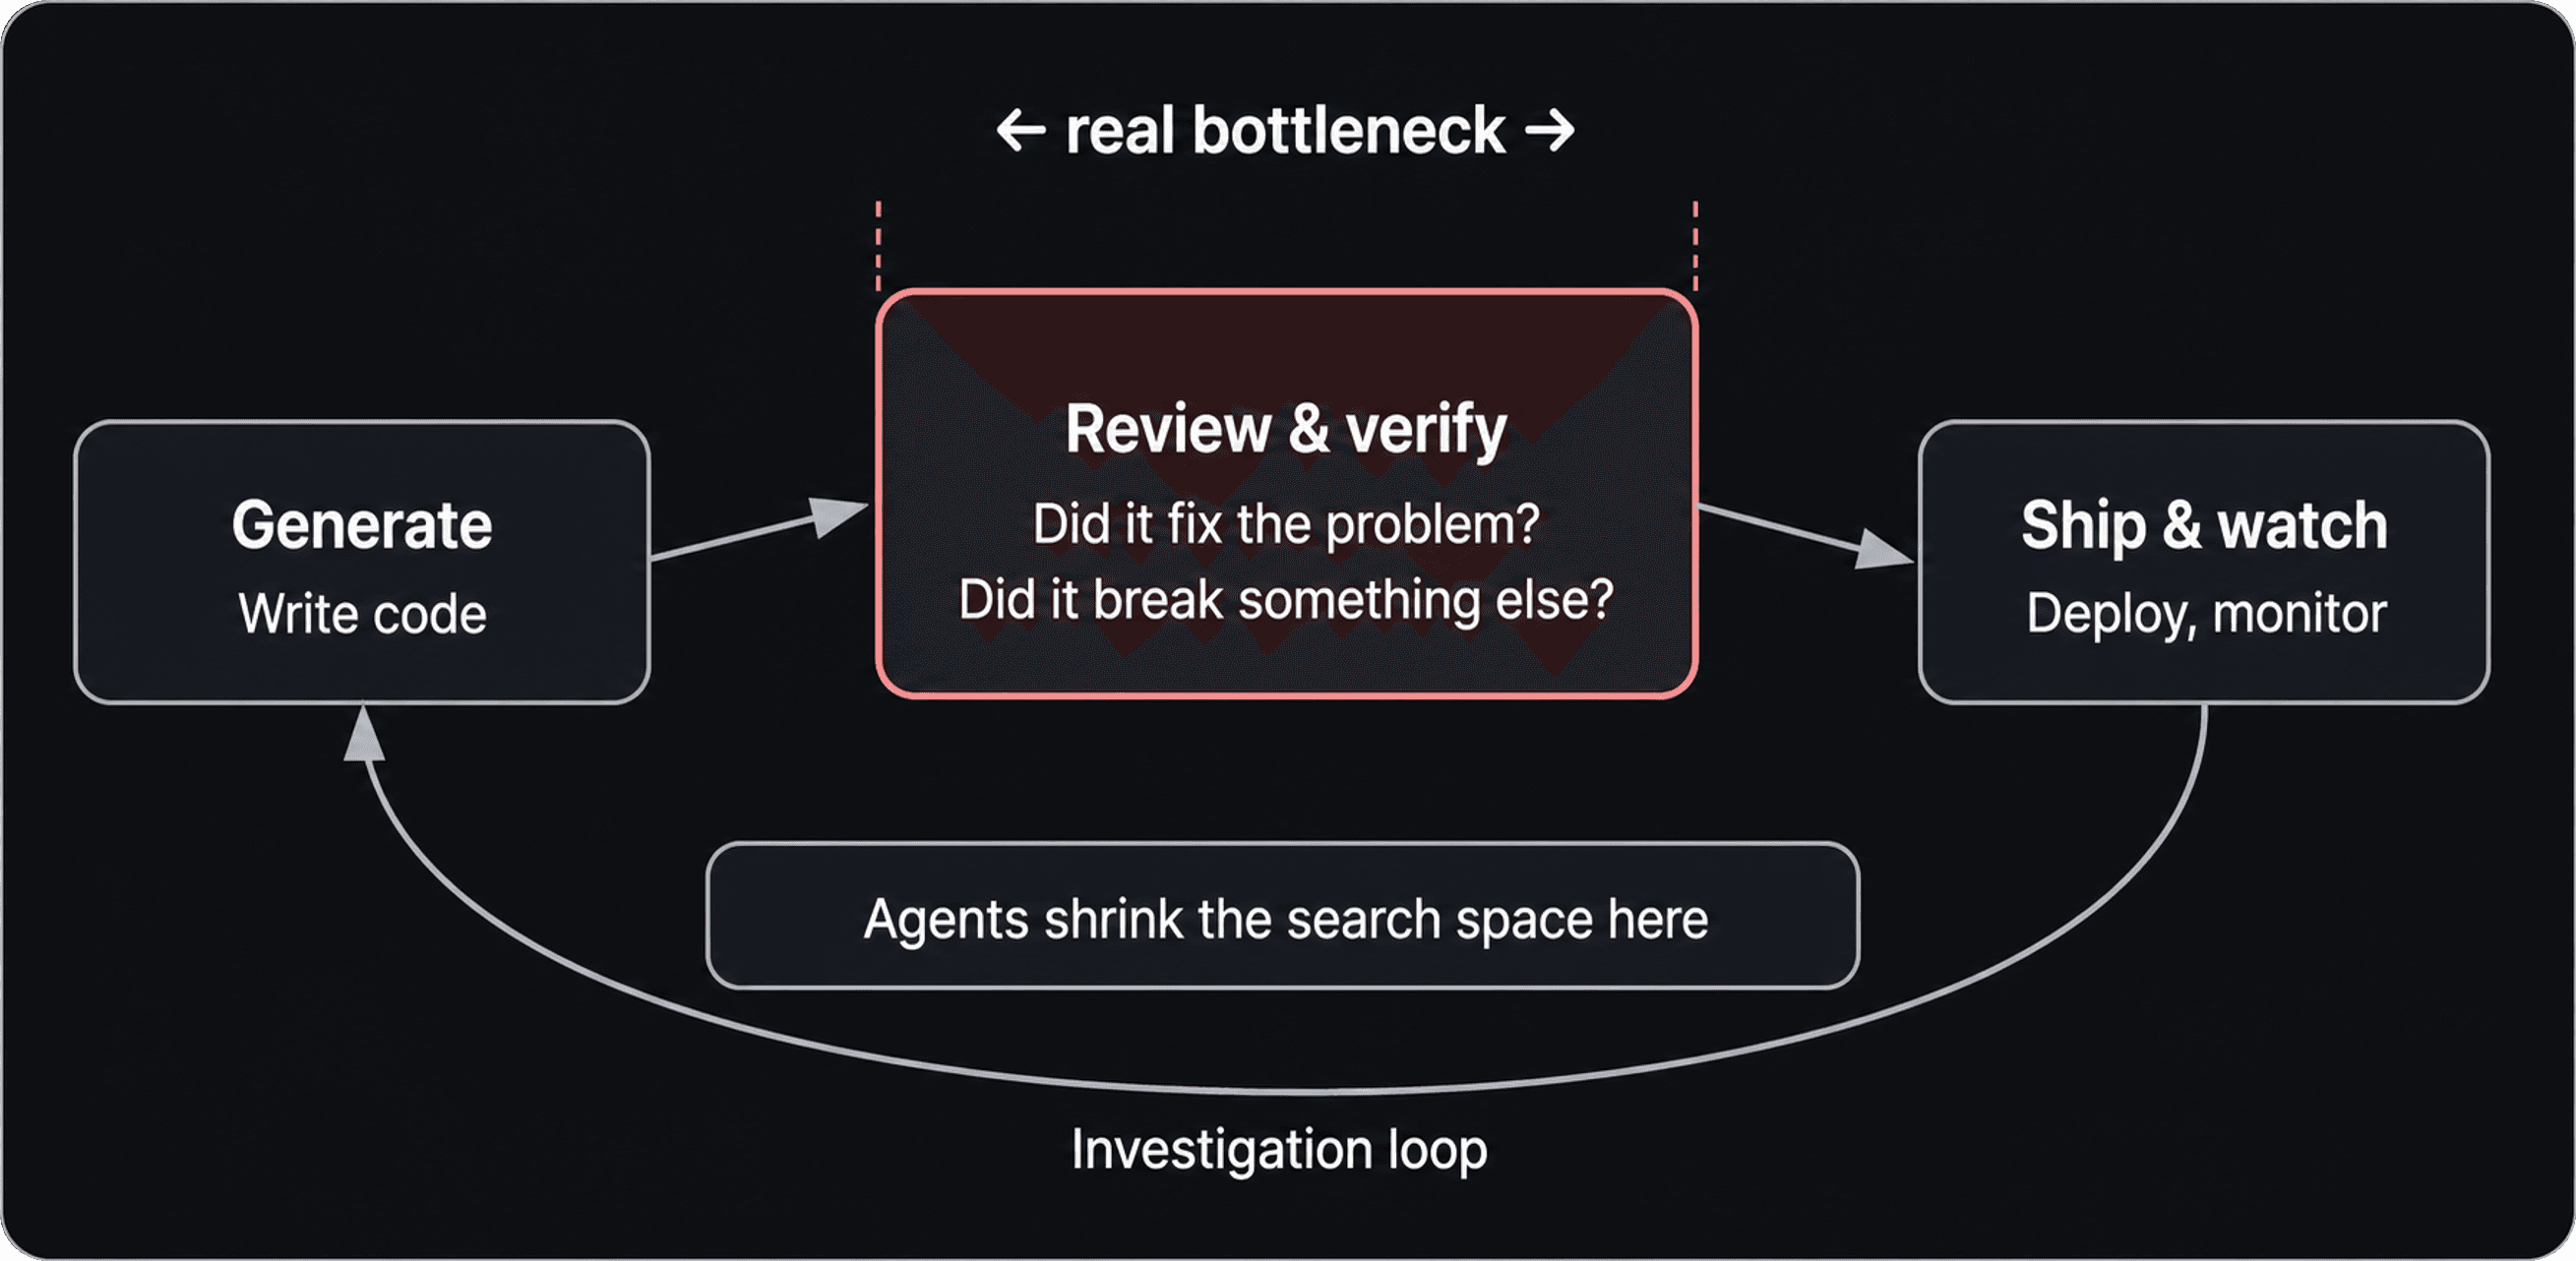
La distribuzione del software non si riduce alla generazione del codice. Scrivere codice è solo una fase di un ciclo più lungo, che comprende revisione, test, distribuzione e analisi dei problemi quando qualcosa va storto. La maggior parte dei team che adotta il coding agentico senza riprogettare il ciclo di revisione si limita a spostare il collo di bottiglia più a valle.
Accelerare soltanto la generazione non rende automaticamente più veloce un team. Può semplicemente trasferire più lavoro alla revisione, alla verifica e alla valutazione dell'affidabilità.
In molti contesti di ingegneria, la parte più costosa non è produrre una prima bozza, ma acquisire sufficiente fiducia nel risultato.
La modifica ha davvero risolto il problema o migliorato il sistema? Ha introdotto una regressione altrove? L'errore è nel codice, nell'ambiente, nei test o in una dipendenza? La correzione proposta affronta la causa o soltanto il sintomo visibile?
Gli agenti possono essere d'aiuto non perché sostituiscano gli ingegneri, ma perché possono eseguire una prima analisi strutturata di evidenze disordinate: esaminare i log, confrontare le modifiche recenti, riepilogare i segnali pertinenti, risalire alle cause probabili, eseguire controlli e fornire un risultato che una persona possa esaminare criticamente.
In molti team, l'impiego più efficace di un agente non consiste nel generare codice da zero. Consiste nel restringere lo spazio di ricerca attorno a un problema, prima che una persona debba dedicarvi ore di lavoro manuale.
Questo aspetto è particolarmente evidente nei flussi di debug su larga scala. Immaginiamo una CI notturna che esegua milioni di test su codebase modificate da centinaia di ingegneri: è la realtà di uno dei nostri clienti. Quando qualcosa non funziona, è difficile individuare il team responsabile. Il problema potrebbe trovarsi nel codice dell'applicazione, in una dipendenza, nell'infrastruttura di test o altrove nello stack. I log possono raggiungere dimensioni di diversi gigabyte e il primo team che rileva il problema non è sempre quello che ne è responsabile.
Un flusso di lavoro del genere non richiede necessariamente che un singolo agente scriva la correzione. È pensato per un sistema che restringa rapidamente l'ambito del problema.
Una pipeline efficace potrebbe recuperare i log, selezionare le evidenze pertinenti, riepilogare gli aspetti importanti, esaminare il codice in una sandbox e produrre un'analisi strutturata della causa principale, con un punteggio di affidabilità, tracciabilità e indicazioni sui passaggi successivi. Per generare un punteggio di affidabilità, un esperto del settore valuta l'output iniziale dell'agente. La valutazione viene quindi fornita a un LLM con funzione di giudice, così da automatizzare in futuro l'assegnazione dei punteggi mantenendola in linea con il giudizio umano.
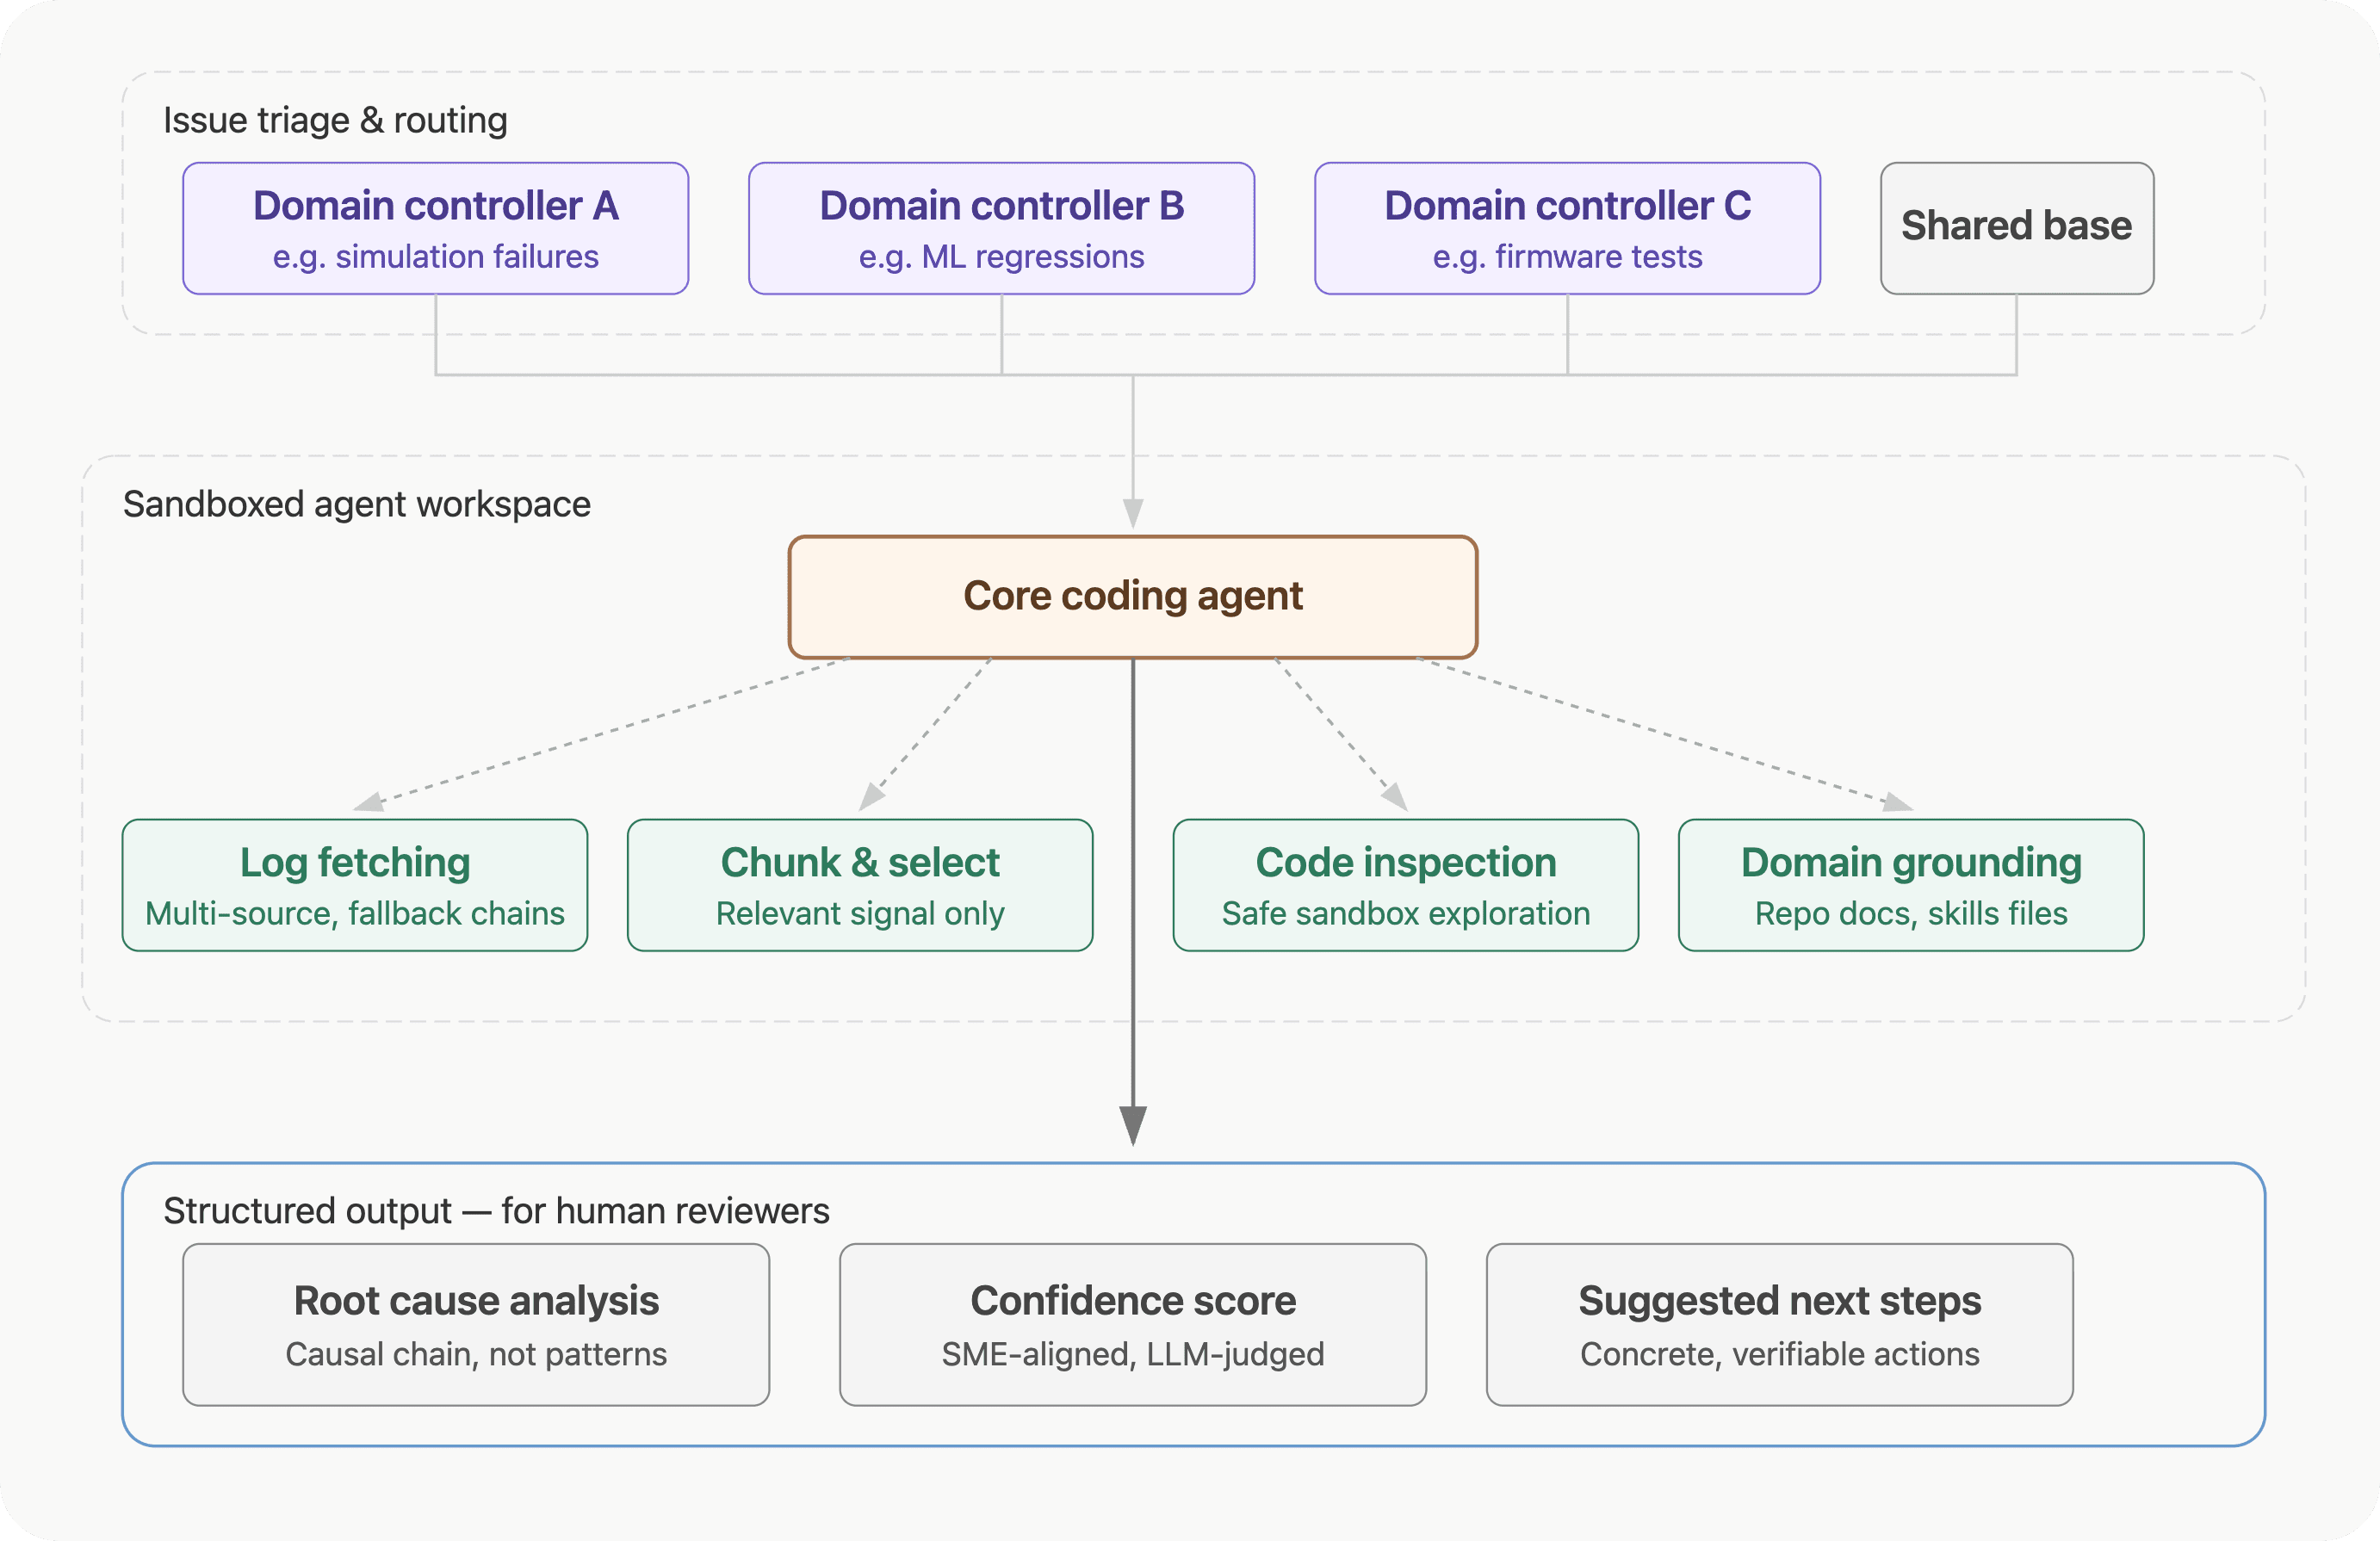
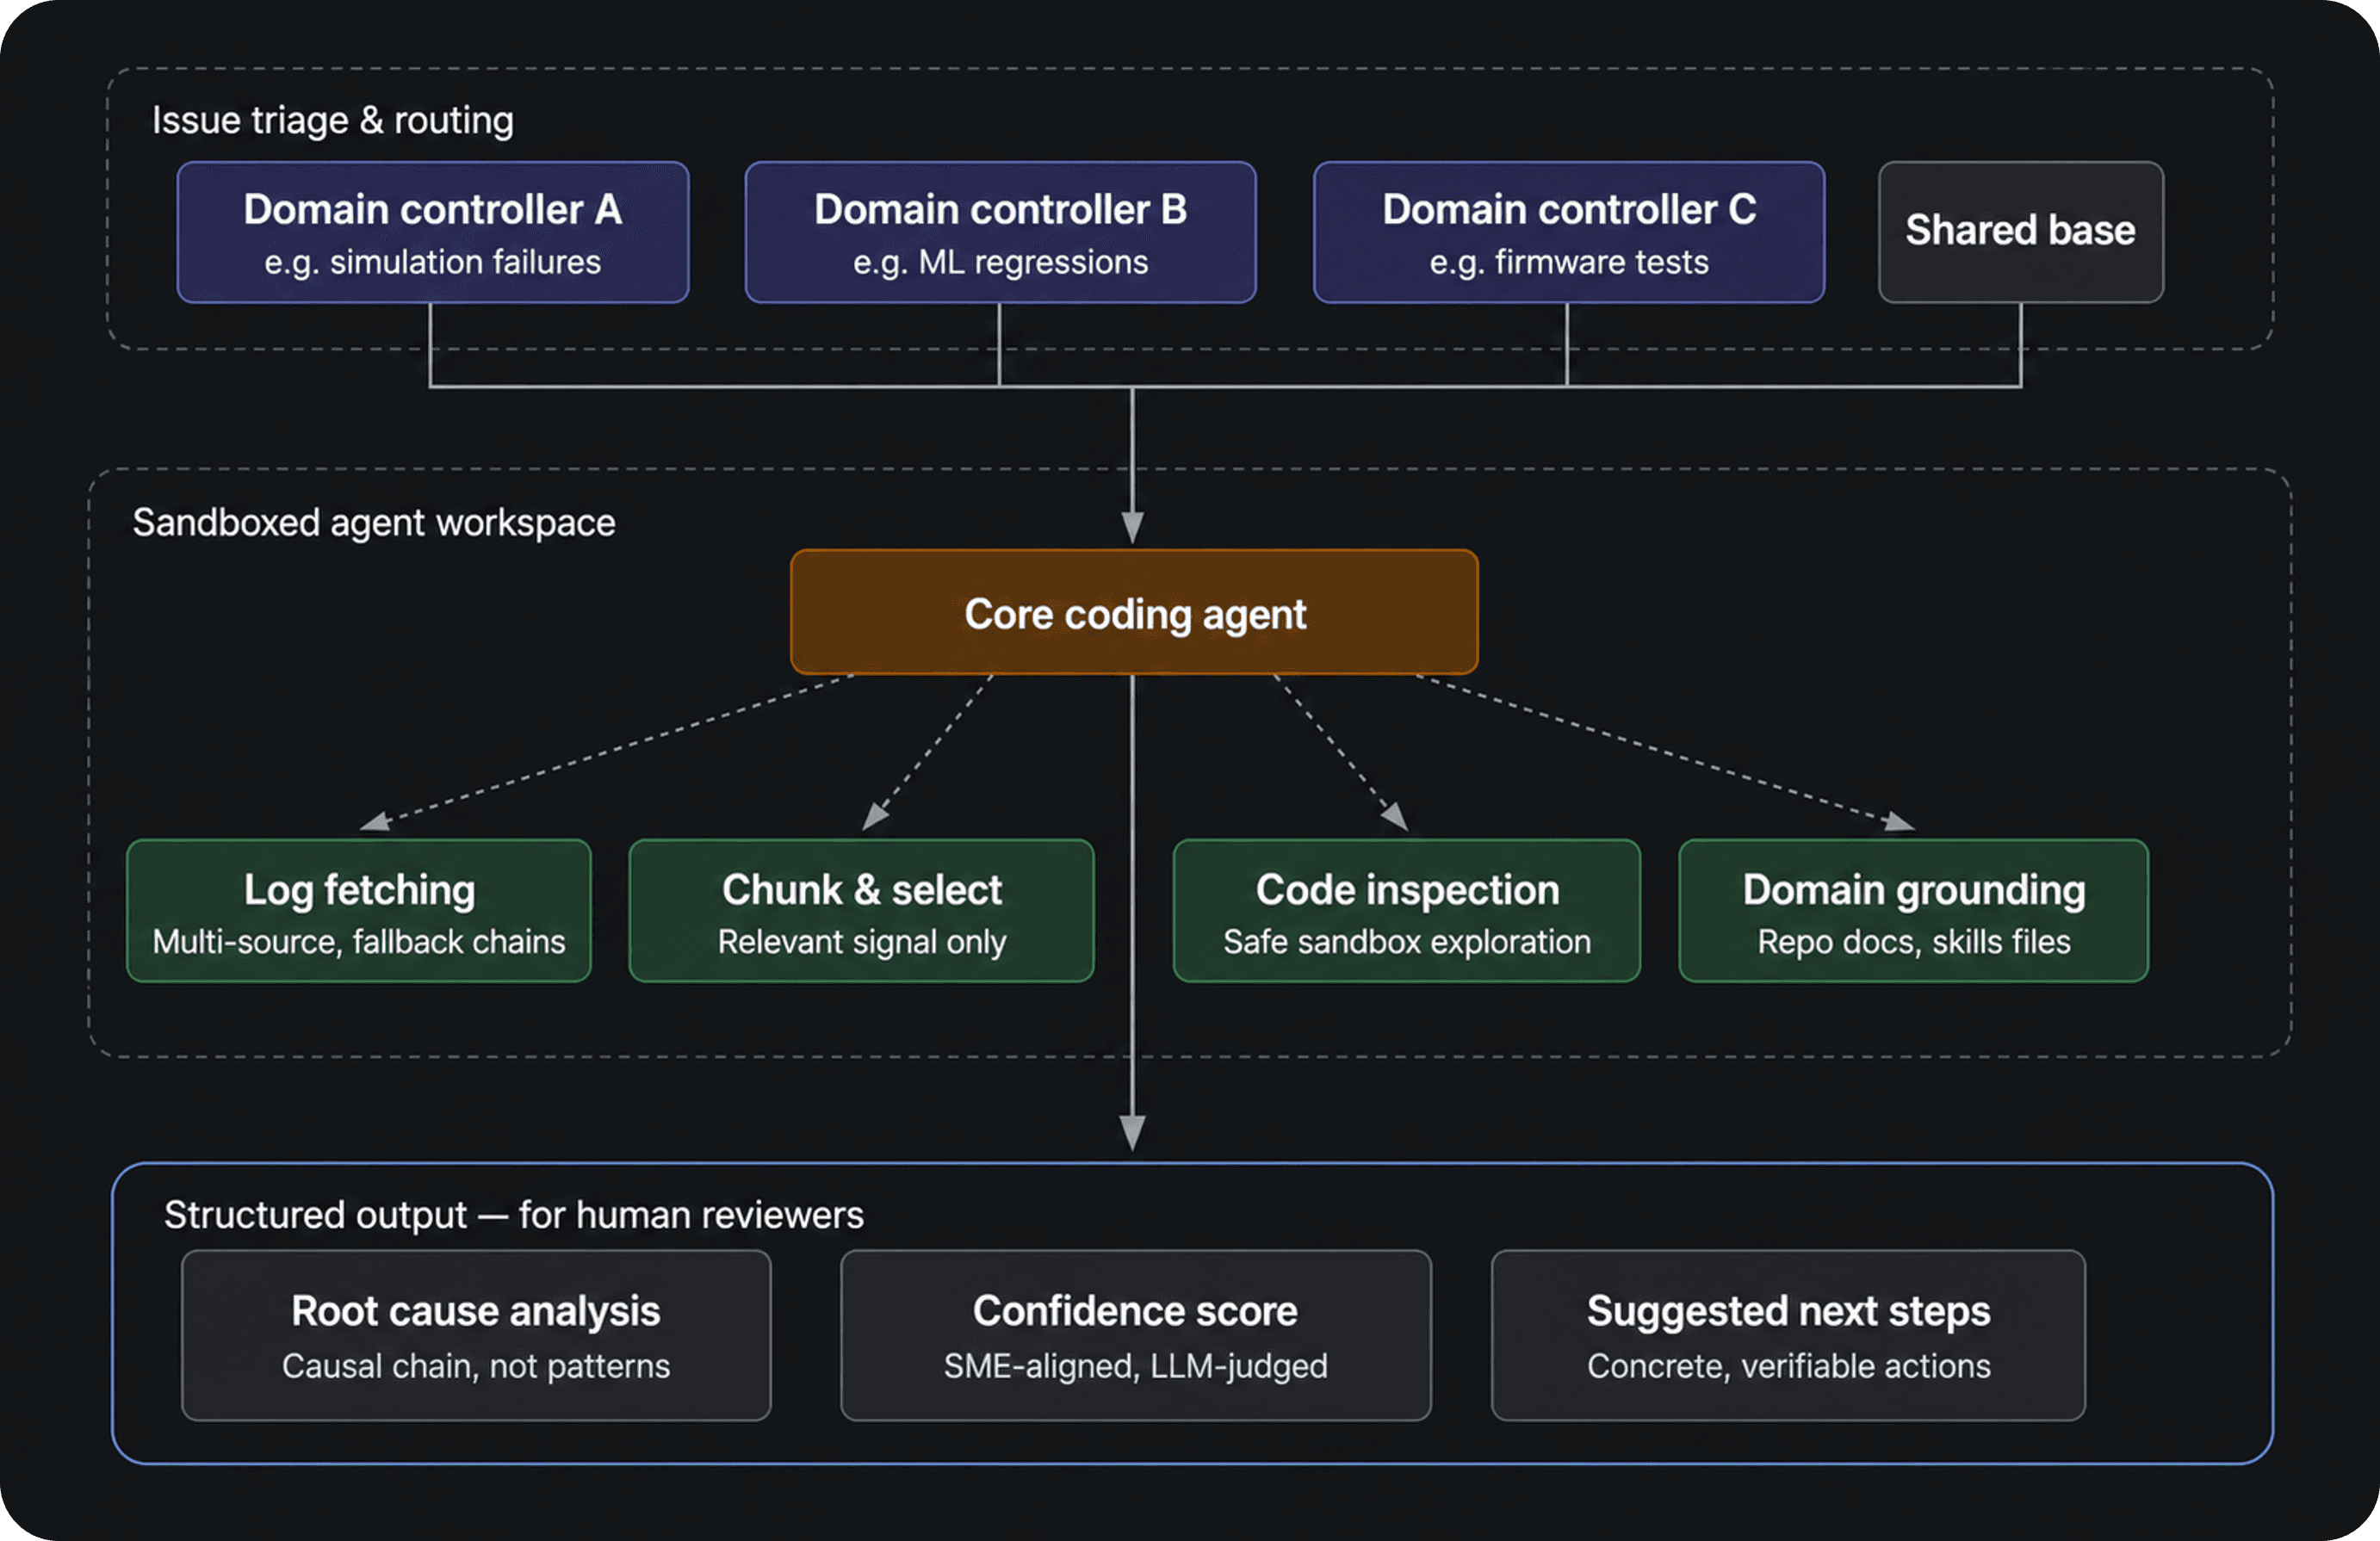
L'obiettivo non è eliminare il giudizio degli ingegneri, ma offrire a chi esegue la revisione un punto di partenza più solido. Il triage delle regressioni, la revisione delle PR, la correzione dei test, la convalida dei rilasci e le analisi successive alla distribuzione seguono tutti lo stesso schema. Richiedono molte evidenze e revisioni e presentano numerose ambiguità. Non chiedono a un agente di sostituire il processo di ingegneria, ma solo di contribuire a farlo avanzare.
Anche per questo i team devono valutare con attenzione questi sistemi.
La domanda sbagliata è se un agente sia in grado di produrre qualcosa di notevole quando opera in isolamento. La domanda più utile è se migliori un flusso di lavoro reale senza creare inefficienze altrove.
Occorre quindi verificare se l'output sia abbastanza specifico da poter essere controllato, se spieghi i nessi causali anziché limitarsi a riconoscere schemi ricorrenti e se renda la revisione più semplice anziché più difficile. Una risposta plausibile non è necessariamente una risposta utile. In pratica, i team si fidano dell'output di un agente quando resiste a un esame approfondito e offre elementi concreti da verificare.
La lezione più profonda è che i sistemi agentici utili non dipendono soltanto dalla generazione. Dipendono dal modo in cui vengono raccolte le evidenze, costruito il contesto, controllati gli output e segnalate le incertezze a chi esegue la revisione.
Per questo il futuro prossimo dell'ingegneria agentica difficilmente consisterà in un unico grande salto verso la piena autonomia. È più probabile che sia costituito da una serie di cicli progettati con precisione, nei quali gli agenti aiutano i team a esaminare, rivedere, verificare e perfezionare il lavoro, riducendo gli sprechi tra una fase e l'altra.
Può sembrare meno eclatante rispetto alla prospettiva di un'autonomia più ampia, ma è molto più vicino al modo in cui vengono effettivamente adottati i sistemi utili.