Pour la plupart des équipes adoptant la programmation agentique, le goulot d’étranglement passe de la génération à la revue, et le gain net de vélocité est presque nul si la boucle n’est pas corrigée.
Dans les environnements de CI à grande échelle — des millions de tests nocturnes et des centaines d’ingénieurs —, la tâche la plus utile pour un agent est l’attribution aux responsables et le triage, et non la génération de code.
Un résultat utile produit par un agent résiste à l’examen et explique les liens de causalité, au lieu de simplement relever des correspondances de motifs.
La conception de la couche de collecte des preuves et d’assemblage du contexte importe davantage que celle de la couche de génération.
La plupart des discussions sur la programmation agentique partent encore d’une promesse simple : écrire davantage de code, plus rapidement.
Cette promesse s’élargit parfois en une vision plus ambitieuse, dans laquelle des agents planifient le travail, ouvrent des PR et déploient des modifications avec une intervention humaine minimale. Mais pour la plupart des équipes d’ingénierie, la valeur la plus évidente à court terme est plus ciblée. Il s’agit de réduire le coût des itérations.
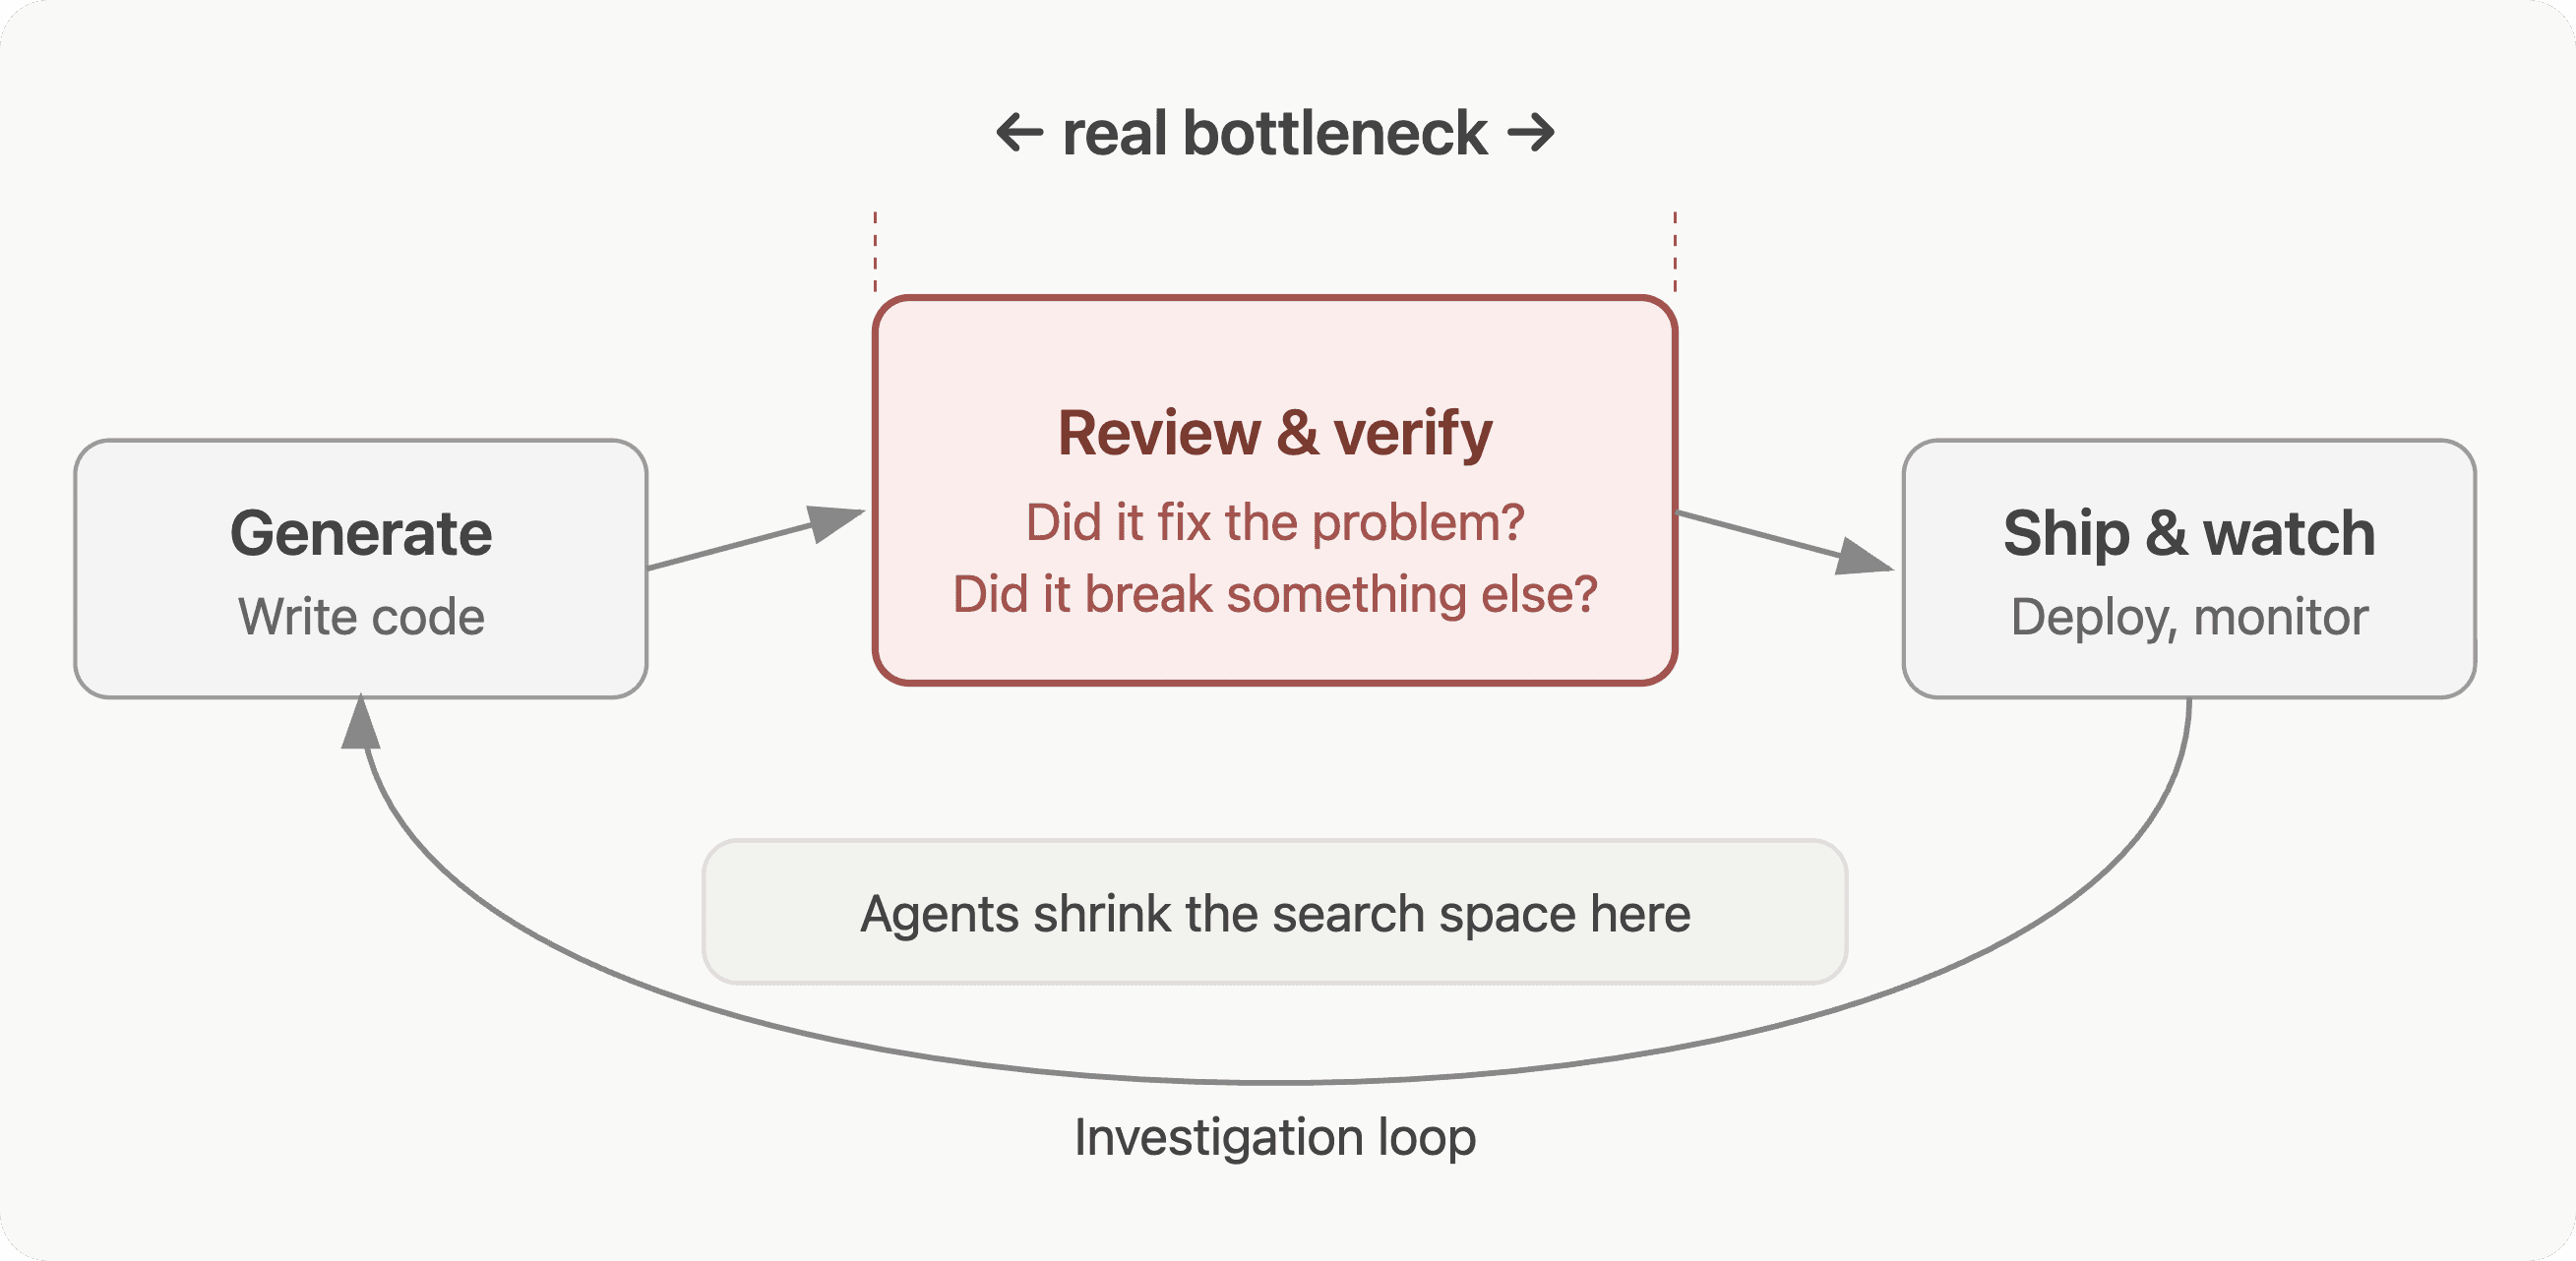
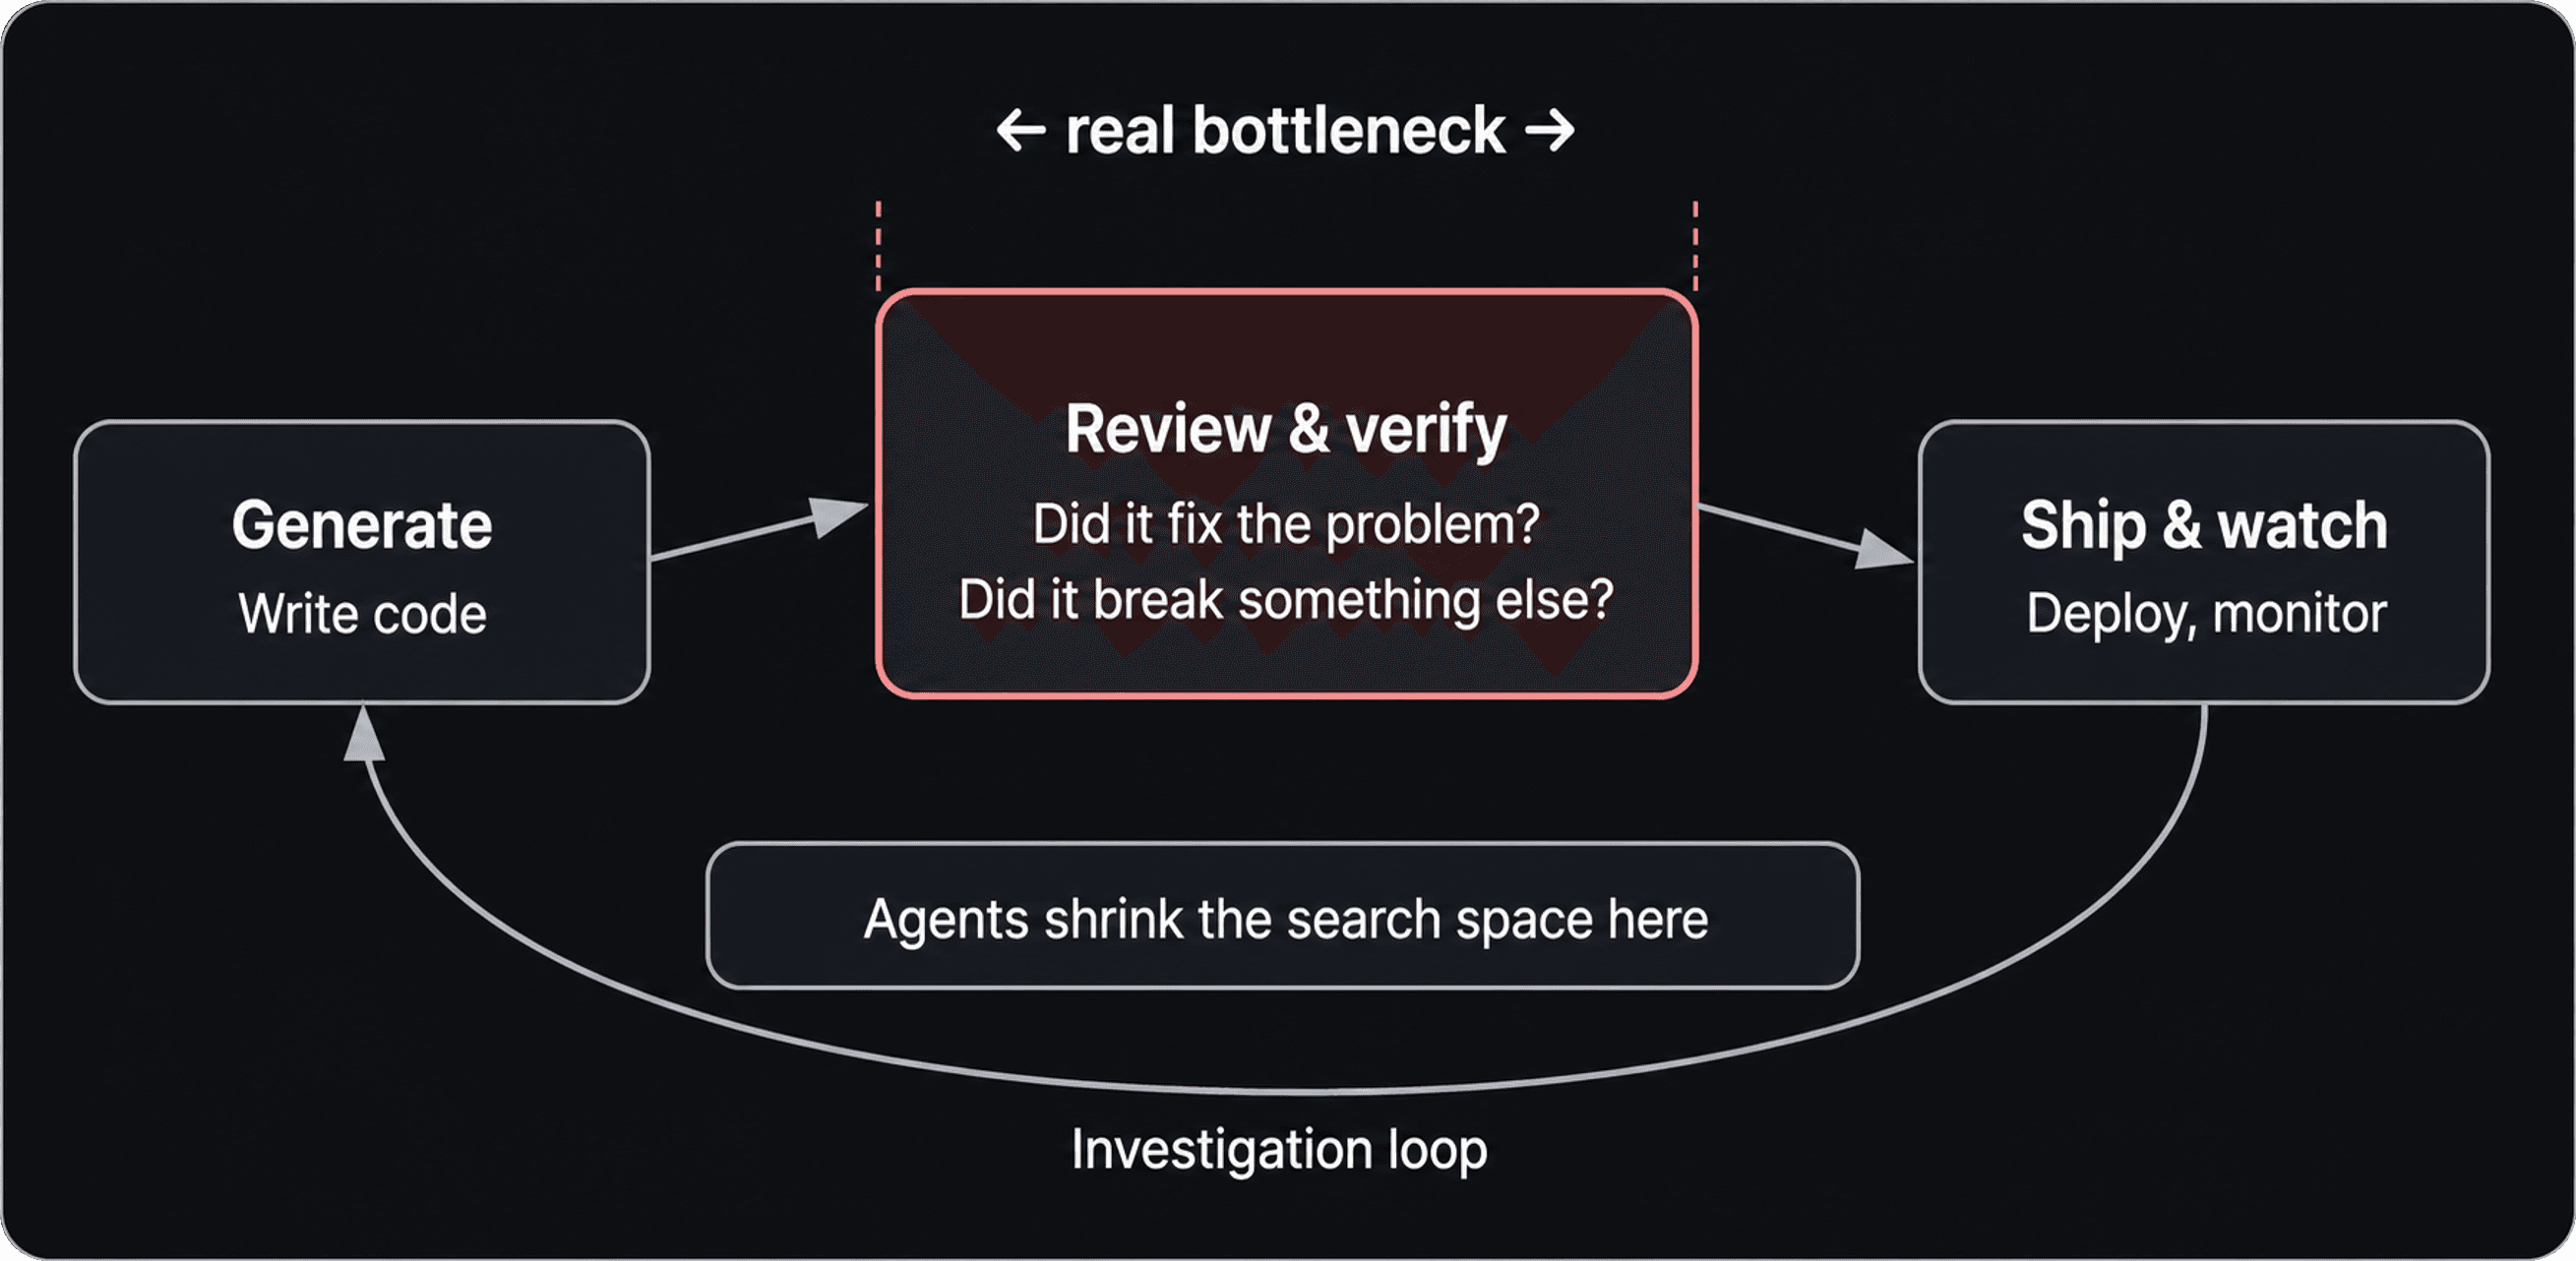
La livraison de logiciels ne se limite pas à la génération de code. L’écriture du code n’est qu’une étape d’une boucle plus longue comprenant la revue, les tests, le déploiement et l’investigation lorsque des problèmes surviennent. La plupart des équipes qui adoptent la programmation agentique sans repenser la boucle de revue ne font que déplacer leur goulot d’étranglement vers l’aval.
Accélérer uniquement la génération ne rend pas automatiquement une équipe plus rapide. Cela peut simplement reporter davantage d’efforts sur la revue, la vérification et l’établissement de la confiance.
Dans de nombreux environnements d’ingénierie, le plus coûteux n’est pas de produire une première version, mais d’acquérir un niveau de confiance suffisant.
La modification a-t-elle réellement corrigé le problème ou amélioré le système ? A-t-elle provoqué une régression ailleurs ? La défaillance provient-elle du code, de l’environnement, des tests ou d’une dépendance ? Le correctif proposé traite-t-il la cause ou seulement le symptôme visible ?
Les agents peuvent être utiles ici, non parce qu’ils remplacent les ingénieurs, mais parce qu’ils peuvent effectuer une première analyse structurée d’éléments disparates : examiner les journaux, comparer les modifications récentes, résumer les signaux pertinents, retracer les causes probables, exécuter des contrôles et fournir un résultat qu’un humain peut interroger.
Dans de nombreuses équipes, l’usage d’un agent ayant le plus d’impact n’est pas la génération de code à partir de zéro. Il consiste à réduire l’espace de recherche autour d’un problème avant qu’un humain y consacre des heures manuellement.
Cela apparaît particulièrement clairement dans les flux de débogage à grande échelle. Imaginez une CI nocturne exécutant des millions de tests sur des bases de code modifiées par des centaines d’ingénieurs — une réalité pour l’un de nos clients. Lorsqu’un problème survient, il est difficile de l’attribuer à l’équipe responsable. Le problème peut se trouver dans le code de l’application, une dépendance, le harnais de test ou ailleurs dans la pile. Les journaux peuvent atteindre plusieurs gigaoctets, et la première équipe à constater le problème n’est pas toujours celle qui en est responsable.
Ce type de flux ne nécessite pas naturellement qu’un seul agent écrive le correctif. Il est conçu pour un système qui réduit rapidement l’espace du problème.
Un pipeline utile pourrait récupérer les journaux, sélectionner les éléments pertinents, résumer l’essentiel, examiner le code dans un bac à sable et produire une analyse structurée des causes racines, accompagnée d’un score de confiance, d’une traçabilité et de suggestions pour la suite. Pour générer un score de confiance, un expert du domaine évalue le résultat initial de l’agent. Cette évaluation est ensuite transmise à un LLM utilisé comme juge afin d’automatiser les scores futurs tout en restant aligné sur le jugement humain.
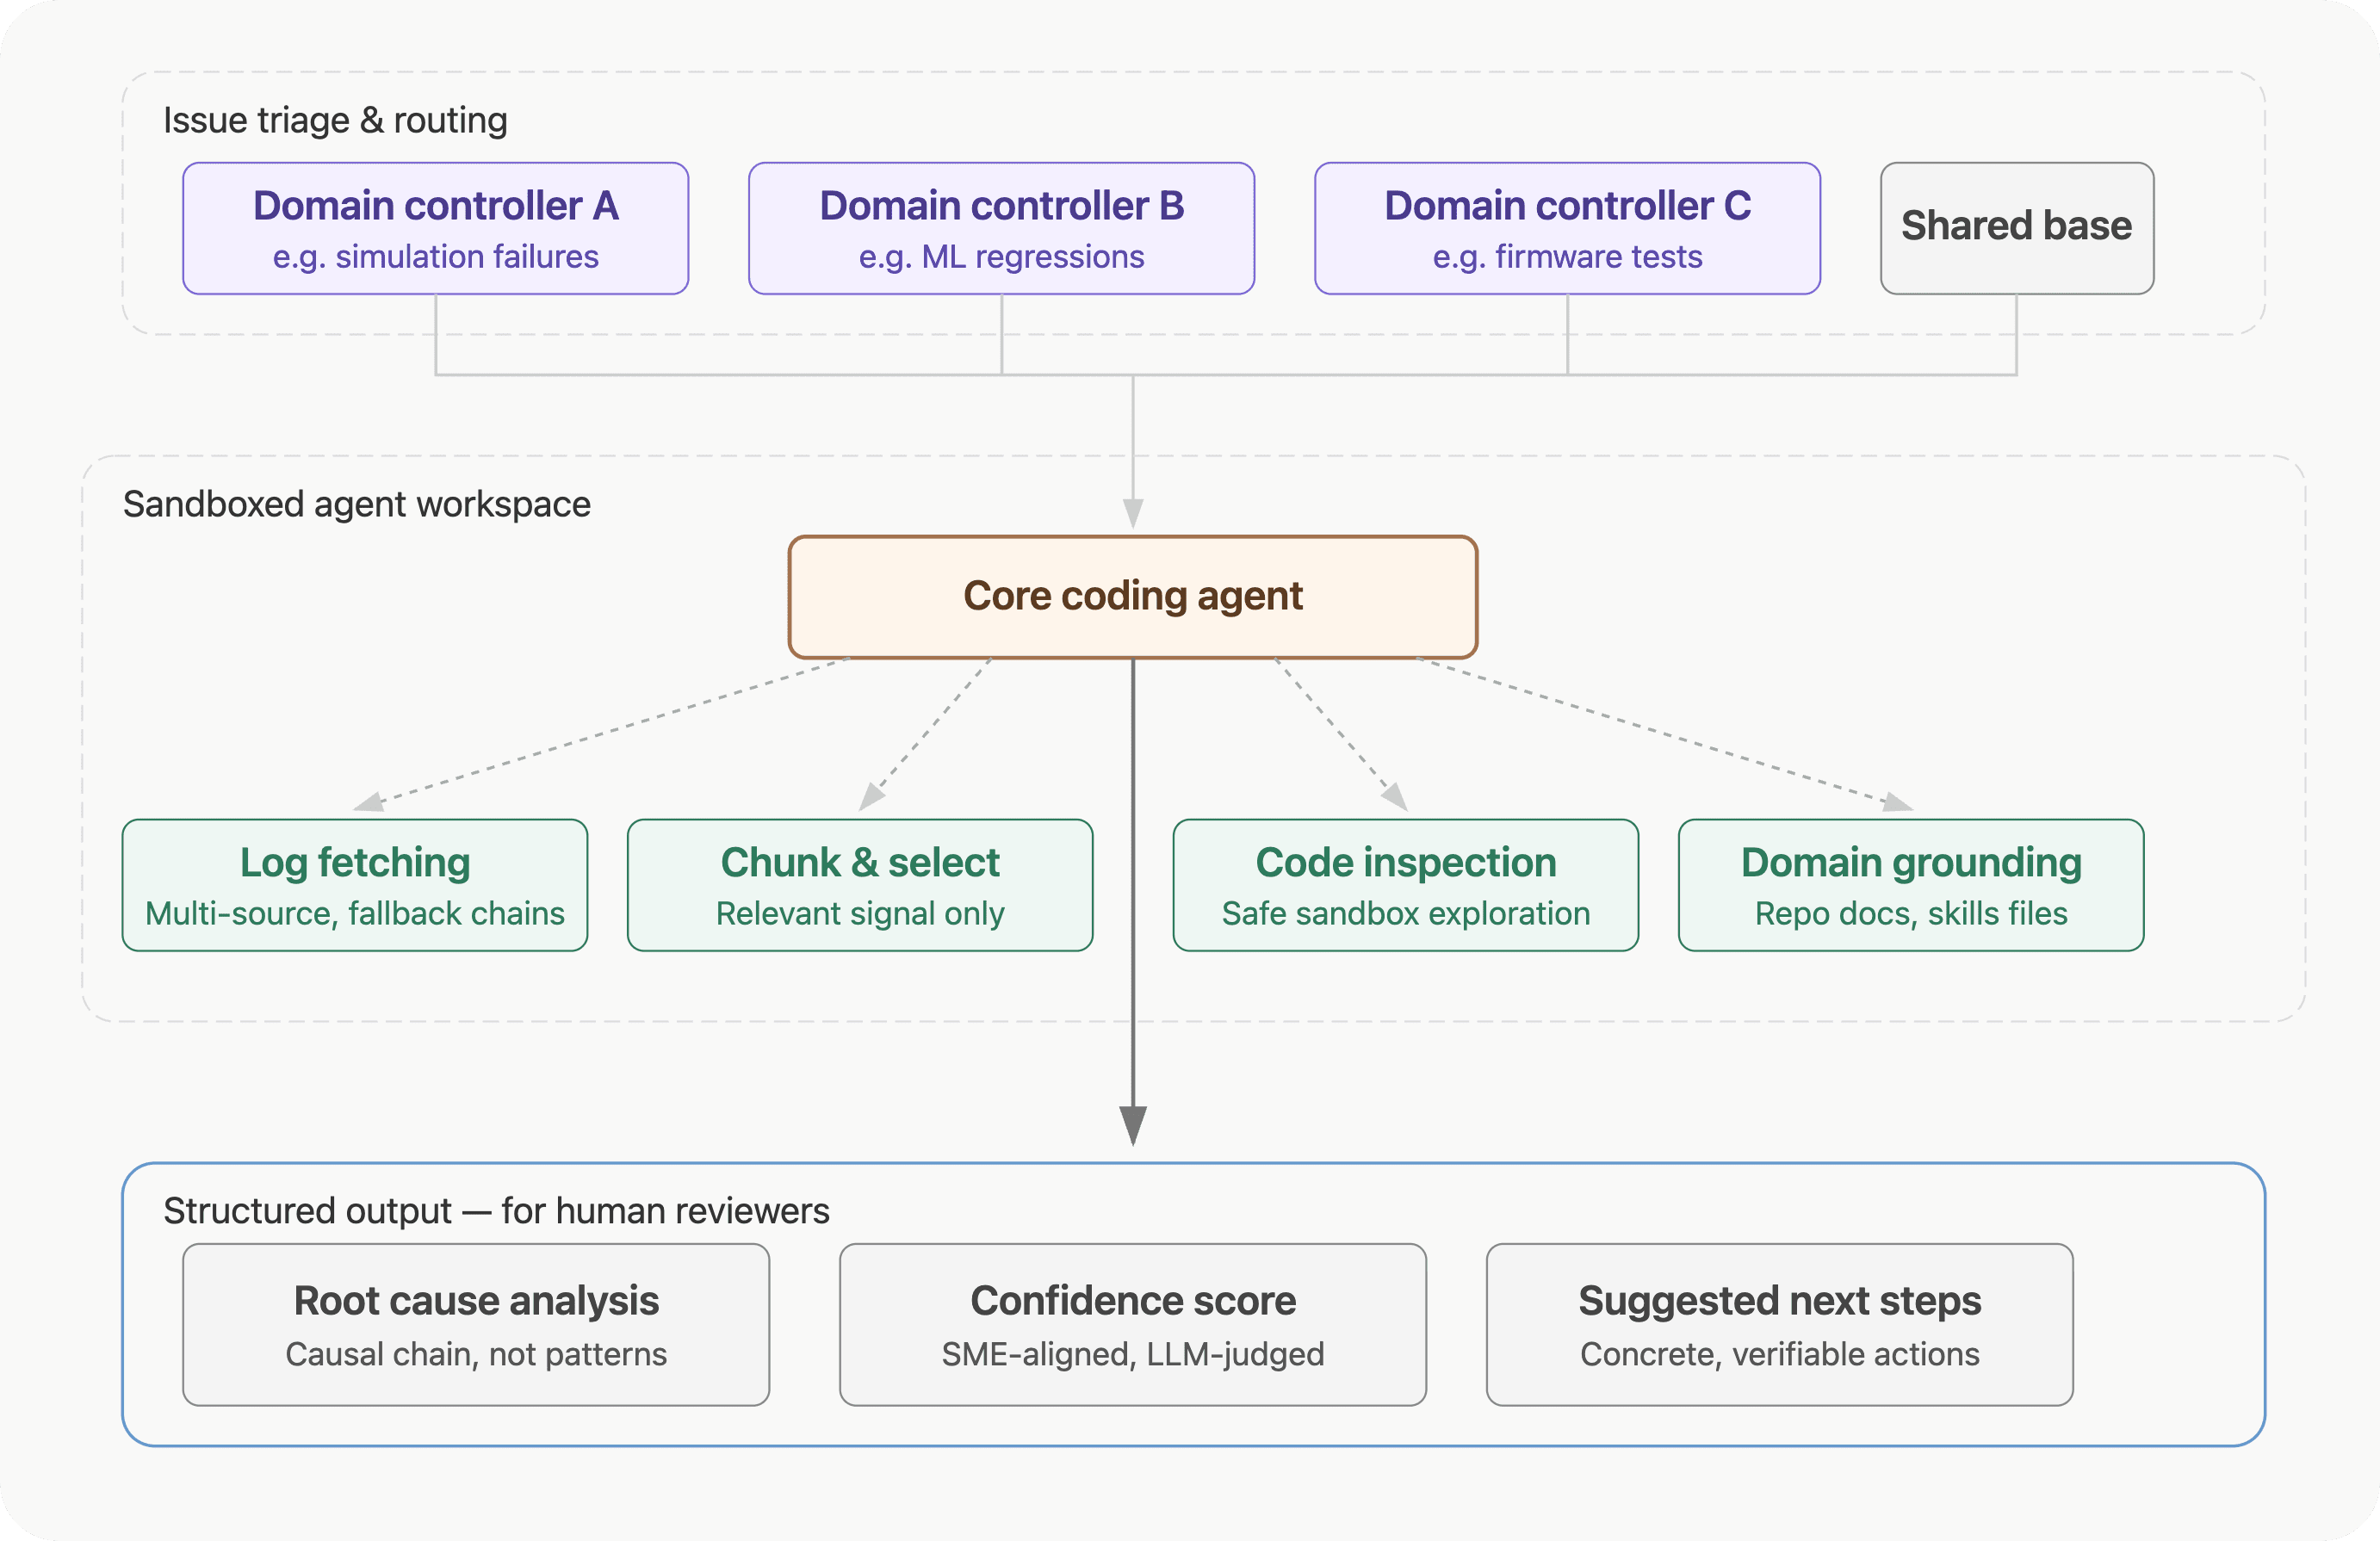
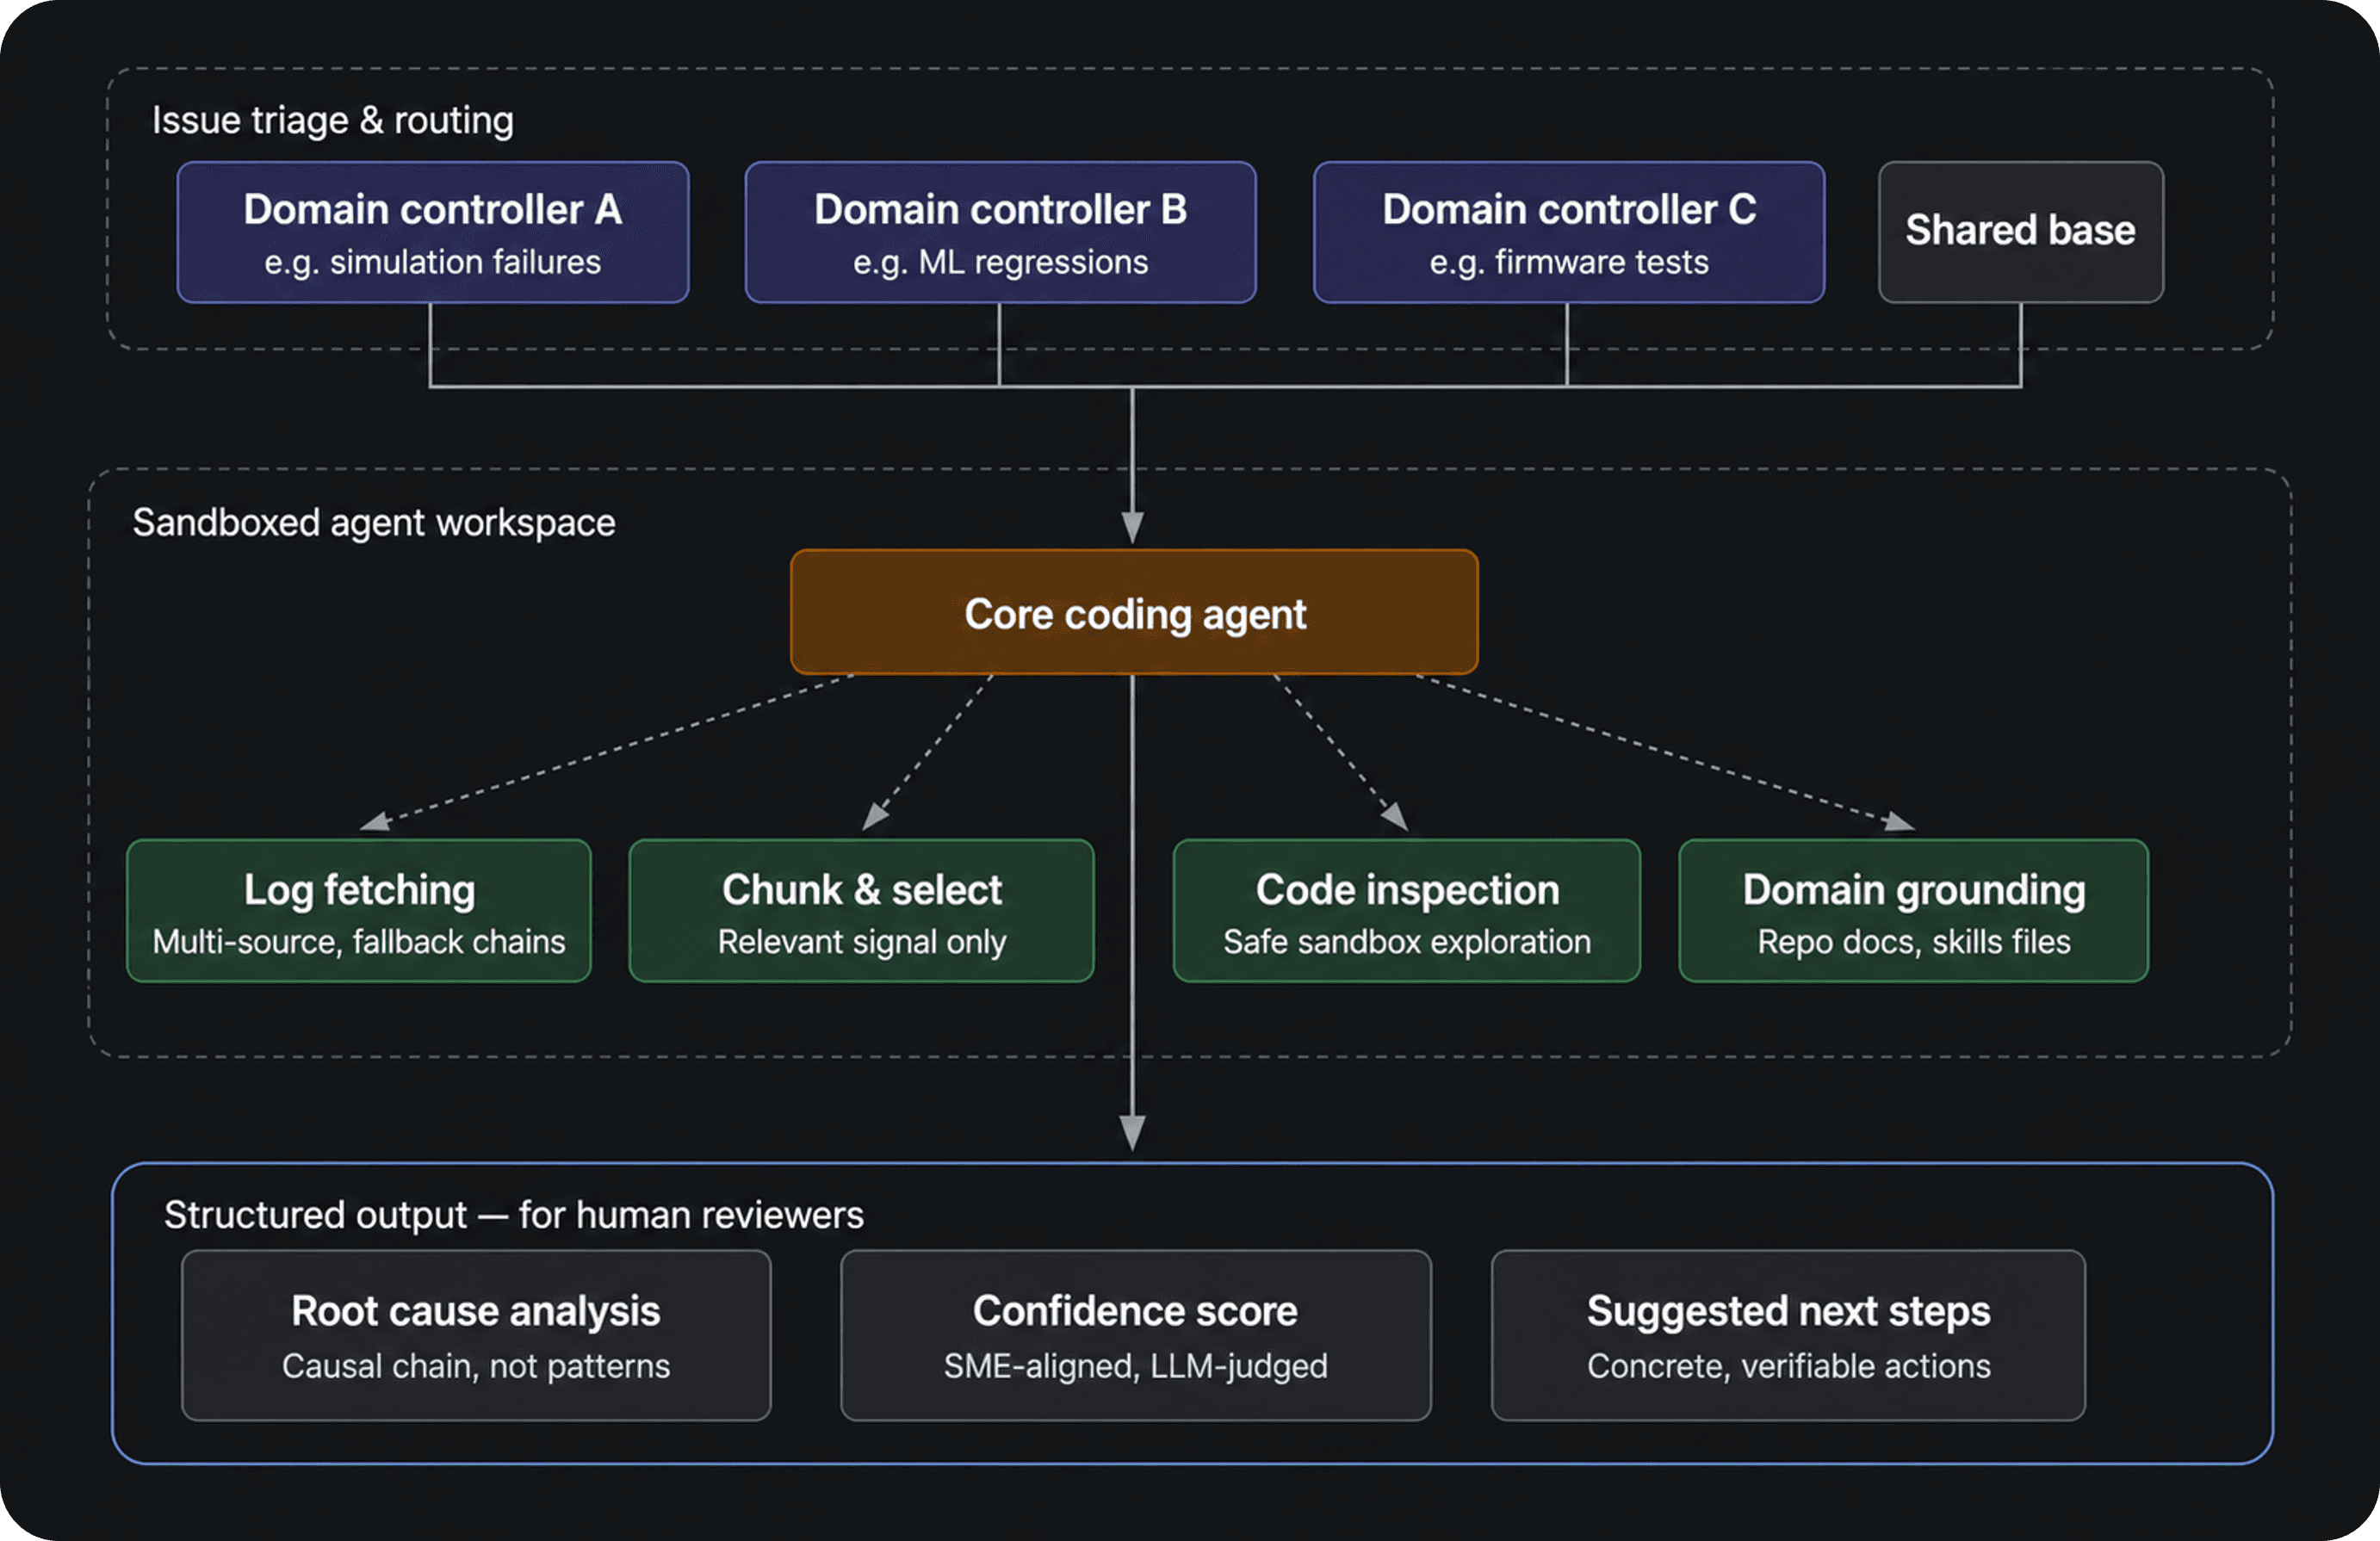
L’objectif n’est pas d’éliminer le jugement des ingénieurs, mais de donner aux réviseurs un meilleur point de départ. Le triage des régressions, la revue des PR, la réparation des tests, la validation des versions et l’investigation après déploiement suivent tous le même modèle. Ils reposent largement sur les preuves et la revue, et comportent beaucoup d’ambiguïtés. Ils ne demandent pas à un agent de remplacer le processus d’ingénierie, mais simplement de contribuer à le faire avancer.
C’est également pourquoi les équipes doivent évaluer ces systèmes avec prudence.
La mauvaise question est de savoir si un agent peut produire quelque chose d’impressionnant de manière isolée. La meilleure question est de savoir s’il améliore un véritable flux de travail sans créer de frictions ailleurs.
Il faut donc déterminer si le résultat est suffisamment précis pour être vérifié, s’il explique les liens de causalité plutôt que de simplement relever des correspondances de motifs, et s’il facilite la revue au lieu de la compliquer. Une réponse plausible n’est pas nécessairement utile. En pratique, les équipes font confiance au résultat d’un agent lorsqu’il résiste à l’examen et leur fournit des éléments concrets à vérifier.
La leçon fondamentale est que les systèmes agentiques utiles ne reposent pas uniquement sur la génération. Ils dépendent de la manière dont les preuves sont recueillies, le contexte est assemblé, les résultats sont contrôlés et les incertitudes sont présentées au réviseur.
C’est pourquoi l’avenir à court terme de l’ingénierie agentique ne devrait pas prendre la forme d’un bond unique vers l’autonomie totale. Il devrait plutôt prendre la forme d’un ensemble de boucles soigneusement conçues, dans lesquelles des agents aident les équipes à examiner, revoir, vérifier et affiner leur travail en réduisant les efforts inutiles entre les étapes.
Cela paraît peut-être moins spectaculaire que la perspective d’une autonomie élargie, mais correspond bien davantage à la manière dont les systèmes utiles sont réellement adoptés.