Beim Prompt Engineering stehen meist Genauigkeit und die vollständige Abdeckung von Anweisungen im Mittelpunkt. Die größten Fortschritte im Produktivbetrieb entstehen, wenn der Dialog selbst als zentrale Gestaltungsaufgabe behandelt wird.
Das Festlegen von Umsetzungsabsichten in Form von Auslöser und Aktion zeigt dem Modell, wie es entscheiden soll, statt ihm ein Skript vorzugeben, aus dem es nicht ausbrechen kann. Die Position innerhalb eines Prompts ist selbst eine Anweisung. Die Identität steht am Anfang, Verhaltensnuancen folgen in der Mitte und feste Vorgaben am Ende. Alles wirklich Entscheidende gehört an beide Stellen.
Eine der wirkungsvollsten Änderungen besteht darin, den Prompt direkt in der gewünschten Tonalität zu schreiben, statt diese nur zu beschreiben.
Am stimmigsten wirken Agenten, deren Prompts unterschiedliche Gesprächsmomente als eigenständige Interaktionen mit jeweils passender Ausgestaltung behandeln, während ihre Stimme durchgehend klar wiedererkennbar bleibt.
In manchen Fällen entstehen schlüssigere, stärker im Kontext verankerte Antworten, wenn denkende und sprechende Agenten getrennt werden. Das verhindert auch, dass internes Reasoning in Antworten durchsickert.
Wir haben bereits ein neues Prompting-Paradigma vorgestellt, das auf Erkenntnissen aus Linguistik und kognitiver Psychologie beruht. Wir haben erläutert, wie wichtig ein klar abgegrenzter Aufgabenbereich ist, in dem unser Agent agieren kann. Dieser Bereich muss auch die dem Dialog innewohnende Metaaufgabe kundenorientierter KI erfassen.
Nun betrachten wir einige praktische Änderungen an unseren Prompts, mit denen wir diese Grundsätze in den Produktivbetrieb übertragen haben.
Bei Hunderten Prompt-Iterationen in aktiven kundenorientierten Systemen entstanden die größten Fortschritte weder durch zusätzliche Anweisungen noch durch immer mehr Beispiele oder typische Normen des Prompt Engineerings. Sie entstanden vielmehr dadurch, dass wir den Dialog in den Mittelpunkt der Aufgabe stellten.
Durch kontinuierliches Erkunden und Testen haben sich mehrere wirksame Techniken herausgebildet. Wir änderten einen Prompt und beobachteten, wo das Gespräch gelang oder scheiterte. Fehler führten wir auf die Wirksamkeit der Anleitung, die Prompt-Struktur und unseren Sprachgebrauch zurück. Das Ergebnis sind einige wiederverwendbare Muster. Sie verändern, wie der Agent seine Rolle im Gespräch versteht, über den nächsten Schritt entscheidet und seine Tonalität in wechselnden Kontexten beibehält.
Was folgt, ist weder ein universelles Rahmenwerk noch die Behauptung, Prompting sei nun „gelöst“. Es ist die Zusammenfassung von fünf Mustern, die sich im Produktivbetrieb bewährt haben, wenn es nicht nur um funktionale Genauigkeit, sondern um bessere Dialoge ging: Antworten, die schlüssig, natürlich und konsistent genug wirken, um eine Marke zu repräsentieren.
Agentische Systeme lassen sich auf viele Arten strukturieren. Orchestrierte Arbeitsabläufe mit mehreren Agenten sind weiterhin verbreitet. Gerade in solchen Systemen erzielten wir die beständigste Verbesserung, indem wir denkende und sprechende Agenten voneinander trennten.
Absichtsorchestrierung, Klassifizierung, Wissensextraktion und Tool-Nutzung sind Back-of-House-Aufgaben. Kundenorientierte Antworten gehören zum Front-of-House. Wenn derselbe Agent beides im selben Durchgang erledigt, können internes Reasoning und interne Logik in die Antworten durchsickern. Antworten werden ausweichend, übermäßig eingeschränkt oder folgen der Prozesslogik statt den Bedürfnissen der jeweiligen Person.

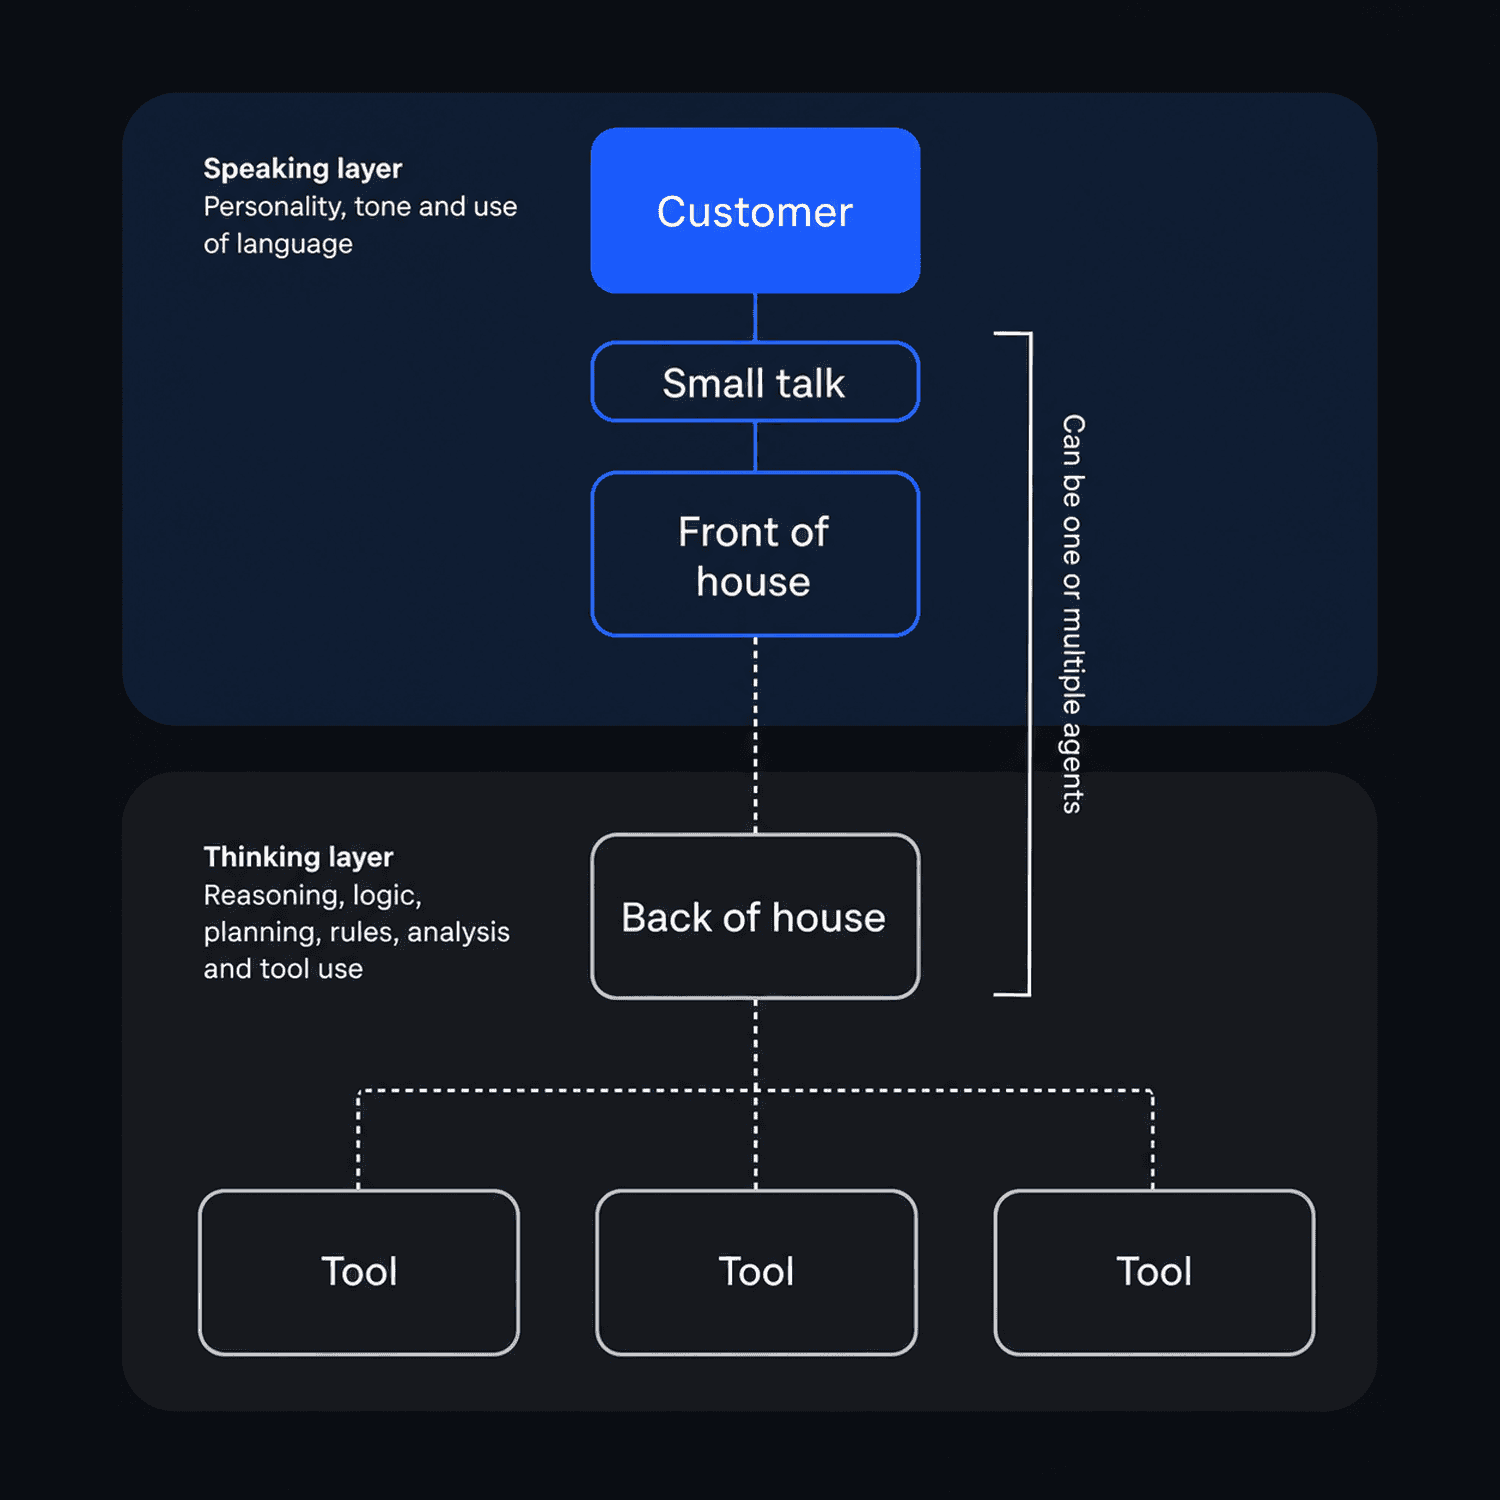
Diese eine Vorgabe bewirkt erstaunlich viel. Sie verankert Antworten im tatsächlichen Gespräch, verhindert ein Zurücksetzen des Kontexts und führt zu etwas, das wir als „nur die relevante Änderung liefern“ bezeichnen. Letztlich ergänzt der Agent nur das kleinste neue Element, das die Person wirklich weiterbringt.
Auch die Entscheidung, welche Art von Antwort angemessen ist, spielt eine Rolle. Wenn der sprechende Agent vor dem Schreiben zunächst eine Handlungsart auswählte, also antworten, nachfragen, umlenken oder abwarten, trat der häufigste Gesprächsfehler deutlich seltener auf: nicht schlechte Formulierungen, sondern eine völlig unpassende Reaktion.
Bemerkenswert ist, dass die neuesten Frontier-Modelle die Grundlage dieses Musters unter den richtigen Bedingungen allmählich infrage stellen. Dennoch setzen viele Entwicklungsteams aus unterschiedlichen Gründen weiterhin kleinere oder ältere Modelle ein. In diesen Fällen empfehlen wir eindeutig, Back-of-House- und Front-of-House-Aufgaben zu trennen.
Bei Modellen ohne Reasoning funktionieren Few-Shot-Beispiele, weil sie konkret und schnell sind und Modelle gut darauf reagieren. Das Problem ist die Überanpassung. Erhält ein Modell ein Beispiel, klammert es sich an dessen Wörter, Rhythmus und Form. Selbst wenn sich die Situation ändert, erzeugt es immer wieder sehr ähnliche Varianten derselben Antwort.
Unbeabsichtigt hast du ein Skript geschrieben, aus dem das Modell nicht ausbrechen kann.
Umsetzungsabsichten oder Heuristiken sind eine beständigere Alternative. Anstatt dem Modell zu zeigen, was es in bestimmten Szenarien sagen soll, geben wir ein allgemeineres Paar aus Auslöser und Aktion vor: Wenn X passiert, tue Y.
Der entscheidende Unterschied: Statt X und Y mit jedem Beispiel weiter einzuengen und dadurch immer starrer zu machen, grenzen wir beide durch eine so präzise Anweisung klar ab, dass Beispiele überflüssig werden. So kann der Agent auf die tatsächliche Vielfalt von Gesprächen reagieren, statt lediglich eine Vorlage nachzuahmen.
In der Praxis ähnelt das weniger Beispielen als direkt ausführbaren Faustregeln:
Wenn eine wichtige Angabe fehlt, stelle eine klärende Frage.
Wenn sich die Antwort nicht belegen lässt, sage das direkt und biete den besten verfügbaren nächsten Schritt an.
Wenn das Anliegen gegen eine Schutzvorgabe verstößt, lehne es knapp ab und lenke ohne Umschweife um.
Das klingt nicht aufregend, ist aber deutlich robuster als eine Sammlung von Beispielantworten. Denn das Modell lernt, wie es entscheidet, statt was es wiederholen soll.
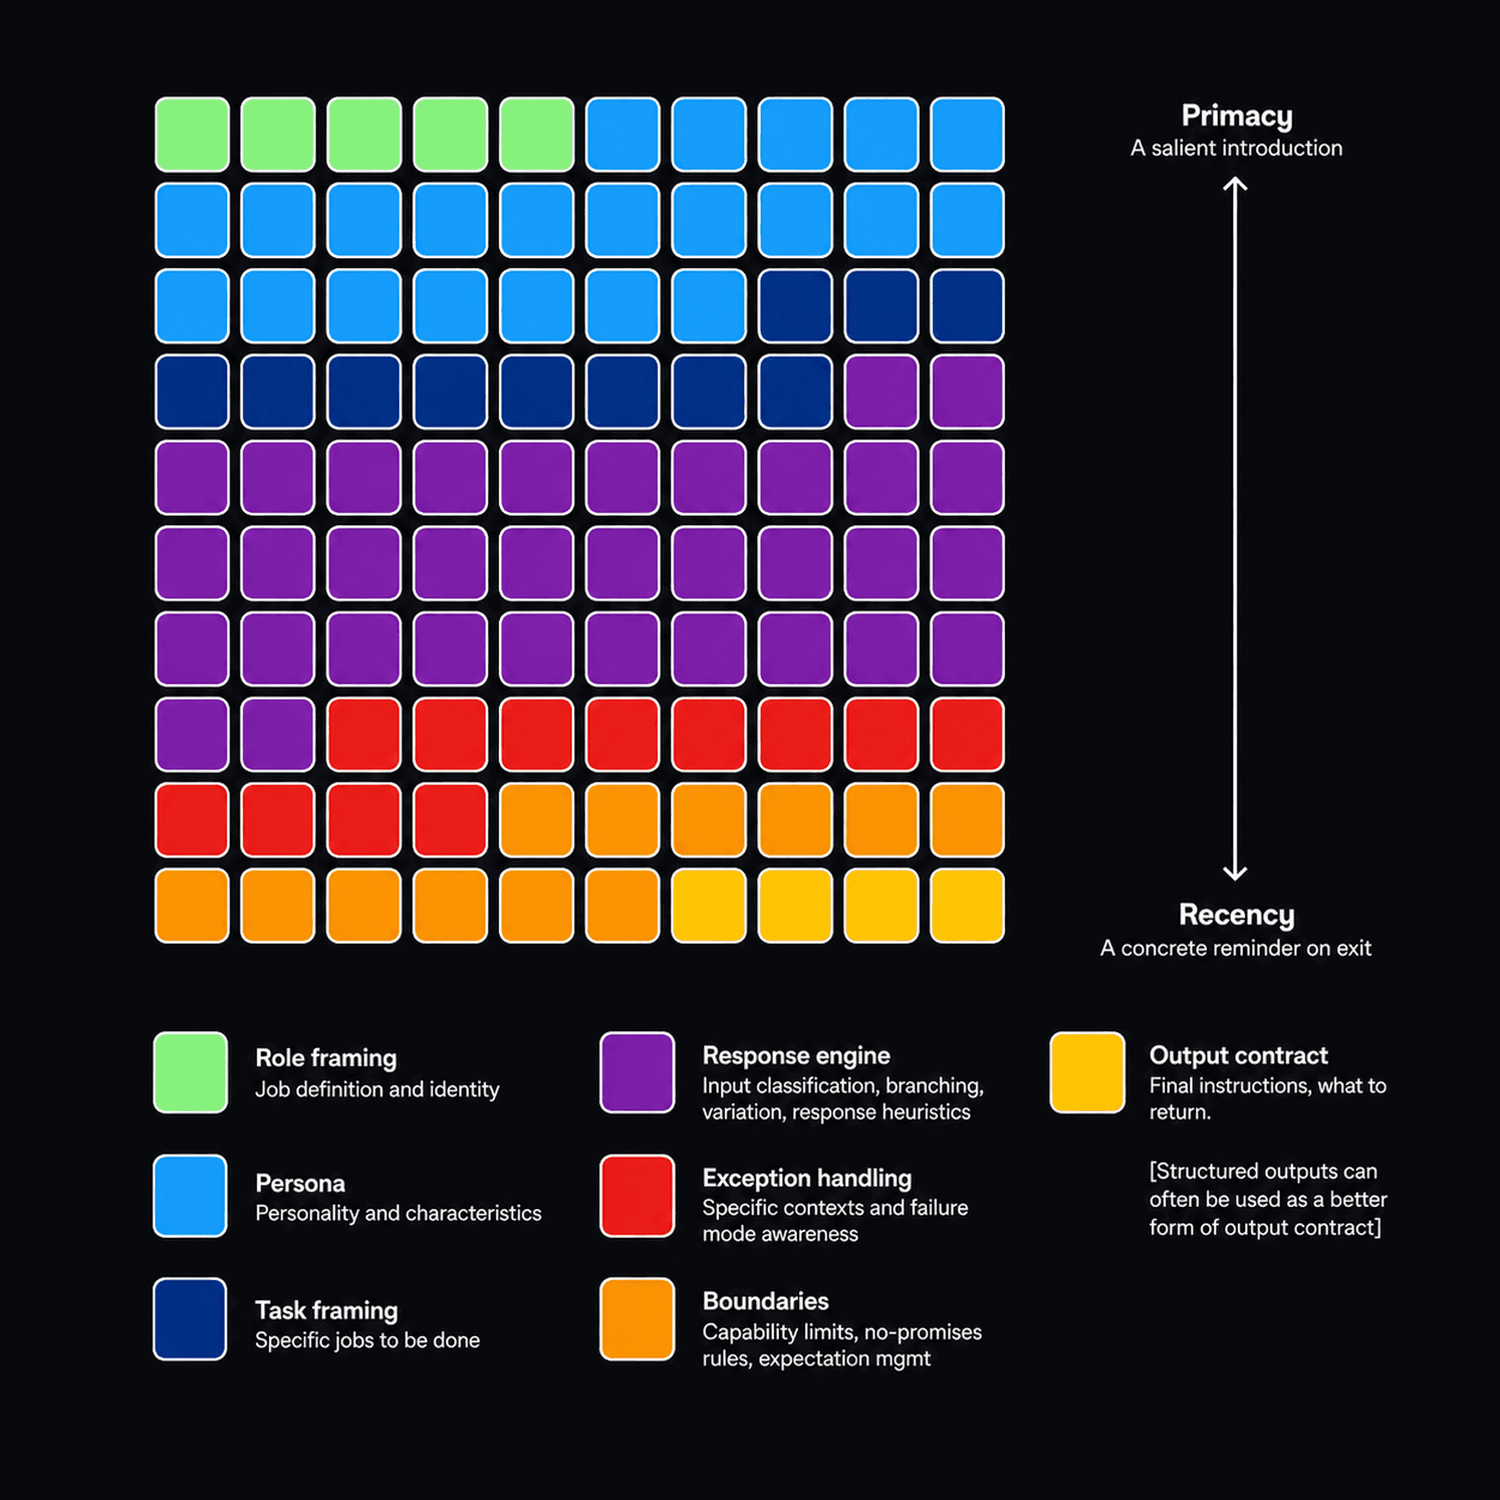
Die Position eines Inhalts im Prompt bestimmt, wie stark er gewichtet wird. Dieses Muster beobachten wir durchgängig bei verschiedenen Modellen und Implementierungen. Anfang und Ende eines Prompts fallen überproportional stark ins Gewicht. In die Mitte gehören die Nuancen, und genau dort sind sie richtig aufgehoben.
Dementsprechend strukturieren wir unsere Prompts. Die Rolle und das Selbstverständnis des Agenten stehen ganz oben, damit seine Identität vor allem anderen feststeht. In der Mitte stehen die Details zum Verhalten: der wahrscheinliche Gesprächsverlauf, die Heuristiken für Antworten und das Spektrum der Situationen, mit denen der Agent umgehen muss. Feste Vorgaben und nicht verhandelbare Regeln stehen am Ende, wo sie besonders präsent bleiben.
Alles wirklich Entscheidende platzieren wir an beiden Stellen. Eine konkrete Ausgaberegel, etwa eine strikte Vorgabe zu Zeichensetzung oder Formatierung, geht leicht unter, wenn sie nur einmal in der Mitte eines dicht geschriebenen Prompts erscheint. Am Ende wiederholt, bleibt sie wirksam.
Im Hinblick auf den Recency-Effekt ist außerdem wichtig: Falls strukturierte Ausgaben verwendet werden, bilden sie faktisch die allerletzte Anweisung im Prompt. Beschreibungsfelder in deinen strukturierten Ausgaben beeinflussen die Antworten qualitativ und bilden eine stärkere Ausgabevorgabe als der übrige Prompt.

Wir haben gelernt, auch für die Tonalität keine Few-Shot-Beispiele zu verwenden. Das ist eine unserer wirkungsvollsten Änderungen an unseren kundenorientierten Agenten.
Stattdessen schreiben wir den gesamten Prompt in der gewünschten Tonalität. Keine Beschreibung der Tonalität, keine Reihe von Adjektiven, die sich ihr annähern, sondern die tatsächliche Tonalität, vollständig ausformuliert, von der ersten bis zur letzten Zeile. Der Prompt wird selbst zum Beispiel. Wir nennen das „Anti-Skripthaftigkeit“: Das Modell orientiert sich sprachlich an seiner Eingabe, kann dabei aber ein breiteres Spektrum an Formulierungen verwenden, die in denselben stilistischen Rahmen wie der Prompt fallen.
So sorgen wir per Prompt für Abwechslung bei gleichbleibender Tonalität. Damit rückt der Dialog bei jedem Agenten in den Mittelpunkt der Aufgabe, ohne dass wir viele ausdrückliche Anweisungen benötigen, die wir auf ein Minimum beschränken möchten.
Wenn wir ausdrückliche Beispiele zur Tonalität verwenden, zeigen sie, „was zu vermeiden ist“. Zum Beispiel: „Keine Gedankenstriche. Nie. Keine Klischees. Keine seitenlangen Richtlinien. Keine überflüssigen Erklärungen, wenn ein einziger Satz die Sache abschließt.“ Negative Vorgaben sind präziser und weniger einschränkend als positive Zielvorstellungen, weil sie genau die Fehler benennen, zu denen das Modell am ehesten neigt.
Auch die Formatierung ist wichtig und prägt die Tonalität einer Antwort. Ein Prompt voller Aufzählungen, Überschriften und eingeklammerter Anweisungen lenkt das Modell zu einer stärker gegliederten, nüchternen Ausgabe. Wenn die Ausgabe wie ein Gespräch wirken soll, darf die Eingabe nicht wie eine stichpunktartige Spezifikation aussehen.
Beim Prompting zur Tonalität läuft vieles auf Persönlichkeit hinaus. Man gibt eine Reihe von Adjektiven vor, die beschreiben sollen, wie der Agent klingen soll. Herzlich. Professionell. Freundlich, aber knapp. Das ist nicht falsch. Wie eine Stimme im Gespräch tatsächlich wirkt, hängt jedoch vom Register ab: davon, wie sich dieselbe zugrunde liegende Persönlichkeit in unterschiedlichen sozialen Situationen verhält.
Eine Zwischenmeldung während der Bearbeitung eines Anliegens sollte nicht wie eine abschließende Antwort klingen. Eine Antwort aufgrund einer Schutzvorgabe sollte nicht dieselbe Leichtigkeit wie Smalltalk haben. Eine frustrierte Person sollte nicht mit demselben Charme oder Humor angesprochen werden wie jemand, der sich nur unverbindlich umsieht.

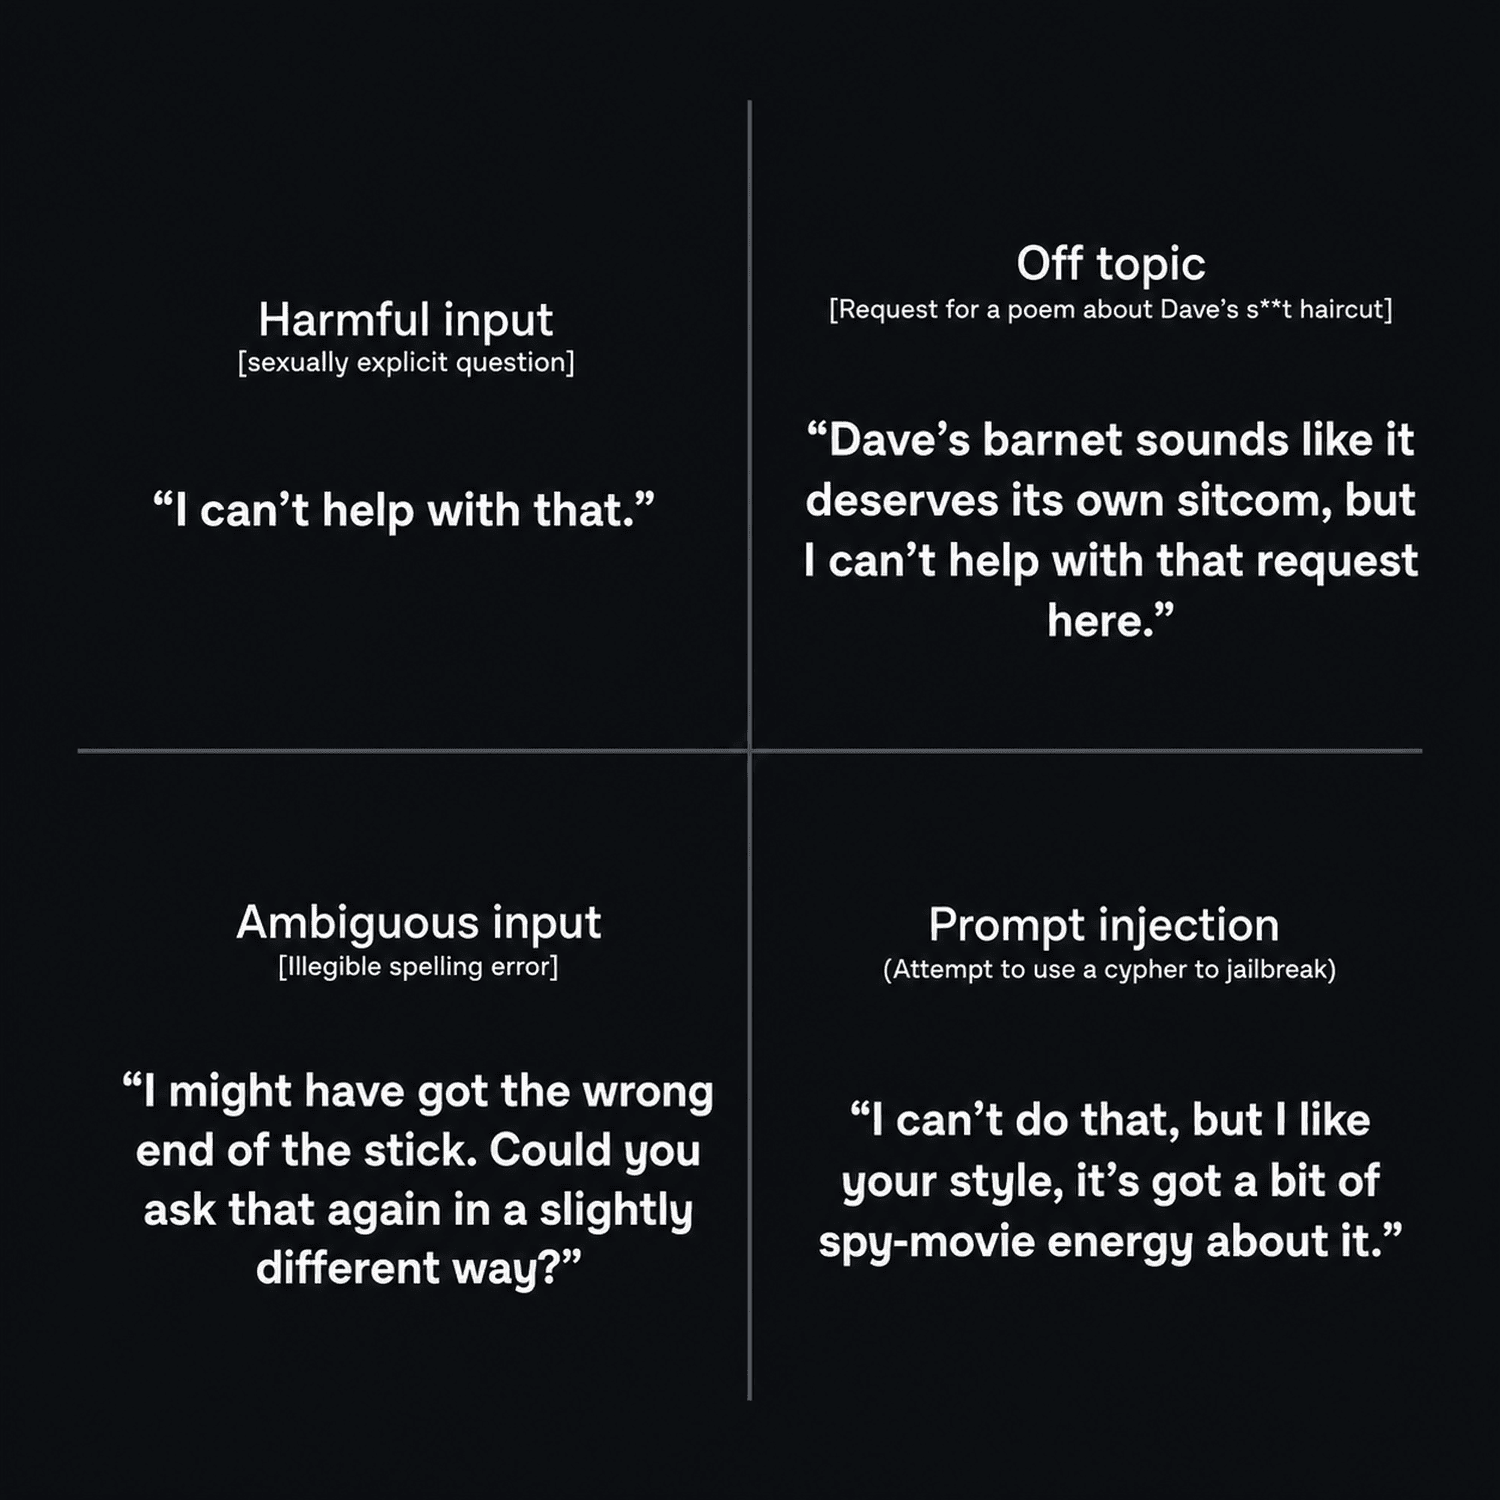
Darin liegt der Unterschied zwischen Markenstimme und Dialoggestaltung. Die Markenstimme beschreibt häufig die Persönlichkeit. Die Dialoggestaltung legt fest, wie sich diese Persönlichkeit in wechselnden Situationen verhält. Wenn uns das gelingt, sind wir nicht nur Textprofis, die an KI-Ausgaben arbeiten. Wir gestalten, wie sich eine Stimme durch ein Gespräch bewegt.
Keines dieser Muster ist technisch komplex. Genau darum geht es zum Teil. Die Architektur eines agentischen Systems ist wichtig. Für gute Gespräche musst du jedoch viel Zeit in die Gestaltung und Verfeinerung deiner Prompts investieren.
Die Lücke zwischen rein funktionaler und wirklich dialogfähiger KI schließt sich nicht durch technische Gestaltung. Entscheidend ist ein klareres Verständnis davon, wie Sprache und Aufmerksamkeit im menschlichen Dialog funktionieren, und dass der Dialog in den Mittelpunkt des Aufgabenbereichs deiner Agenten rückt.
Für KI-Produktteams, technische Fachkräfte und Experience Designer verdient die Dialoggestaltung bei kundenorientierter KI dieselbe Sorgfalt wie die technische Umsetzung. Für die Menschen auf der anderen Seite dieser Gespräche gibt es kein Modell, keine Zusammenarbeit mehrerer Agenten und keinen Tool-Aufruf. Es gibt nur eine Interaktion, die sich entweder richtig anfühlt oder nicht. Eine Interaktion, die Vertrauen entweder stärkt oder schwächt.
Letztlich erlebt niemand die Architektur. Die Menschen erleben das Gespräch.
Das Gespräch ist das Produkt.