大多數團隊採用智能代理式編碼後,瓶頸會由生成轉移至審核;若不改善審核循環,整體交付速度幾乎不會有所提升。
在大規模 CI 環境中(每晚執行數百萬項測試,涉及數百名工程師),最具價值的智能代理任務是判定由哪個團隊負責,並進行問題分流,而非生成程式碼。
有用的智能代理輸出經得起仔細審核,並能解釋因果關係,而不只是比對模式。
收集證據、整合背景資料的設計,比生成層更為重要。
目前有關智能代理式編碼的討論,大多仍由一個簡單承諾開始:以更快速度編寫更多程式碼。
有時,這會延伸成更具抱負的願景:由智能代理規劃工作、建立 PR,並在極少人為介入下發佈變更。但對大多數工程團隊而言,近期最明確的價值其實更為聚焦。關鍵在於降低每輪開發迭代的成本。
軟件交付並不只是生成程式碼。編寫程式碼只是較長循環中的一個階段;整個循環還包括審核、測試、部署,以及在出現問題時進行調查。大多數團隊採用智能代理式編碼時,若不重新設計審核循環,只會把瓶頸轉移到後續環節。
單純加快生成速度,並不會自動提升團隊效率。這可能只會令審核、驗證和建立信任需要投入更多工夫。
在許多工程環境中,成本高昂的環節不是製作初稿,而是建立足夠信心。
這項變更是否確實修正了問題,或改善了系統?它有否在其他地方引致回歸問題?故障源於程式碼、環境、測試,還是某項依賴項目?擬議修正針對的是成因,還是僅處理表面症狀?
智能代理可在這方面提供協助,不是因為它們能取代工程師,而是因為它們能有系統地初步整理分散而繁雜的證據:檢查日誌、比較近期變更、總結相關訊號、追查可能成因、執行檢查,並提供可供人員進一步查證的結果。
對許多團隊而言,智能代理效益最高的用途並非從零開始生成程式碼,而是在人手花數小時進行調查前,先縮窄問題的搜尋範圍。
這一點在大規模偵錯工作流程中尤其明顯。試想像,每晚的 CI 要在數百名工程師參與修改的程式碼庫中執行數百萬項測試,而我們其中一個客戶正面對這種情況。一旦出現故障,要判定並轉交負責團隊並不容易。問題可能出於應用程式碼、某項依賴項目、測試框架,或技術堆疊的其他部分。日誌檔案可達數 GB,而最先發現問題的團隊未必是負責該部分的團隊。
這類工作流程本來就不適合交由單一智能代理直接編寫修正內容。它需要的是一套能迅速縮窄問題範圍的系統。
實用的處理流程可以提取日誌、選取相關證據、總結重點、在沙盒中檢查程式碼,並產生結構化的根本原因分析,包含可信度評分、可追溯性及建議的後續步驟。為產生可信度評分,領域專家會先為智能代理的初步輸出評分,再把結果輸入以 LLM 作評審的系統,讓日後的評分可以自動化,同時維持與人類判斷的一致性。
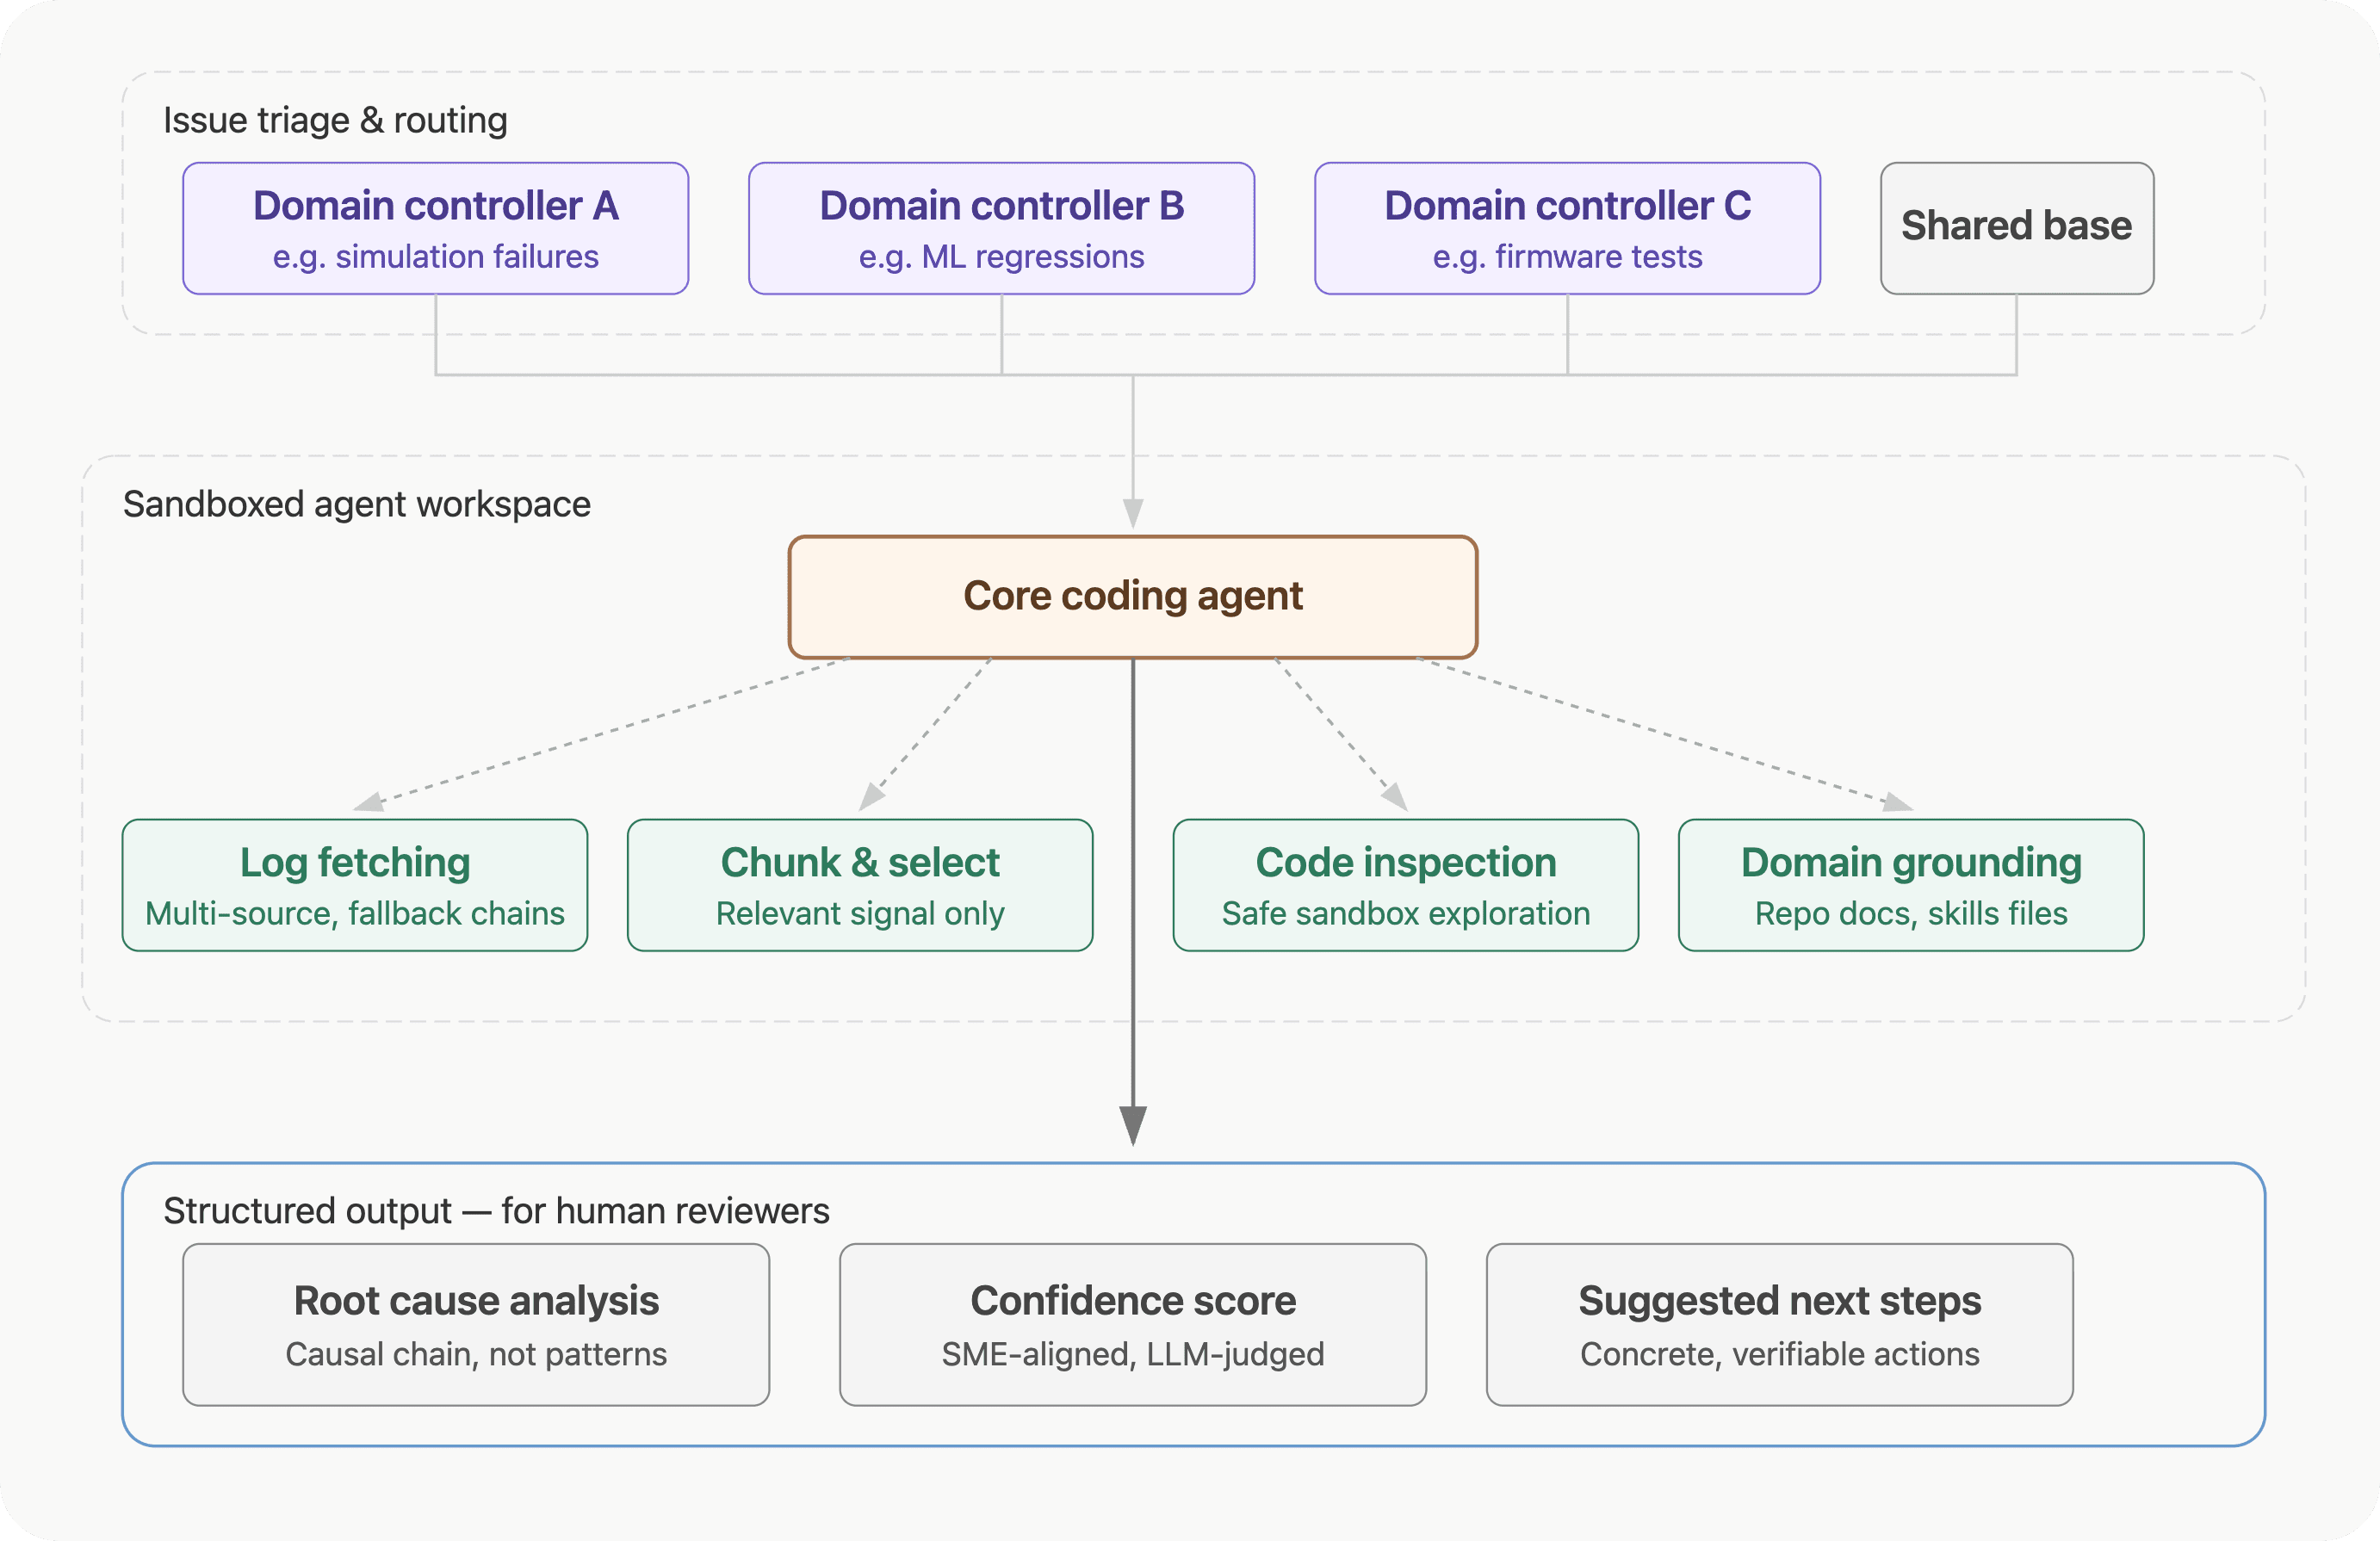
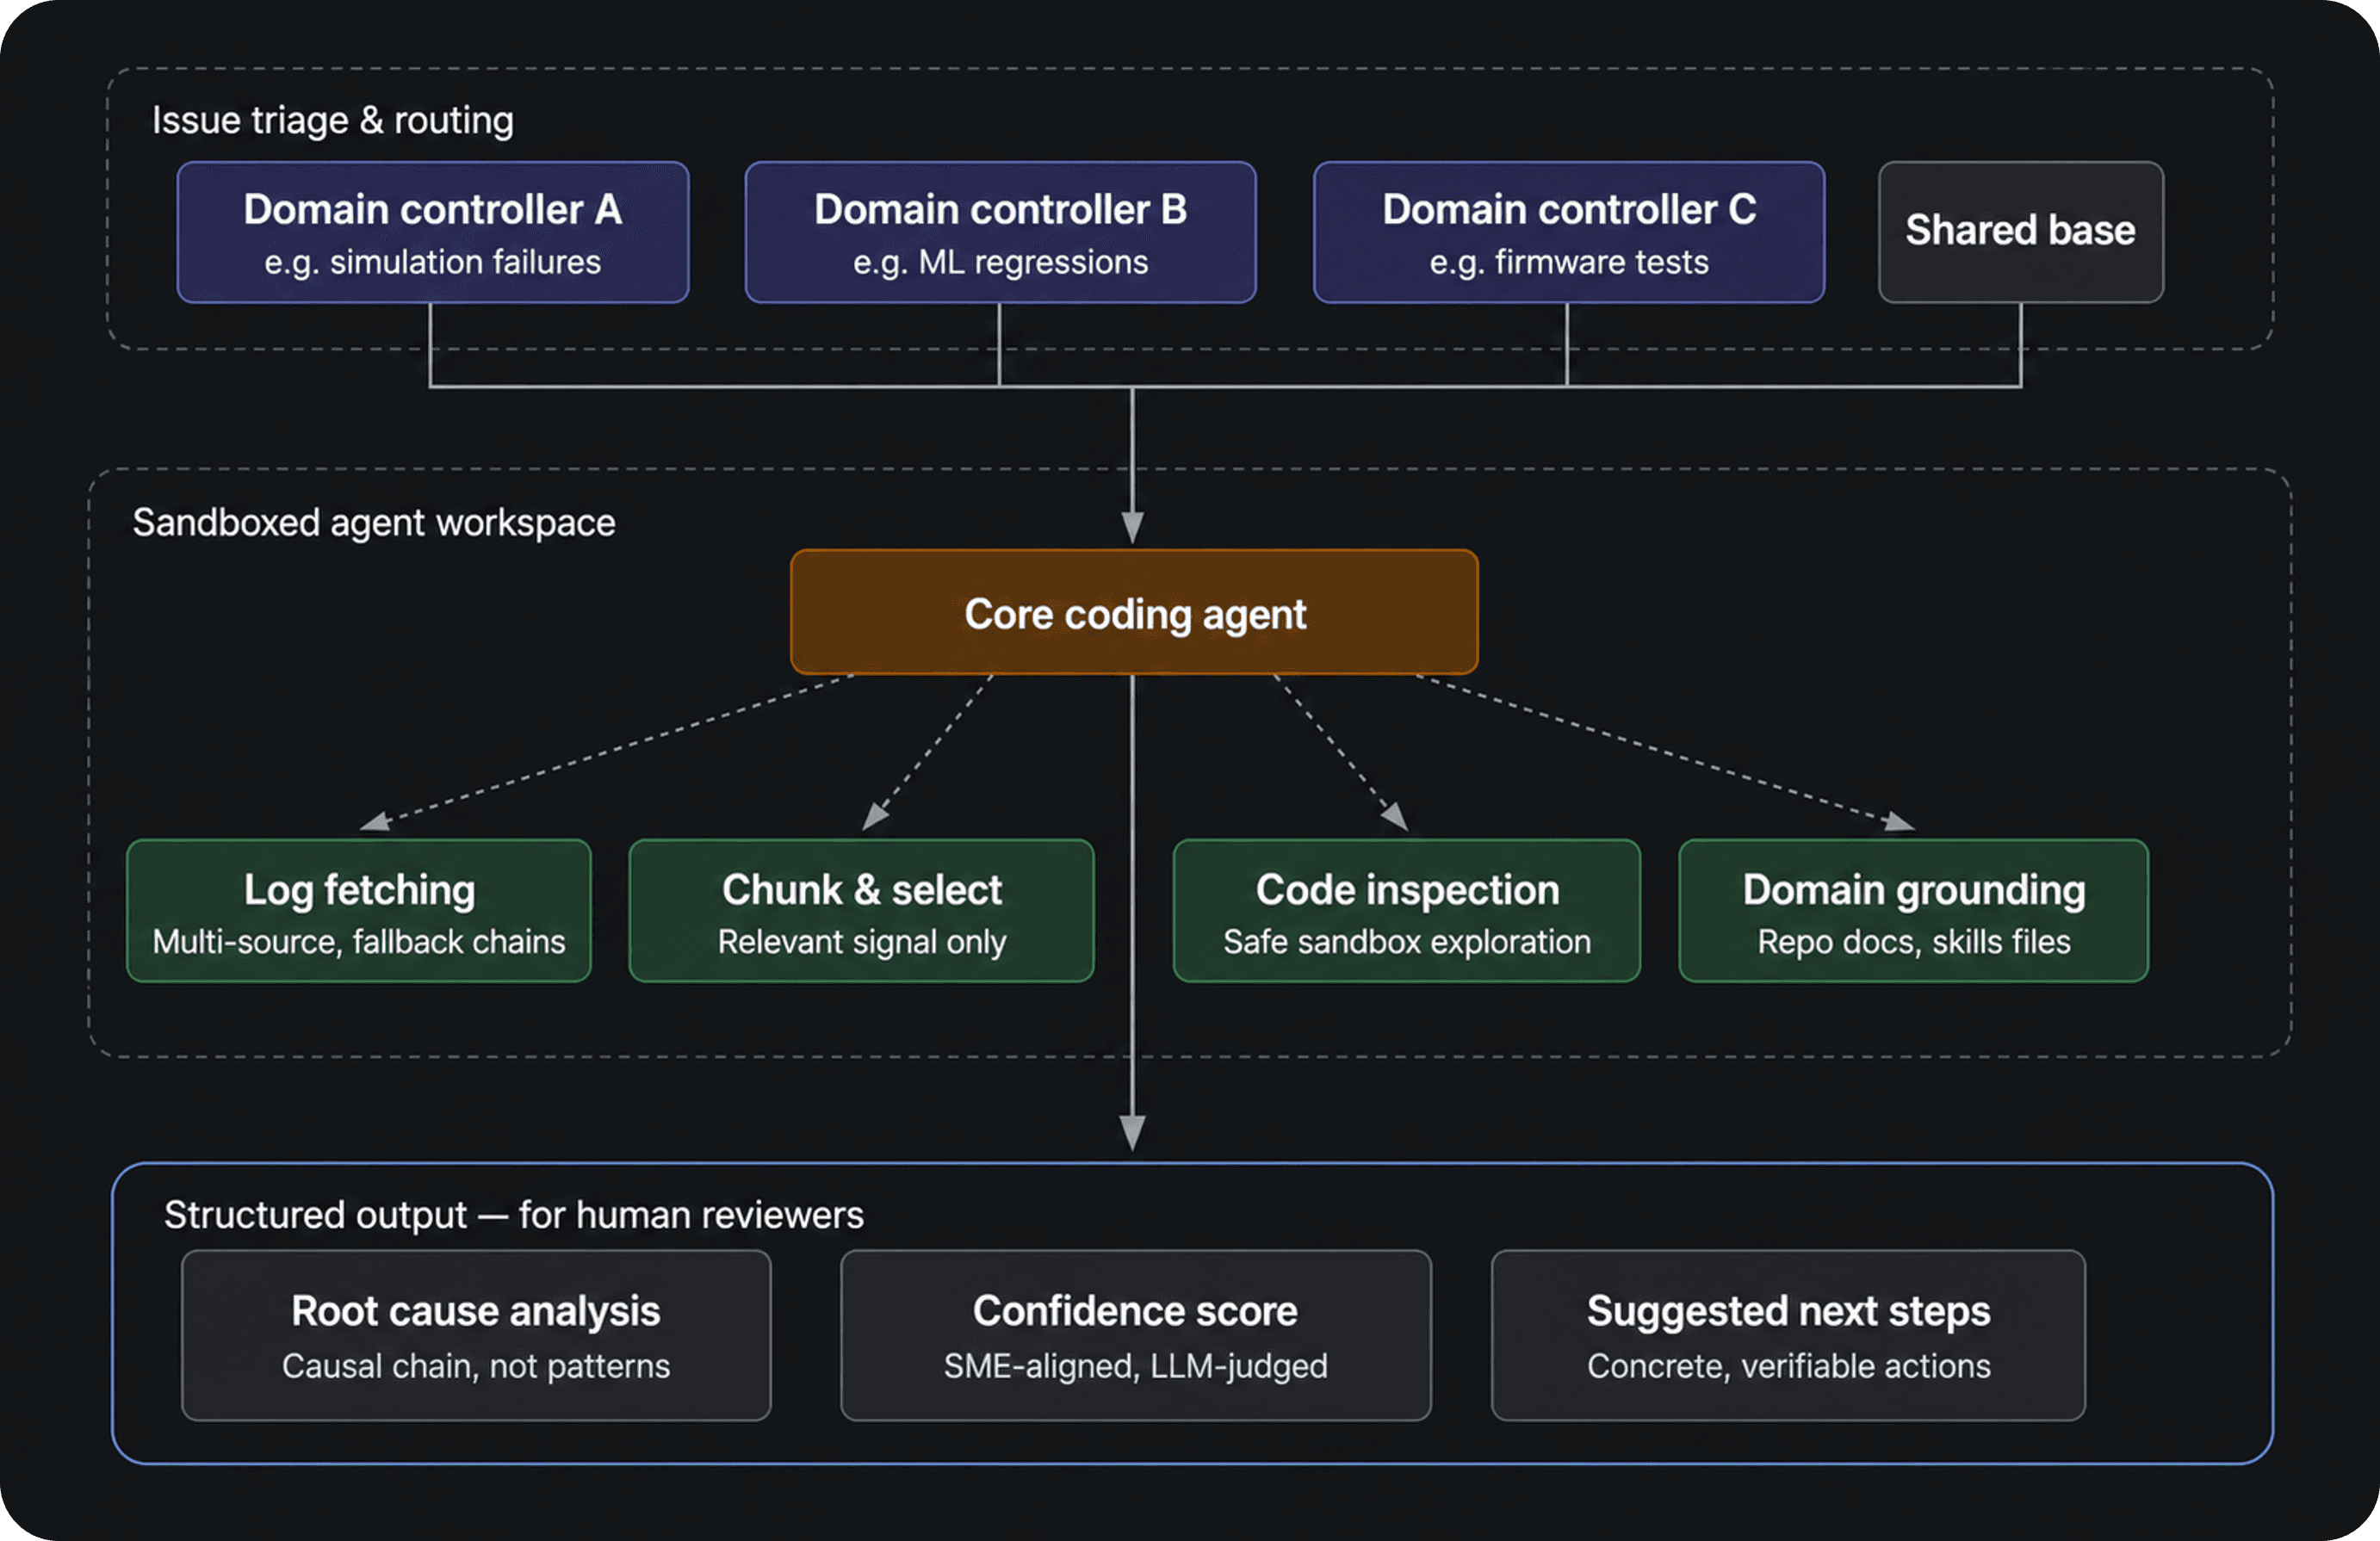
重點並非消除工程判斷,而是為審核人員提供更穩妥的起點。功能倒退分流、PR 審核、測試修復、版本發佈驗證和部署後調查,都具有相同特點。這些工作都涉及大量證據和審核工作,而且往往難以作出明確判斷。它們並非要求智能代理取代工程流程,而只是協助推進流程。
因此,團隊也應審慎考慮如何評估這些系統。
不應問的是智能代理能否單獨產生令人印象深刻的成果;更值得問的是,它能否改善實際工作流程,而不會拖慢其他環節。
這意味要審視輸出是否具體得足以驗證、能否解釋因果關係而非只作模式比對,以及能否令審核更容易而不是更困難。看似合理的答案,不等於實用的答案。實際上,只有當智能代理的輸出經得起仔細審核,並提供具體可核實的內容,團隊才會信任它。
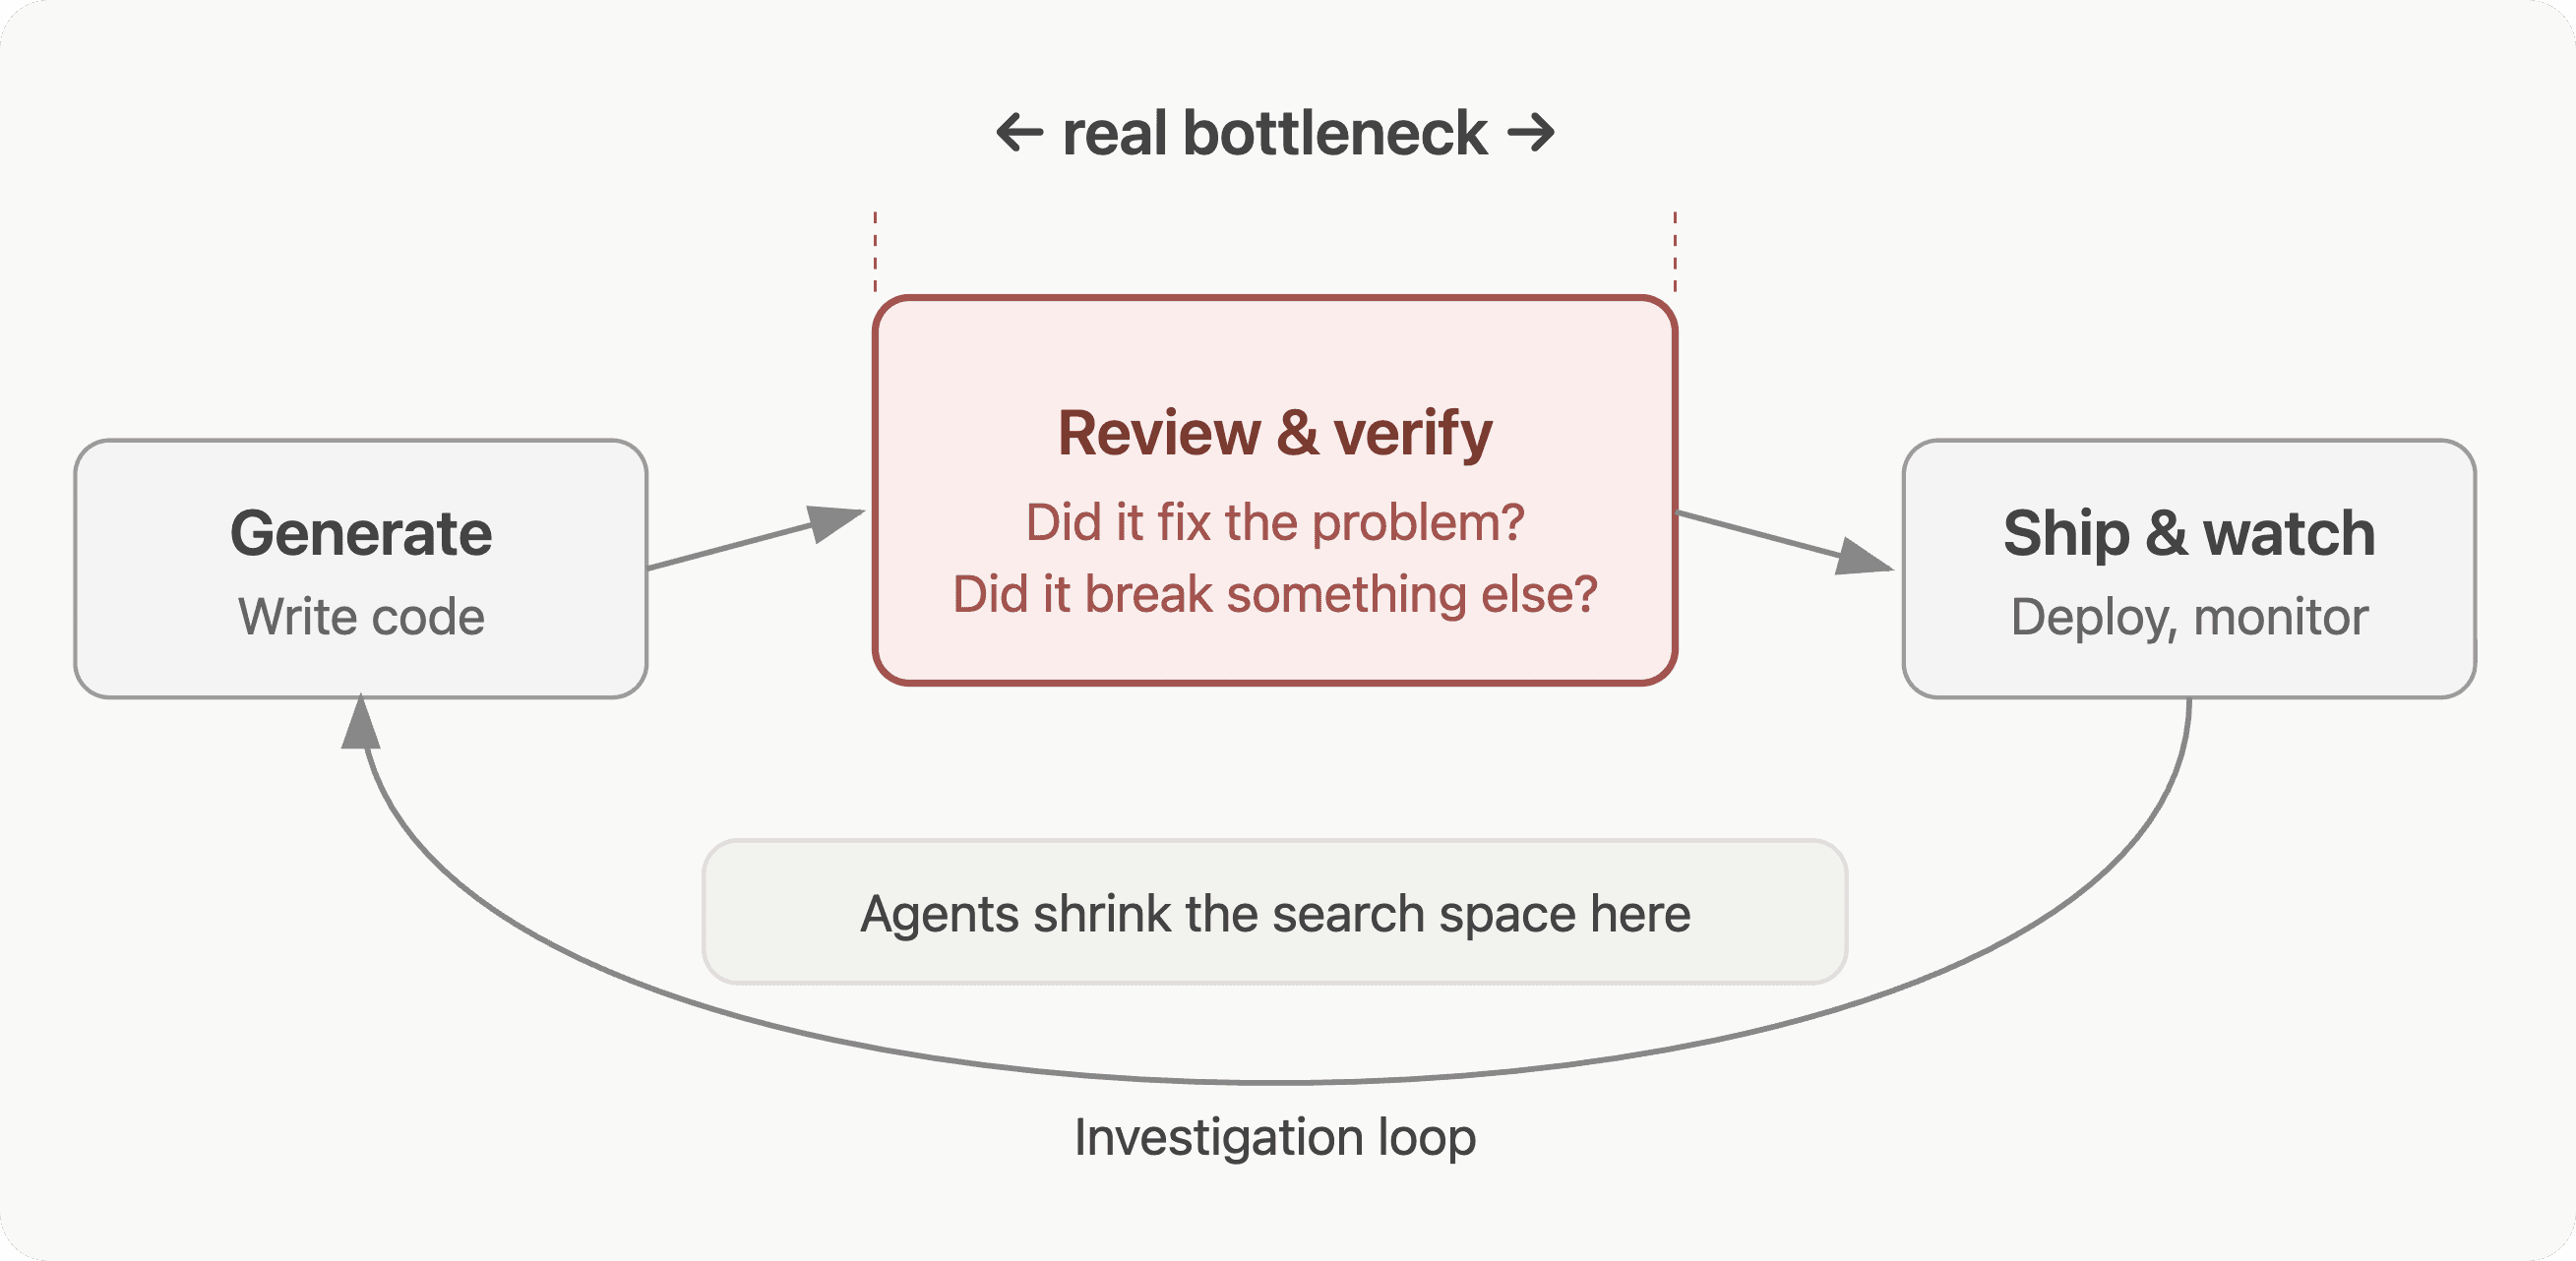
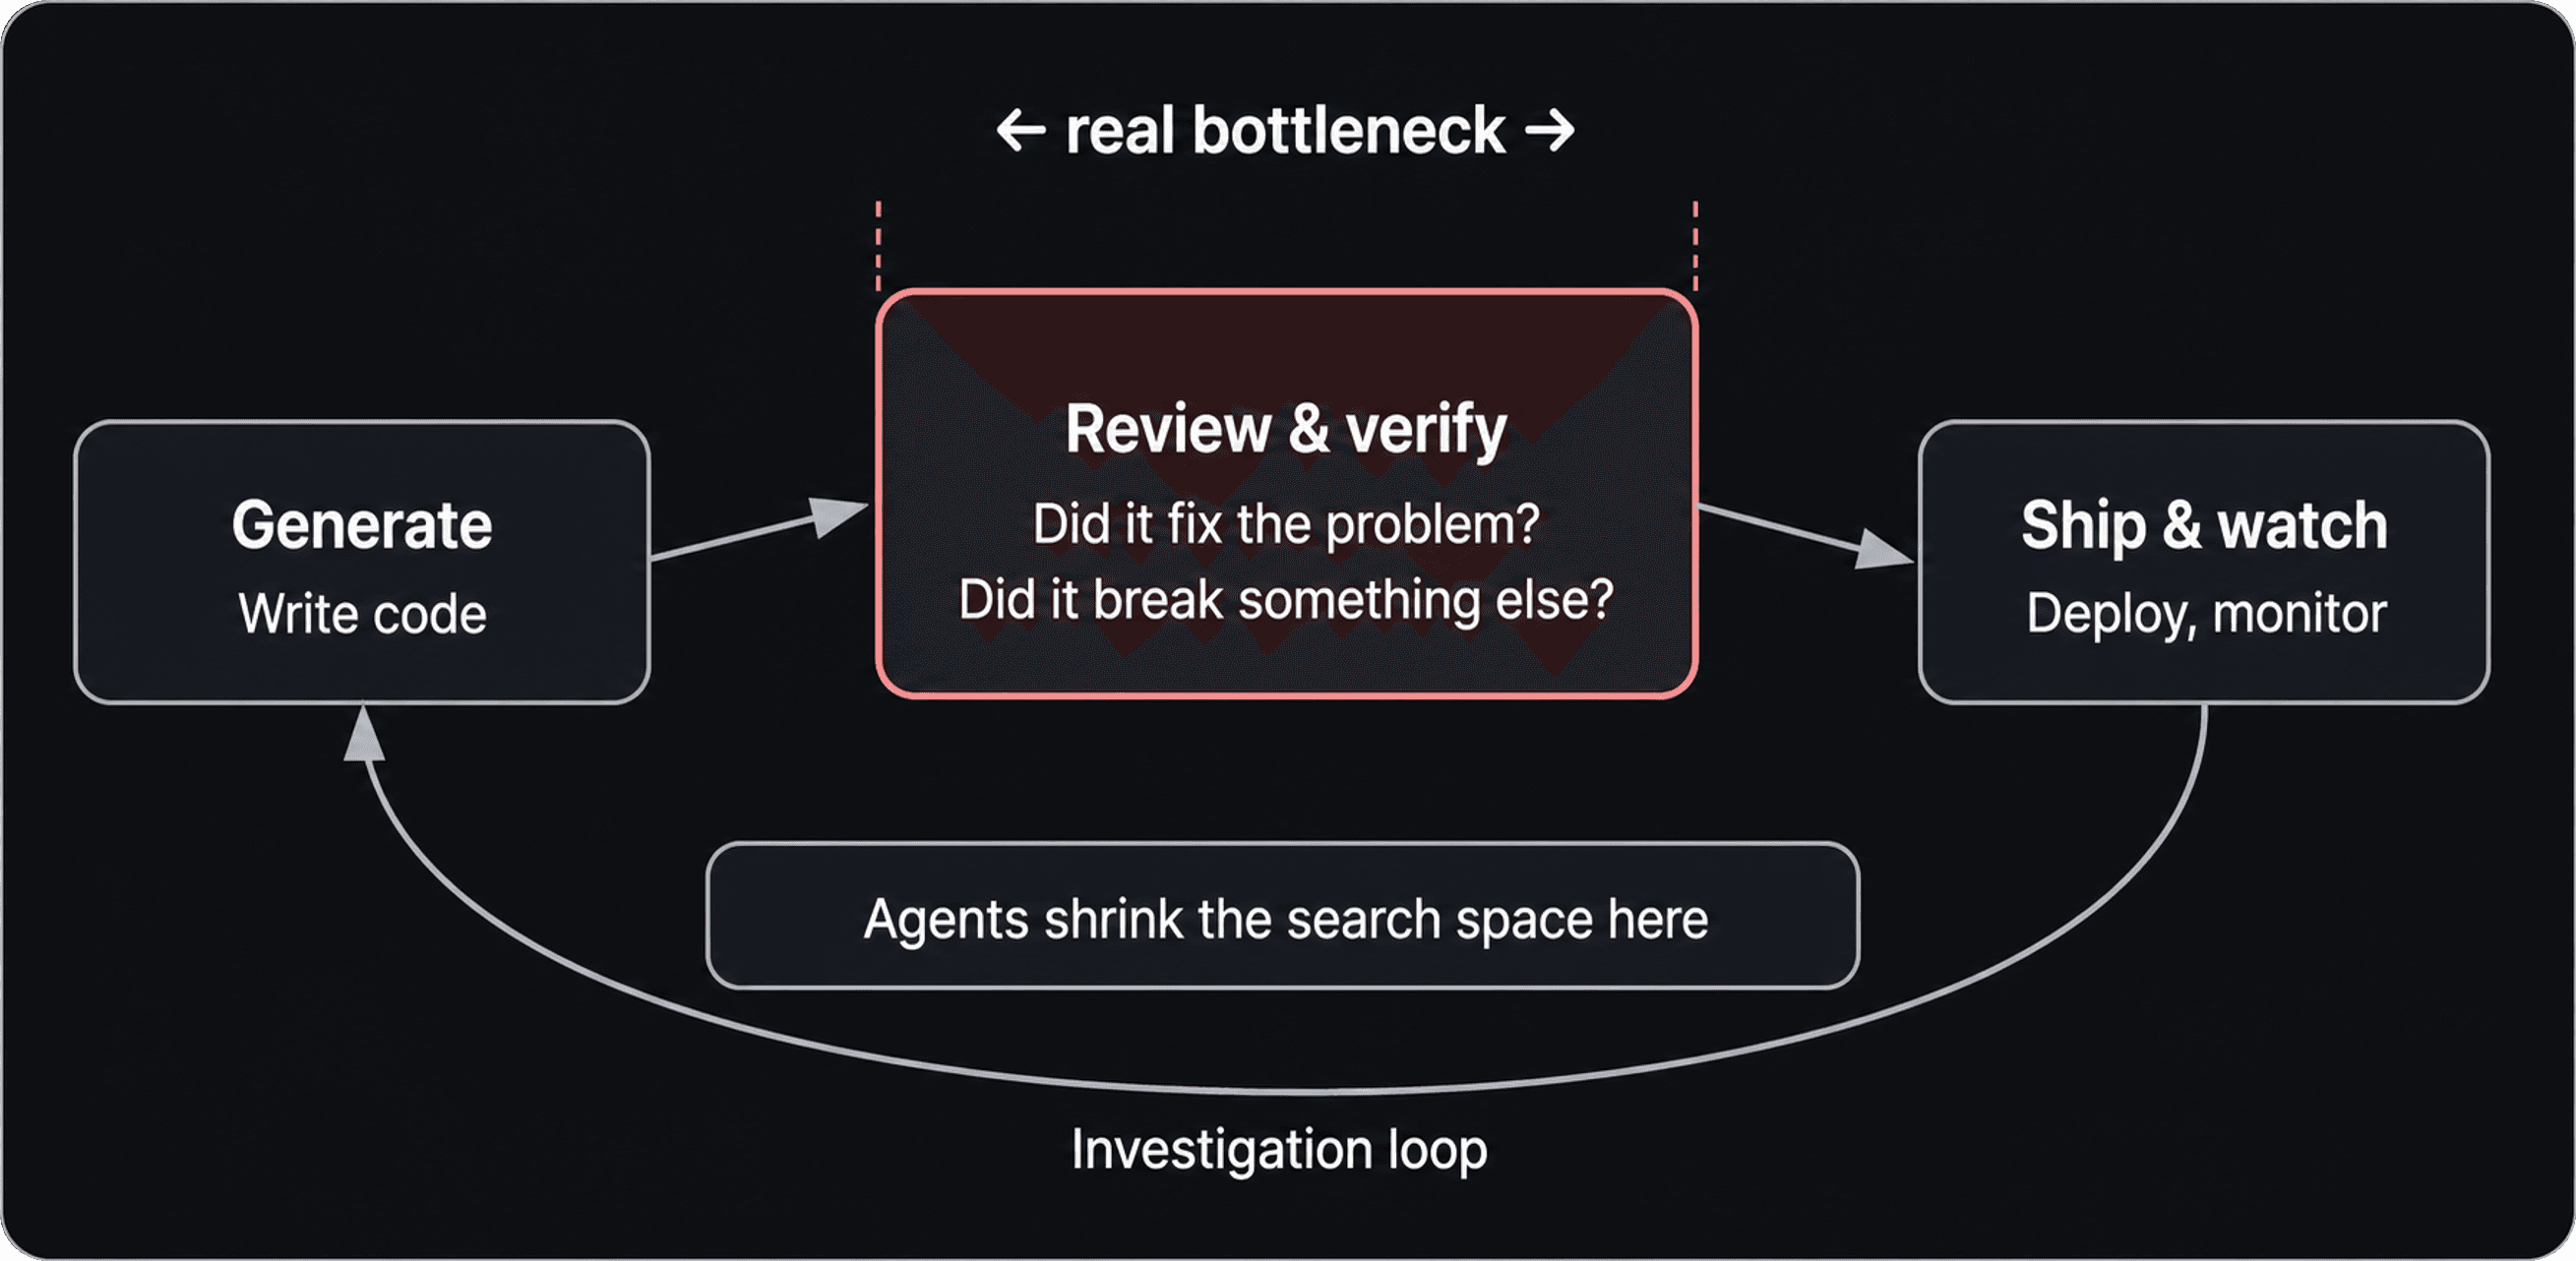
更深一層的啟示是,實用的智能代理式系統不能只依靠生成能力。它們的成效取決於如何收集證據、整合背景資料、核查輸出,以及向審核人員清楚呈現不確定性。
因此,智能代理式工程的近期發展,未必會一步躍進至完全自主運作。更可能的情況是建立一系列設計嚴謹的工作循環,由智能代理協助團隊檢查、審核、驗證和改進工作,減少各步驟之間浪費的工夫。
這或許不及更廣泛的自主運作願景那麼矚目,卻更貼近實用系統實際獲採用的方式。