大多数团队采用智能体编程后,只是将瓶颈从生成环节转移到了审查环节;若不改善这一闭环,整体速度几乎不会提升。
在大规模 CI 环境中(每晚运行数百万项测试,涉及数百名工程师),最有价值的智能体任务不是生成代码,而是确定问题归属并进行分诊。
有用的智能体输出经得起推敲,并能解释因果关系,而不只是匹配模式。
证据收集层和上下文组装层的设计比生成层更重要。
关于智能体编程的大多数讨论,仍始于一个简单的承诺:更快地编写更多代码。
有时,这一承诺会扩展为更宏大的愿景:由智能体规划工作、发起 PR,并在尽量减少人工干预的情况下发布变更。但对大多数工程团队而言,近期最明确的价值要具体得多。那就是降低迭代成本。
软件交付不只是代码生成。编写代码只是一个漫长闭环中的一个阶段;这个闭环还包括审查、测试、部署,以及出现问题时的调查。大多数团队采用智能体编程时,如果不重新设计审查闭环,只会把瓶颈转移到下游。
仅仅加快生成速度,并不会自然而然地提高团队速度。这可能只会让团队在审查、验证和建立信任上投入更多精力。
在许多工程环境中,代价高昂的不是产出初稿,而是建立足够的信心。
这项变更是否真的解决了问题或改进了系统?它是否在其他地方引入了回归问题?故障究竟出在代码、环境、测试还是依赖项?建议的修复方案是在解决根本原因,还是只处理了表面症状?
智能体可以在这方面提供帮助,不是因为它们能取代工程师,而是因为它们能对杂乱的证据进行结构化的初步分析:检查日志、比较近期变更、汇总相关信号、追溯可能原因、运行检查,并给出可供人类深入查证的结果。
对许多团队而言,最能发挥杠杆作用的智能体用途并不是从头生成代码。而是在人工耗费数小时手动排查之前,先缩小问题的搜索范围。
这一点在大规模调试工作流中尤其明显。设想一下,每晚的 CI 都要对数百名工程师参与修改的代码库运行数百万项测试(我们的一位客户正面临这种实际情况)。一旦出现故障,要确定问题归属并不容易。问题可能出在应用代码、某个依赖项、测试执行框架,也可能出在技术栈的其他位置。日志可能多达数 GB,而最先发现问题的团队未必就是负责该问题的团队。
这类工作流并不适合直接让单个智能体编写修复方案。它更适合能迅速缩小问题范围的系统。
一套实用的流程可以获取日志、筛选相关证据、总结关键信息、在沙箱中检查代码,并生成结构化的根因分析,同时提供置信度评分、可追溯信息和后续步骤建议。为了生成置信度评分,领域专家会对智能体的初始输出进行标注。随后将标注结果输入作为裁判的 LLM,以便日后自动评分,同时保持与人工判断一致。
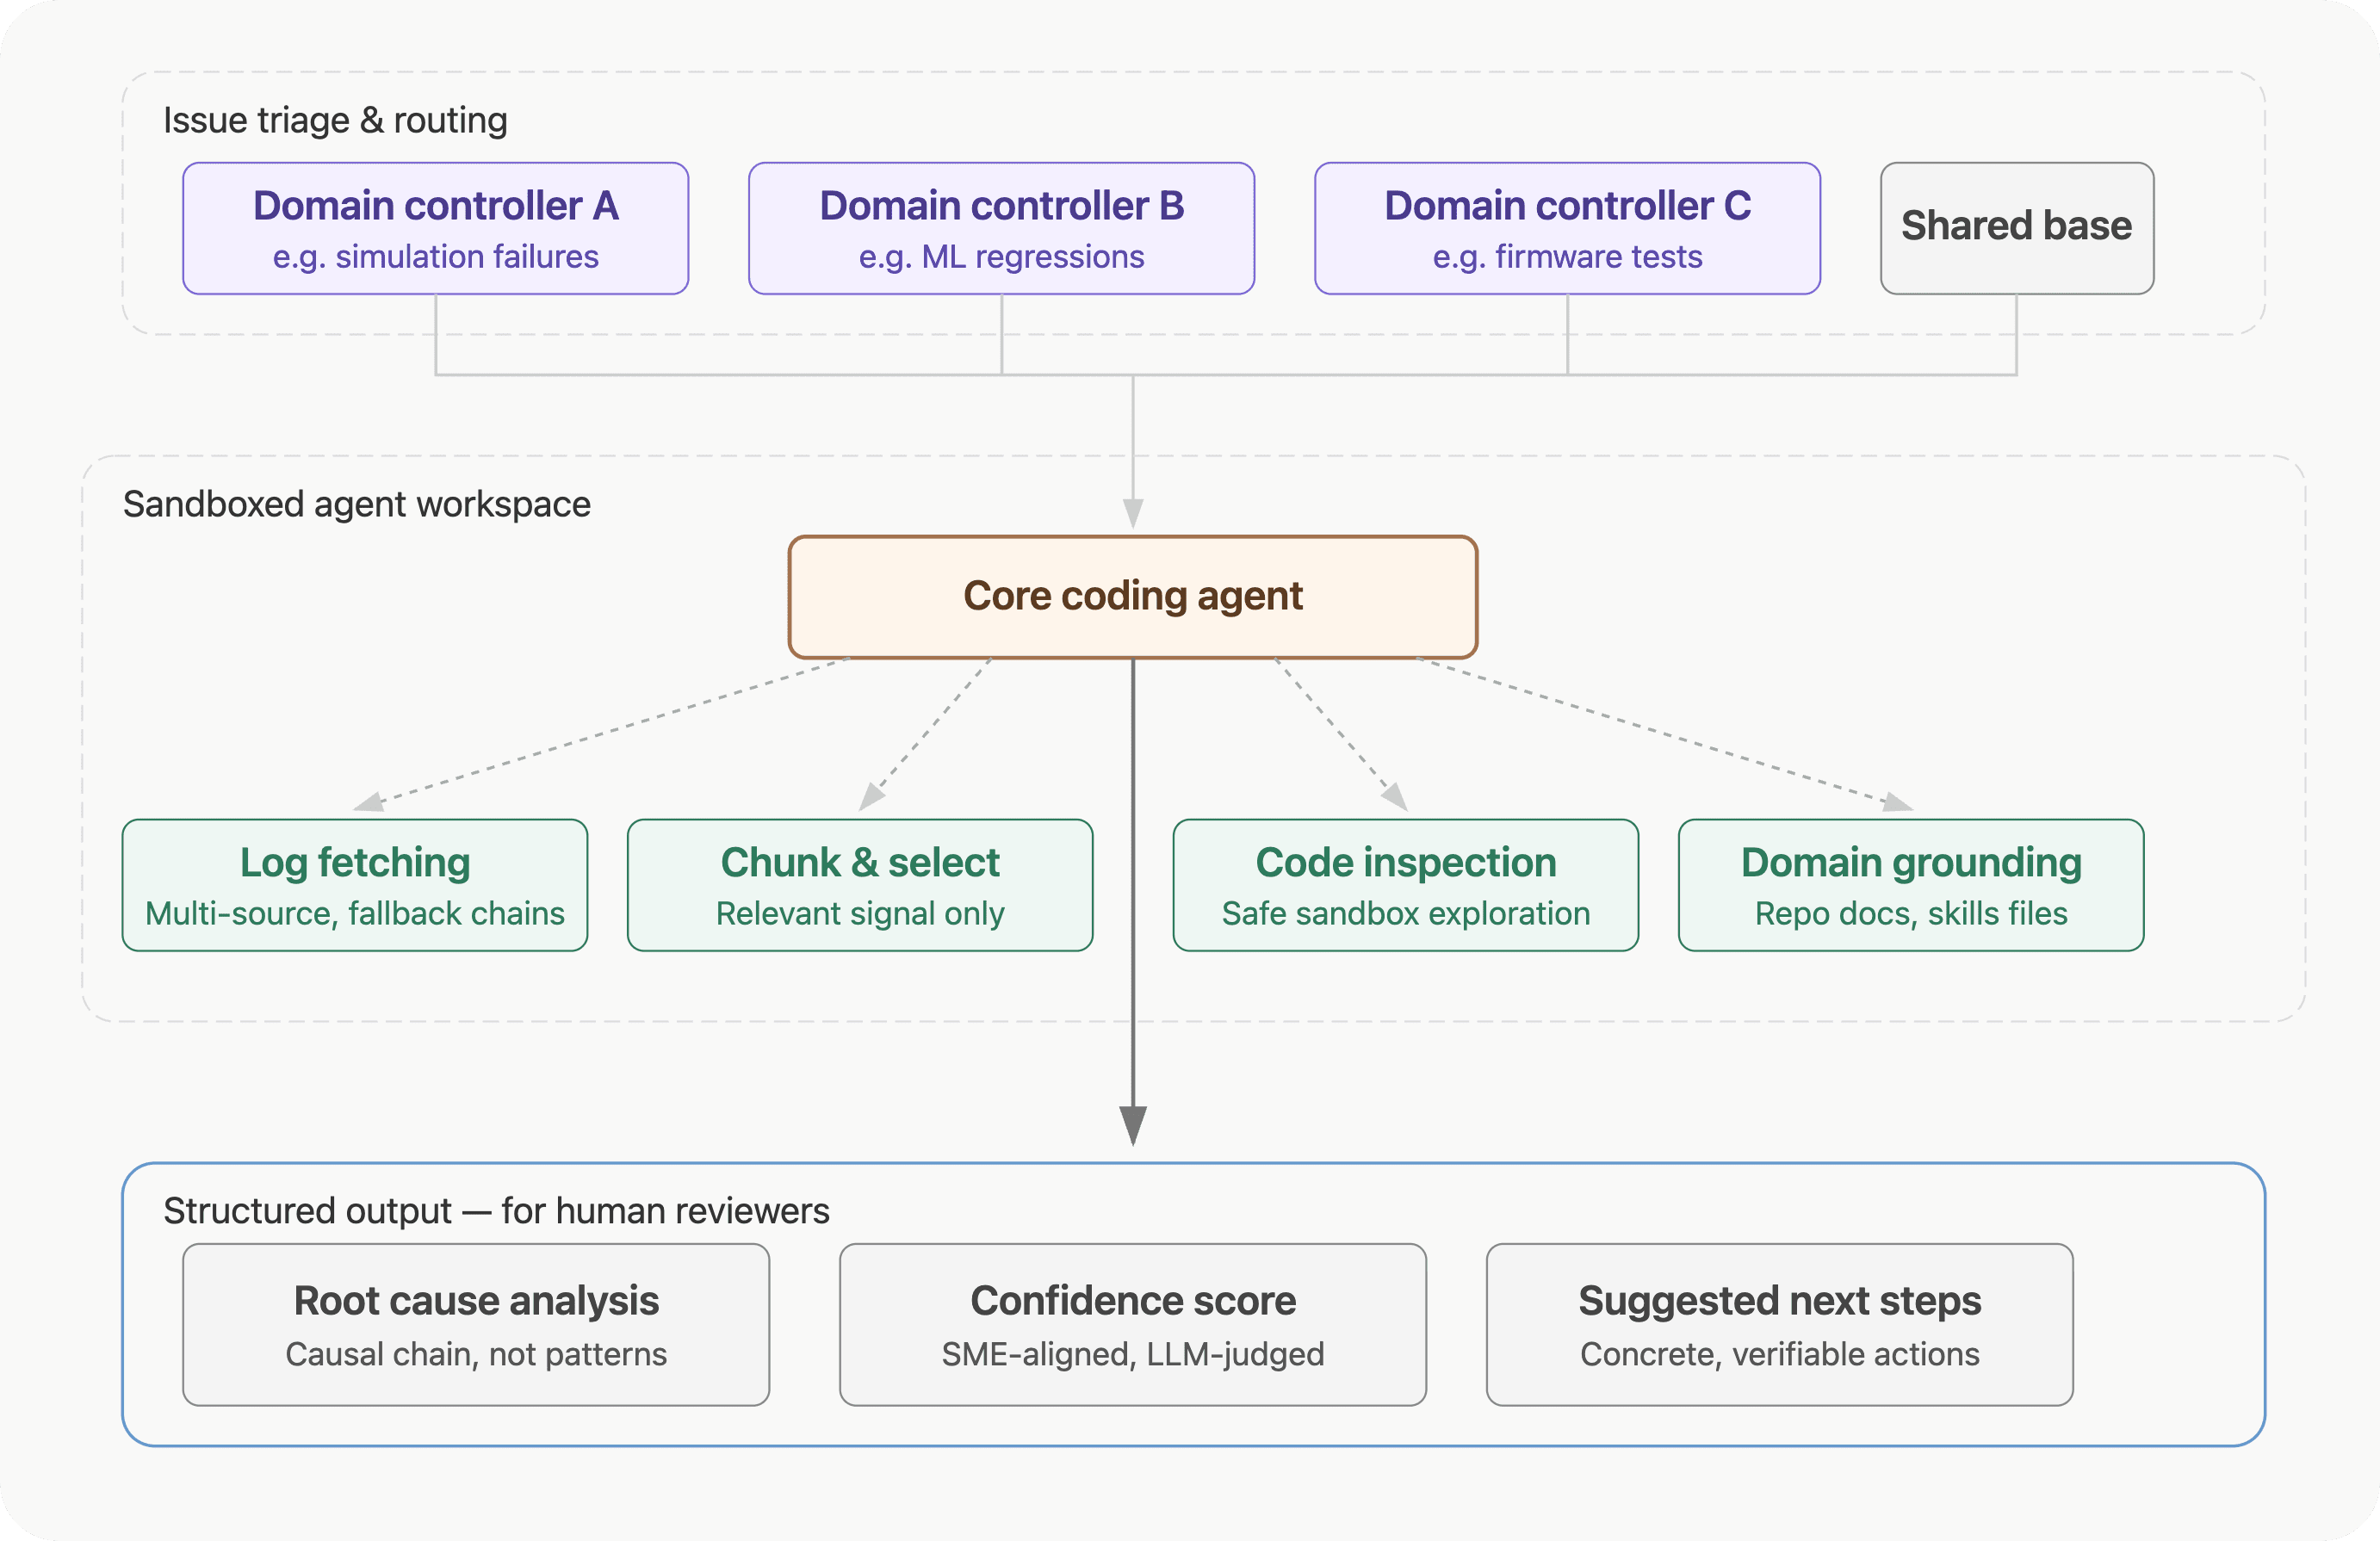
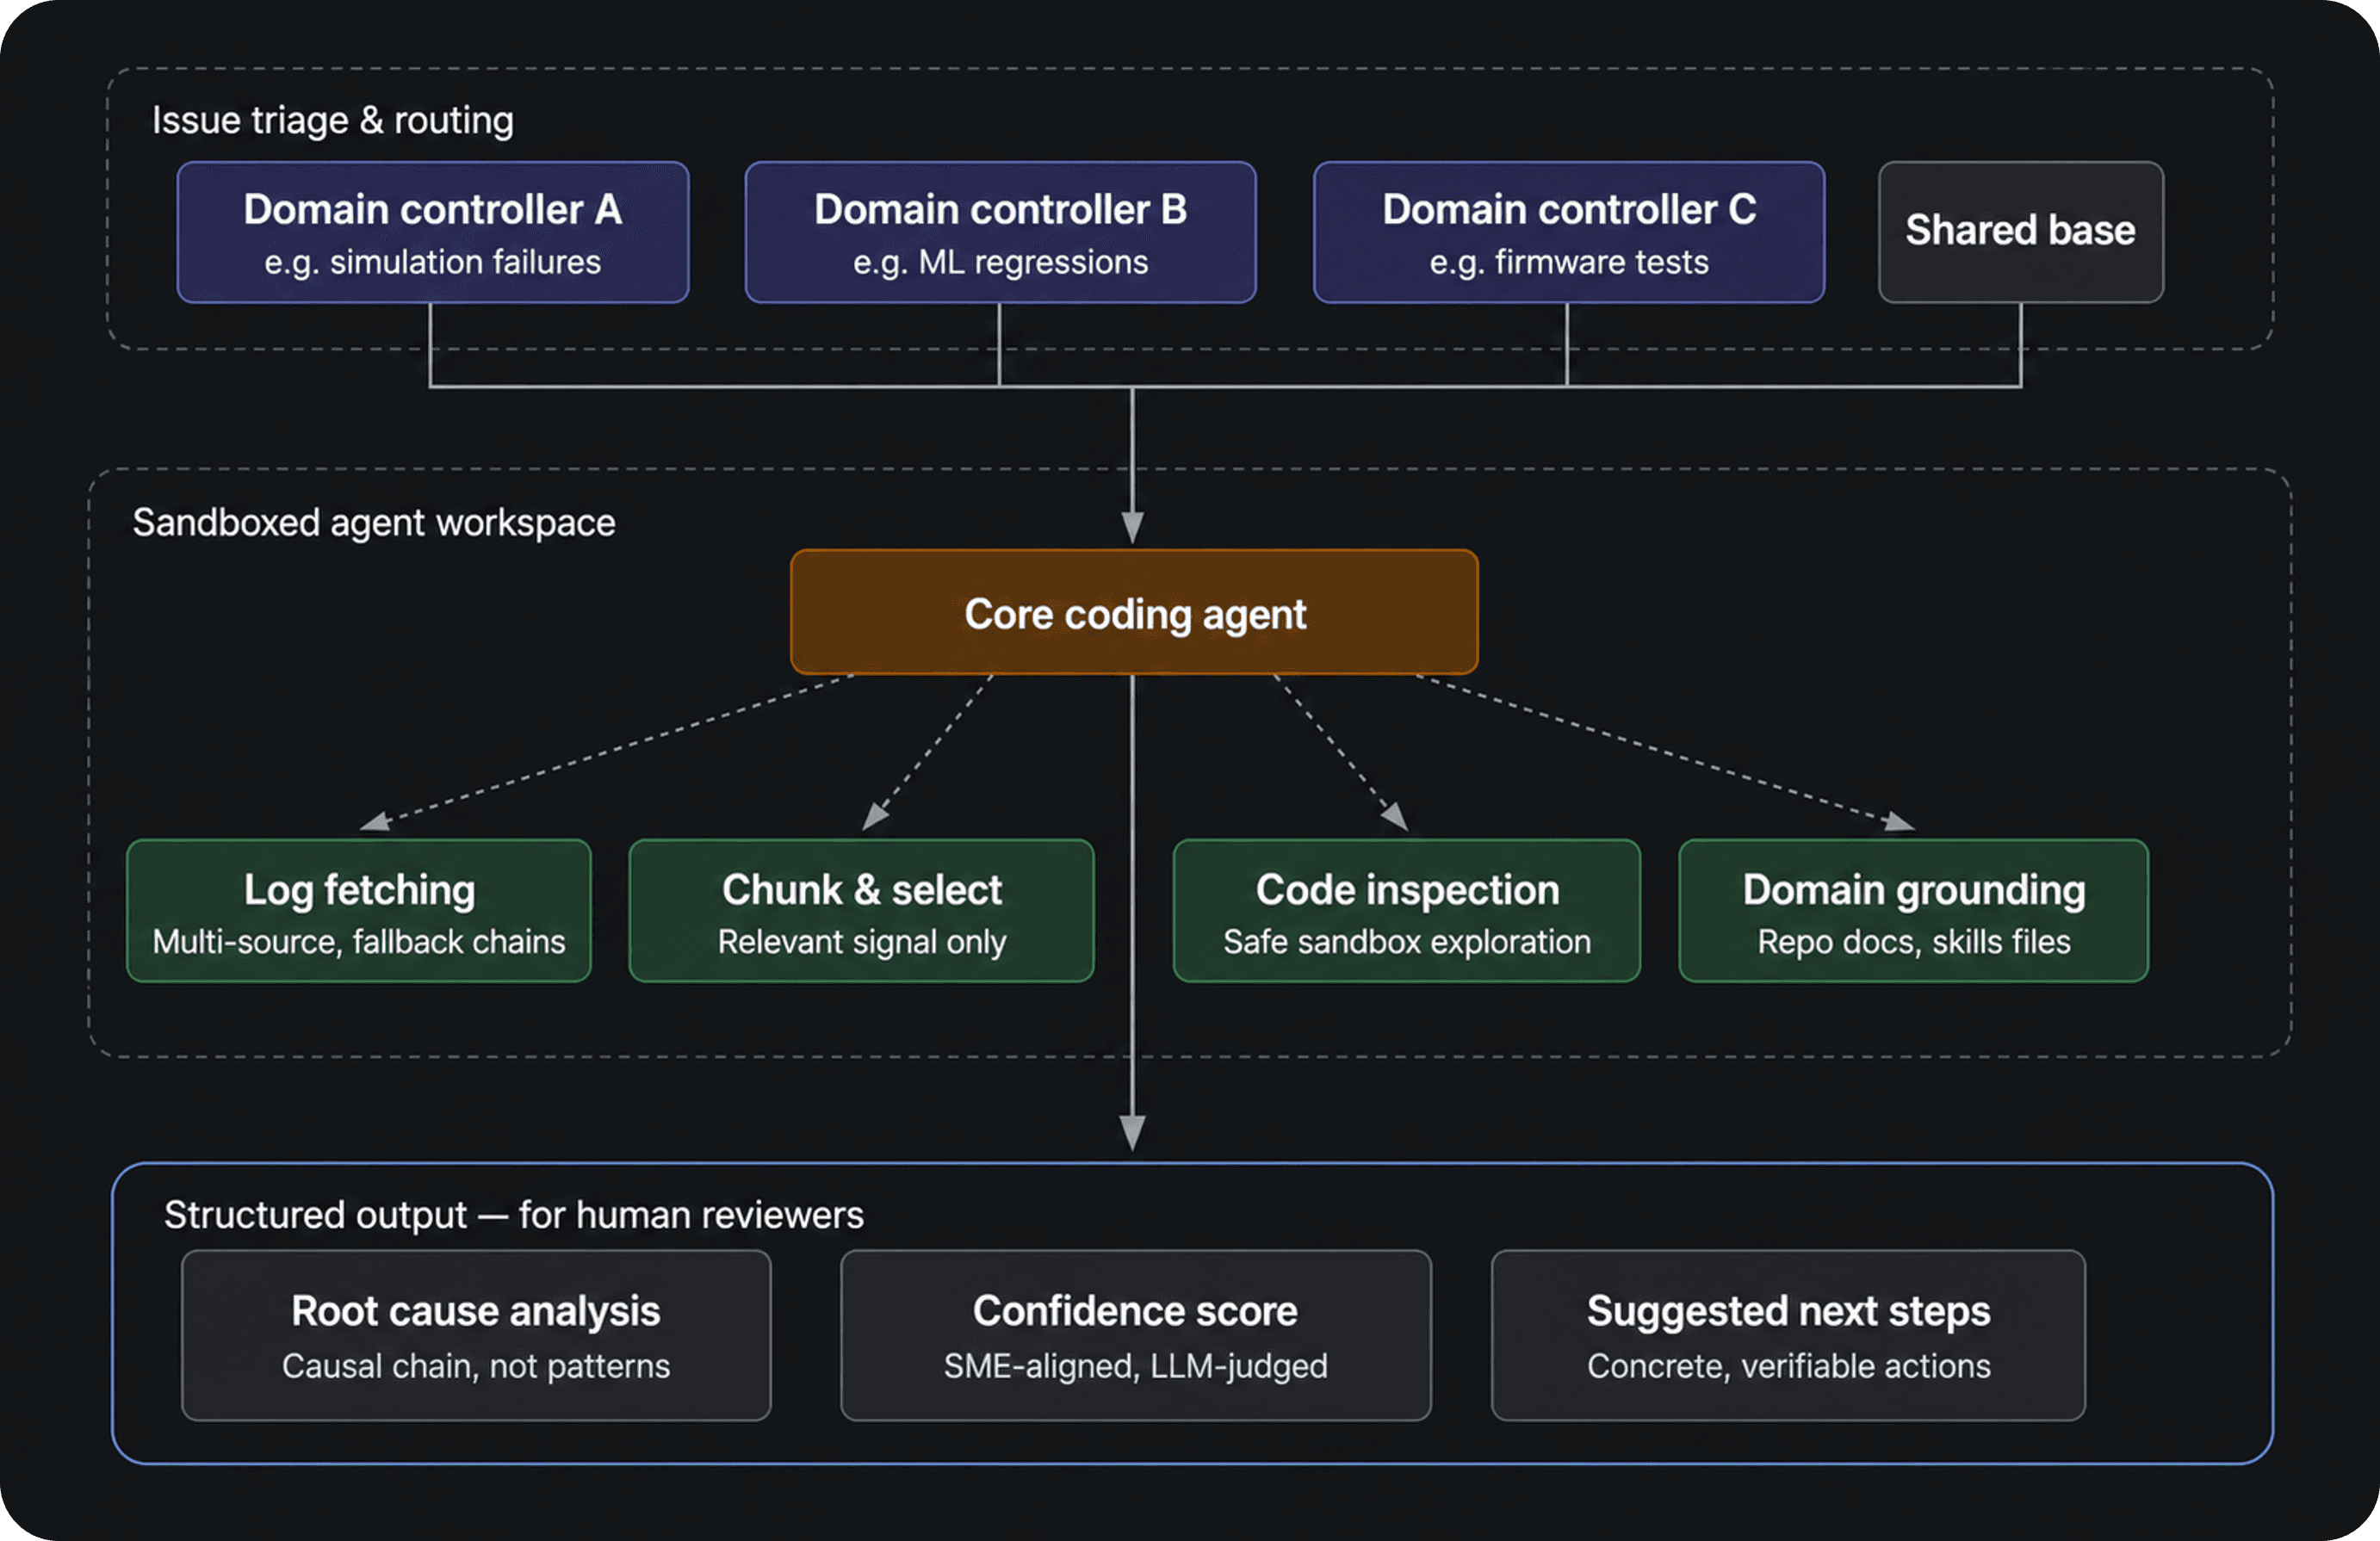
其目的不是消除工程判断,而是为审查人员提供更可靠的起点。回归问题分诊、PR 审查、测试修复、发布验证和部署后调查都有相同的特点。这些工作都高度依赖证据和审查,并且充满不确定性。它们并不要求智能体取代工程流程,只需要智能体帮助推动流程向前。
这也说明了团队为何应谨慎选择评估这些系统的方式。
不该问智能体能否独立产出令人惊叹的成果。更应该问的是,它能否改善真实的工作流,又不会在其他环节增加阻力。
这意味着需要判断输出是否足够具体、便于验证,是否解释了因果关系而不只是匹配模式,以及它让审查变得更容易还是更困难。看似合理的答案不等于有用的答案。实践中,只有当智能体输出经得起推敲,并提供了可供具体核查的内容时,团队才会信任它。
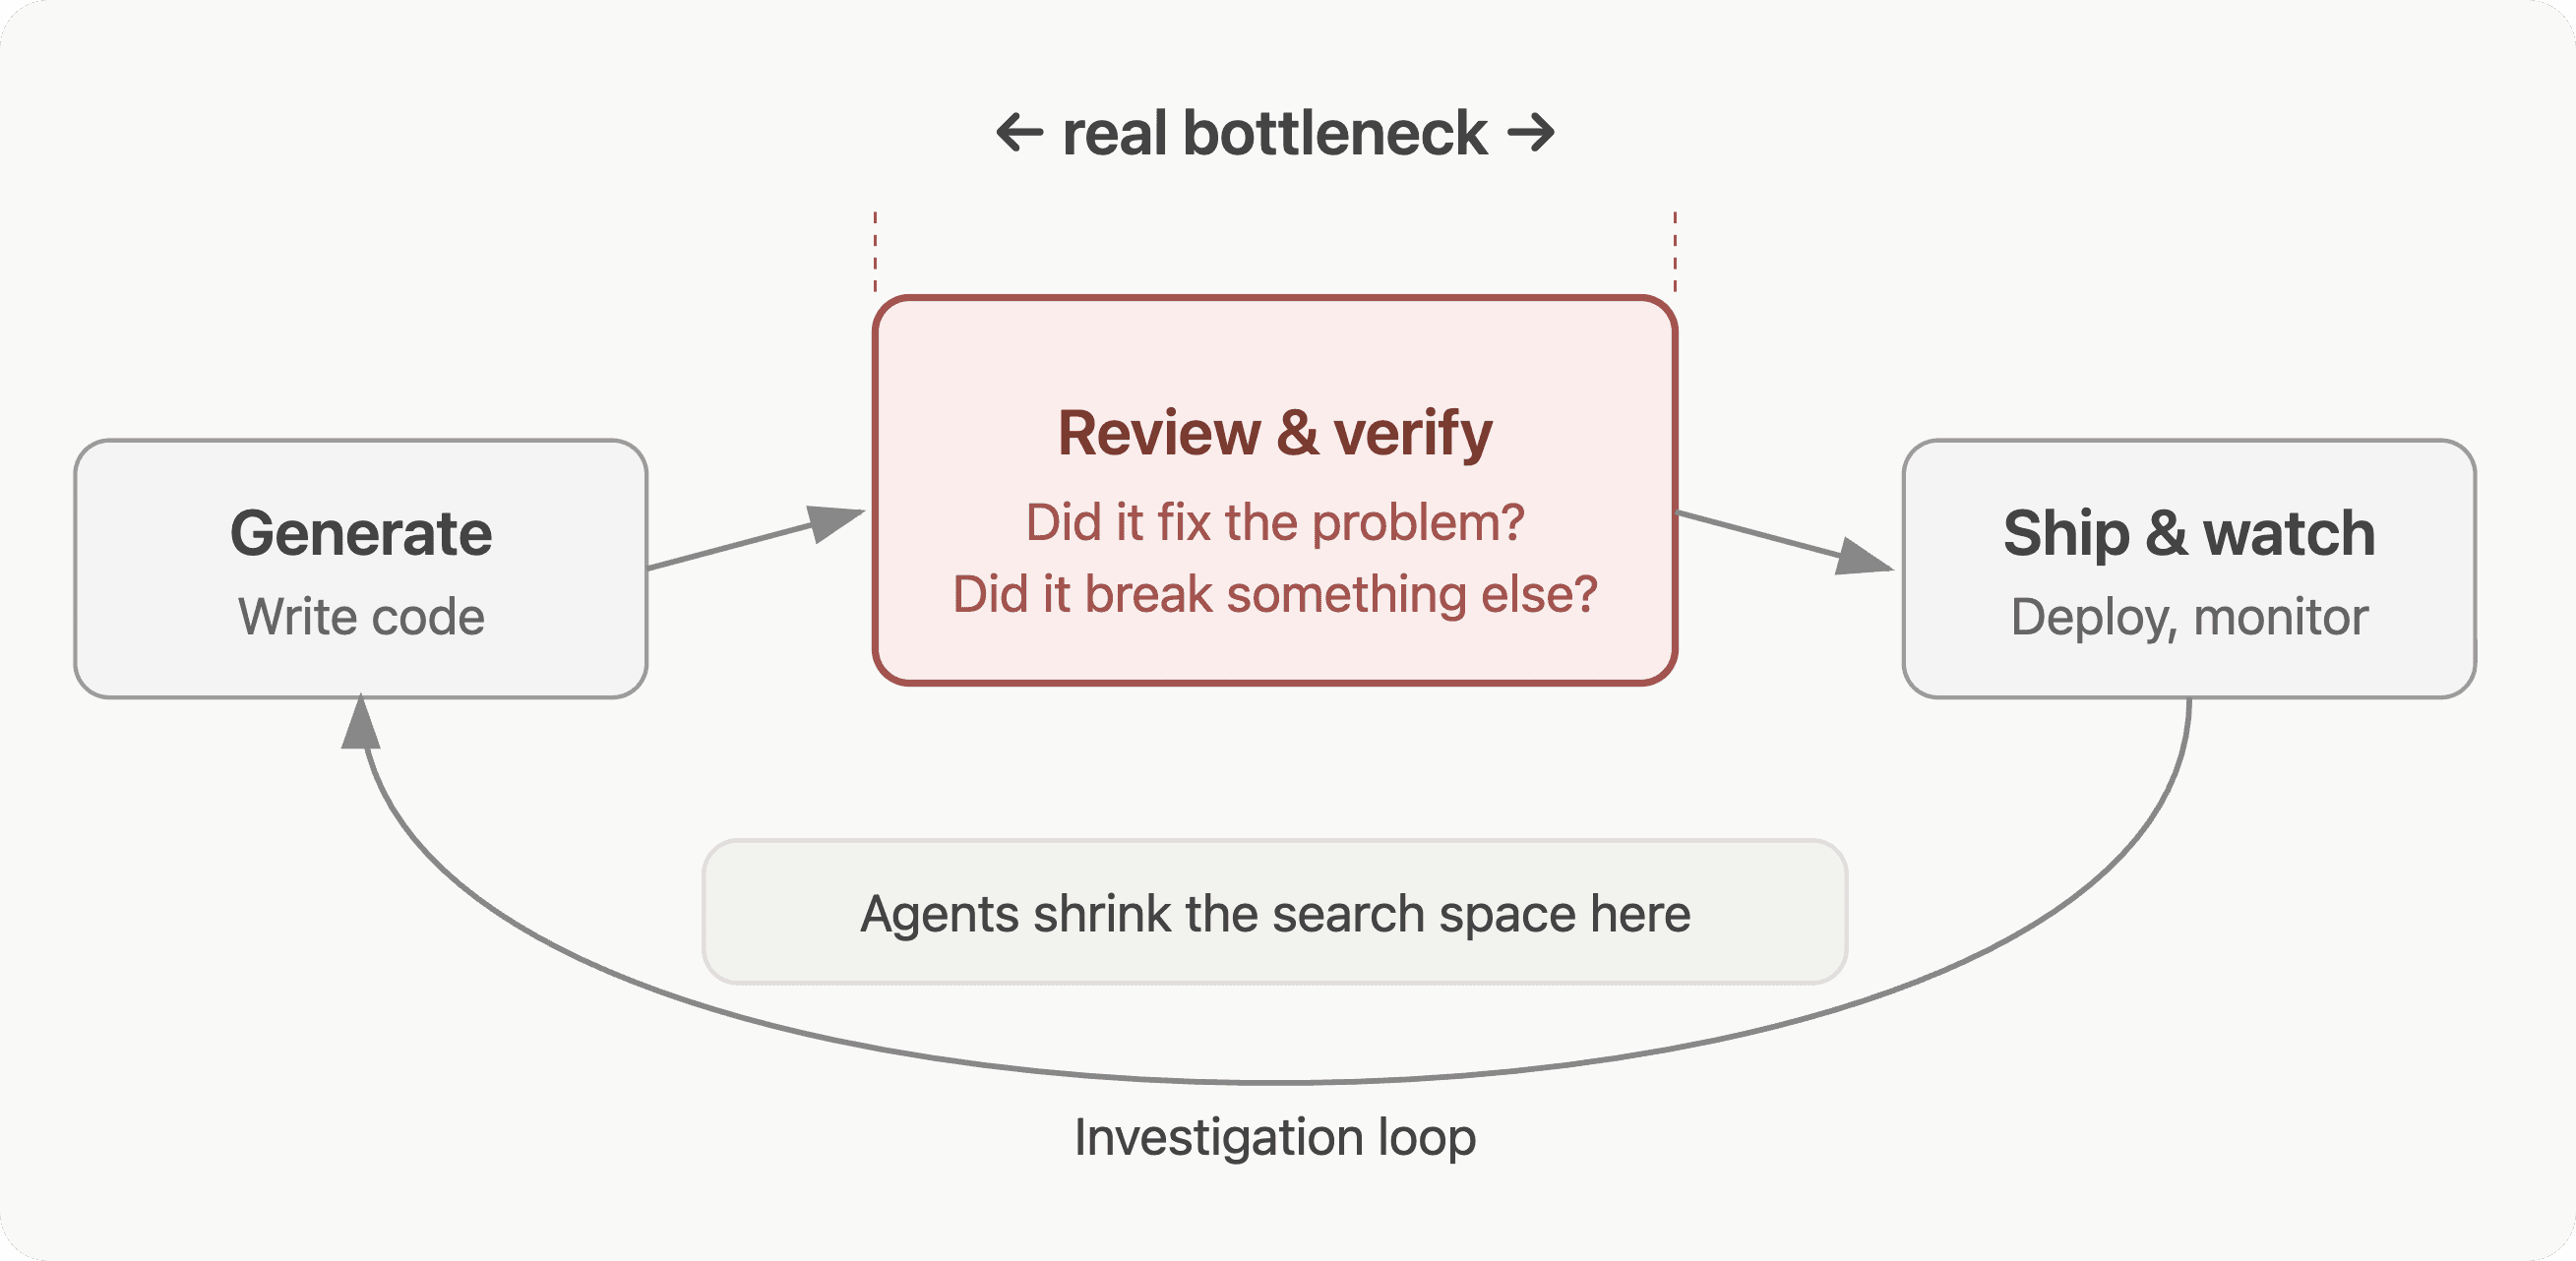
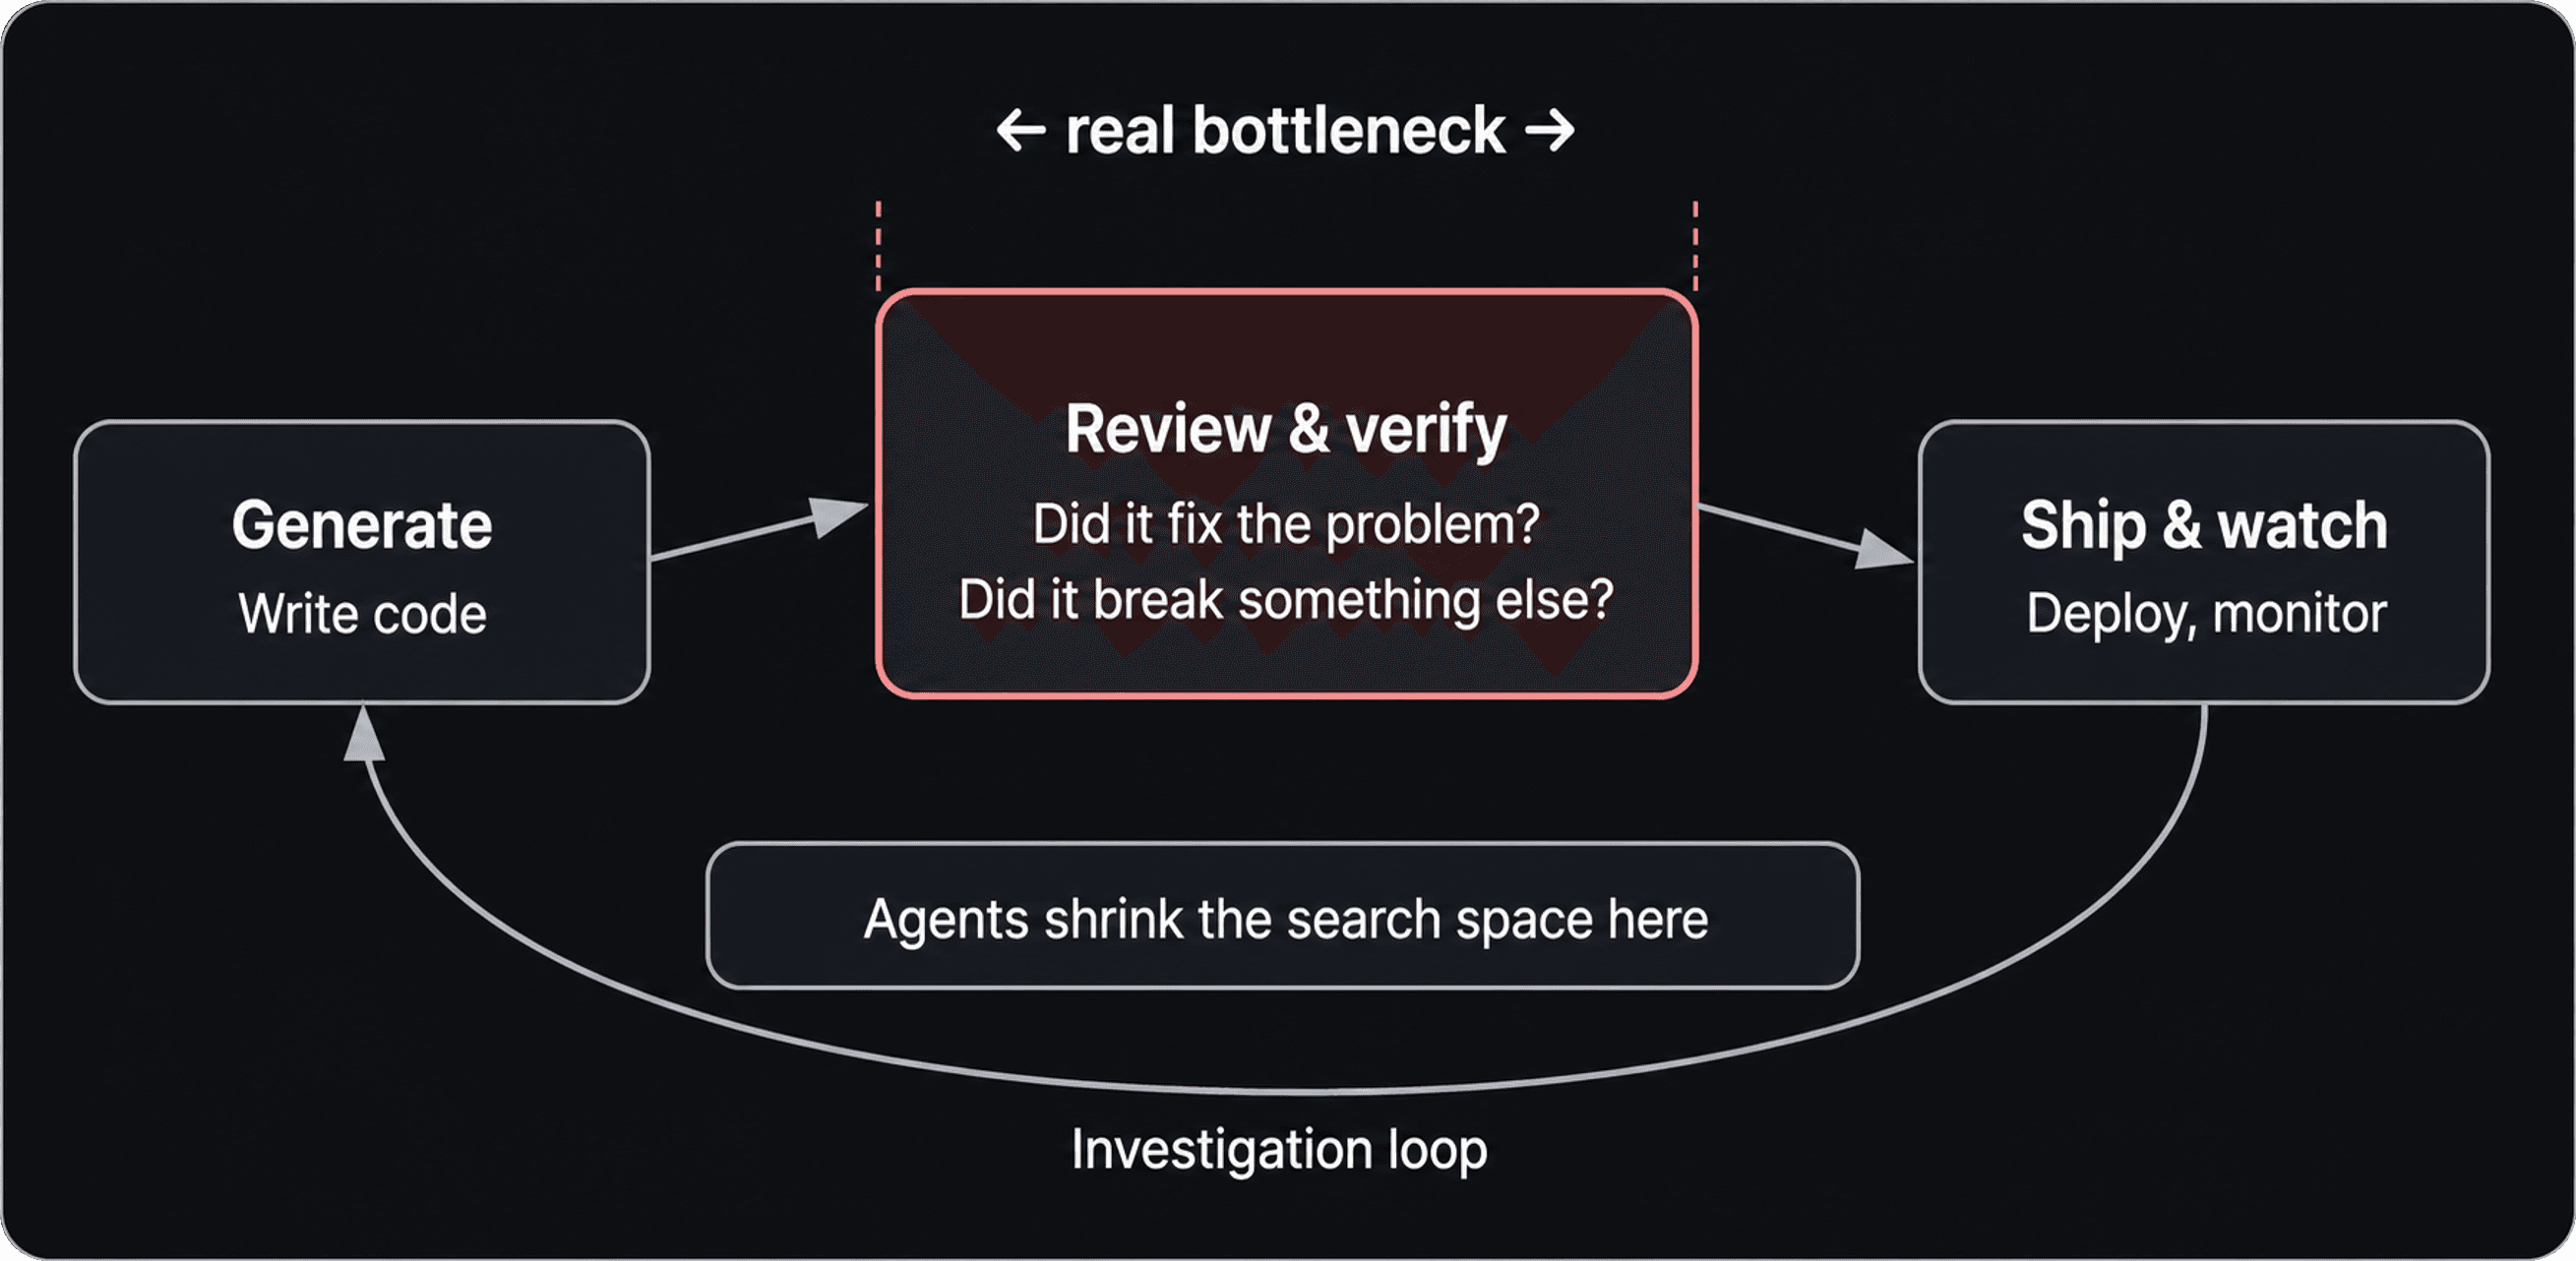
更深层的启示是,实用的智能体系统不能只依赖生成能力。它还取决于如何收集证据、组装上下文、检查输出,以及如何向审查人员呈现不确定性。
正因如此,智能体工程的近期未来不太可能通过一次巨大飞跃直接实现完全自主。更可能出现的是一系列经过严密设计的闭环,让智能体帮助团队检查、审查、验证和完善工作,减少各步骤之间浪费的精力。
这或许不像宏大的自主化愿景那么引人注目,却更接近实用系统真正得到采用的方式。