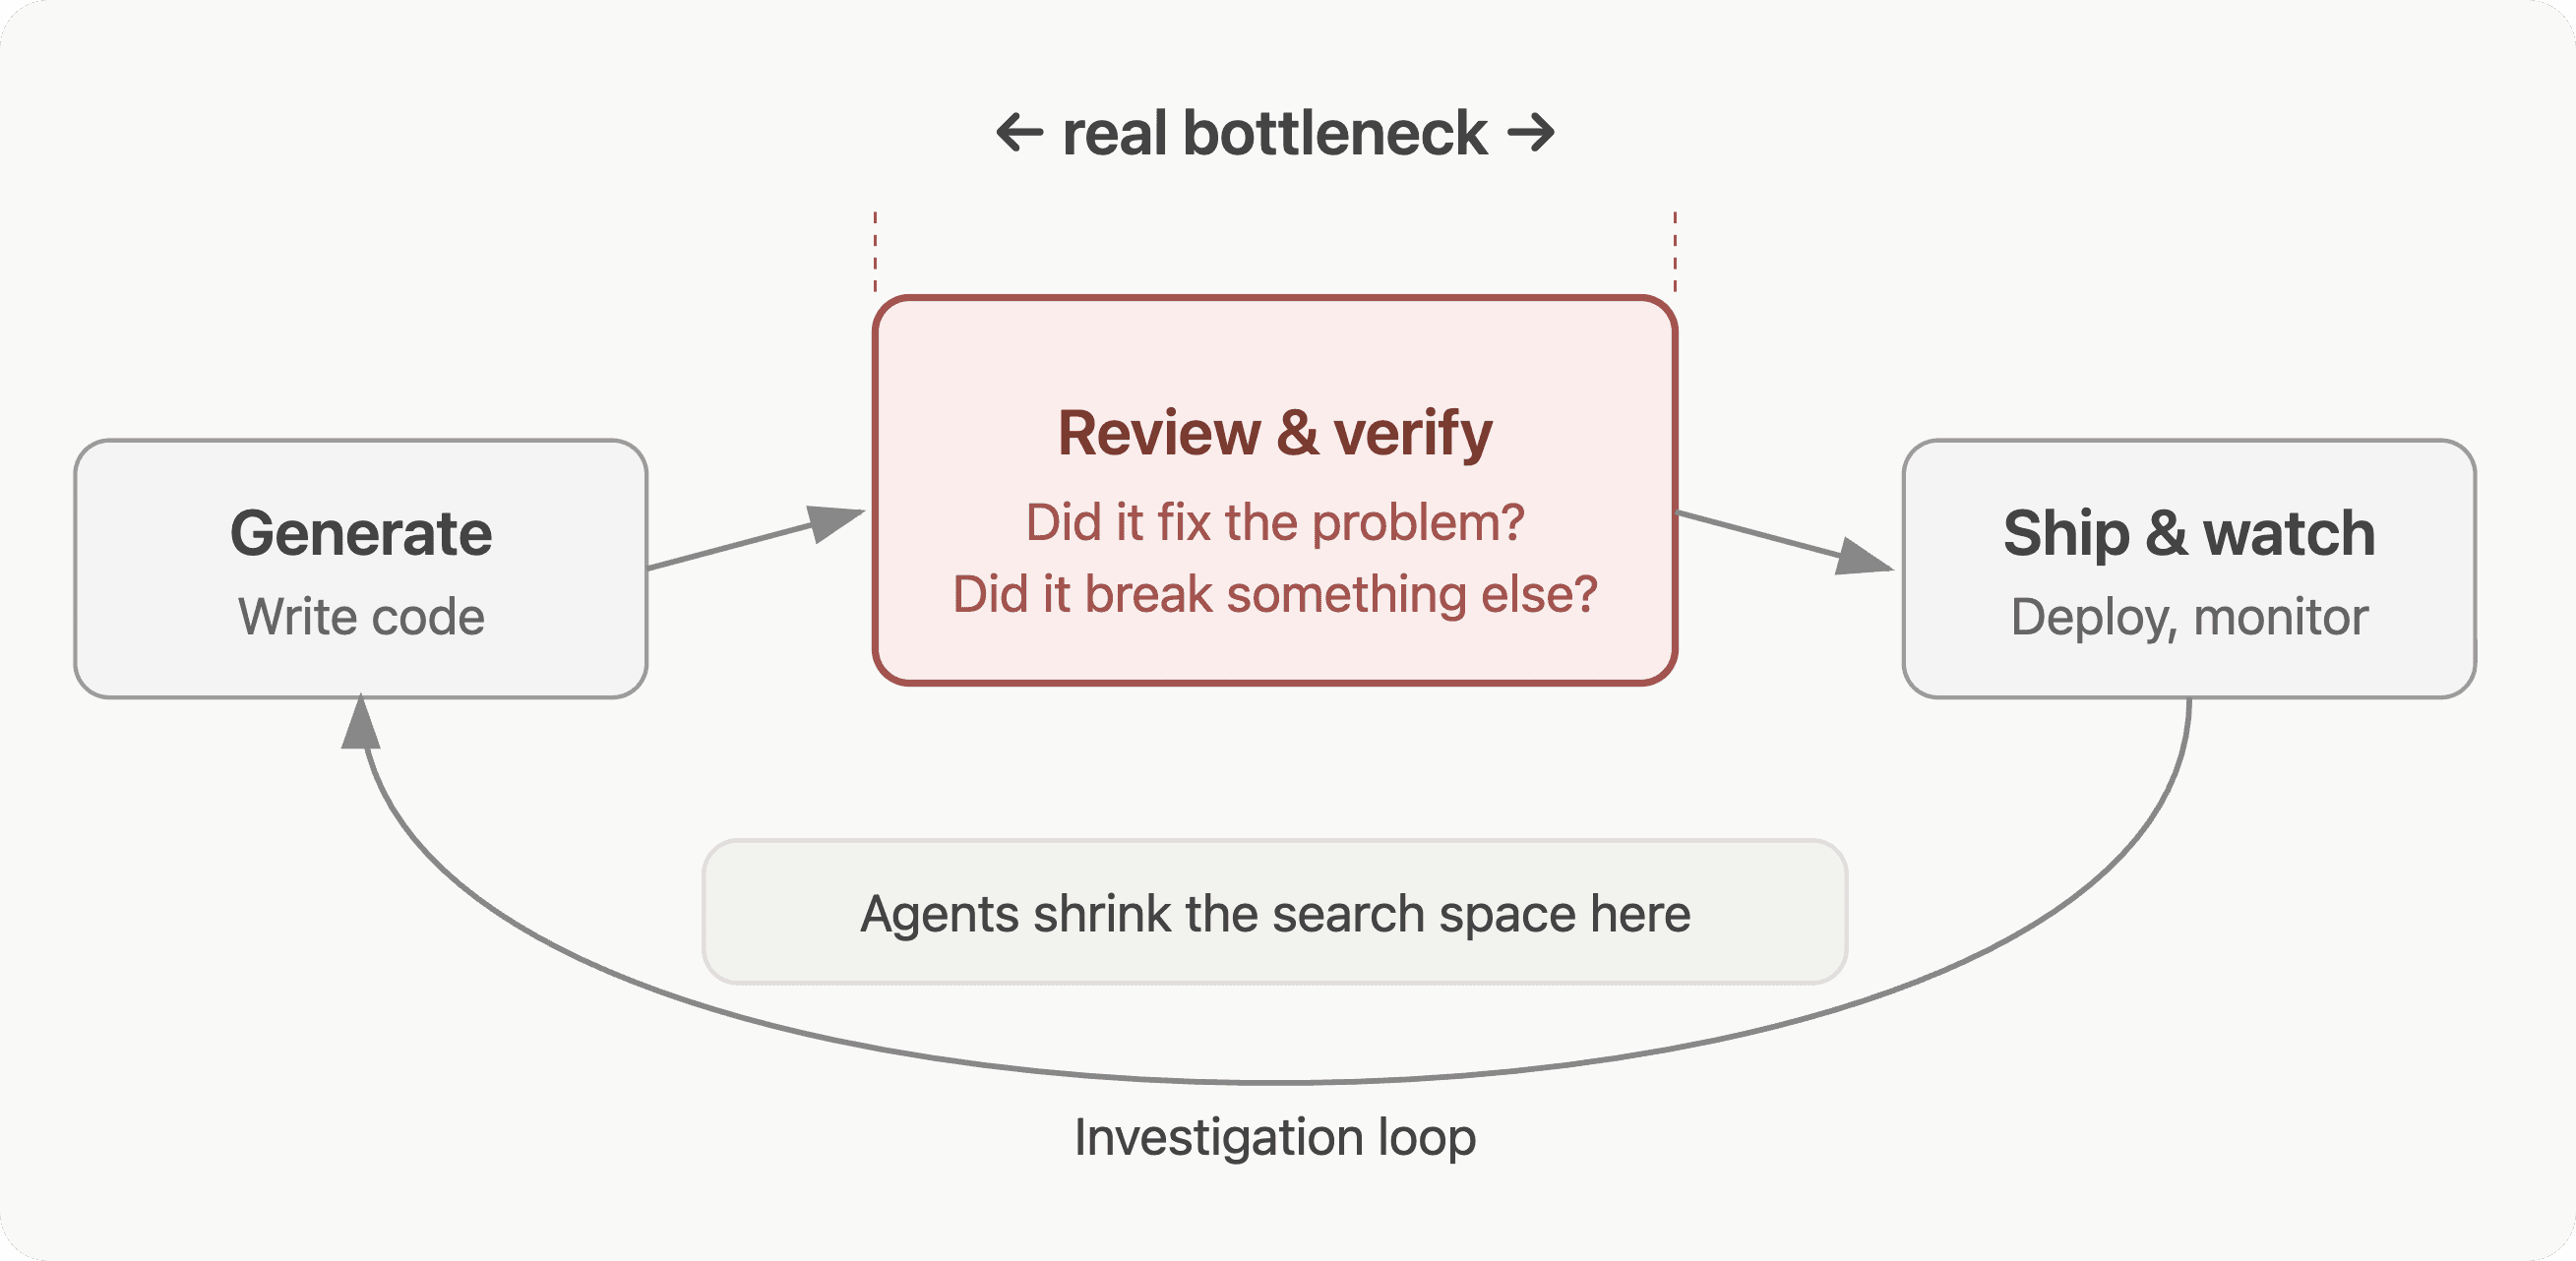
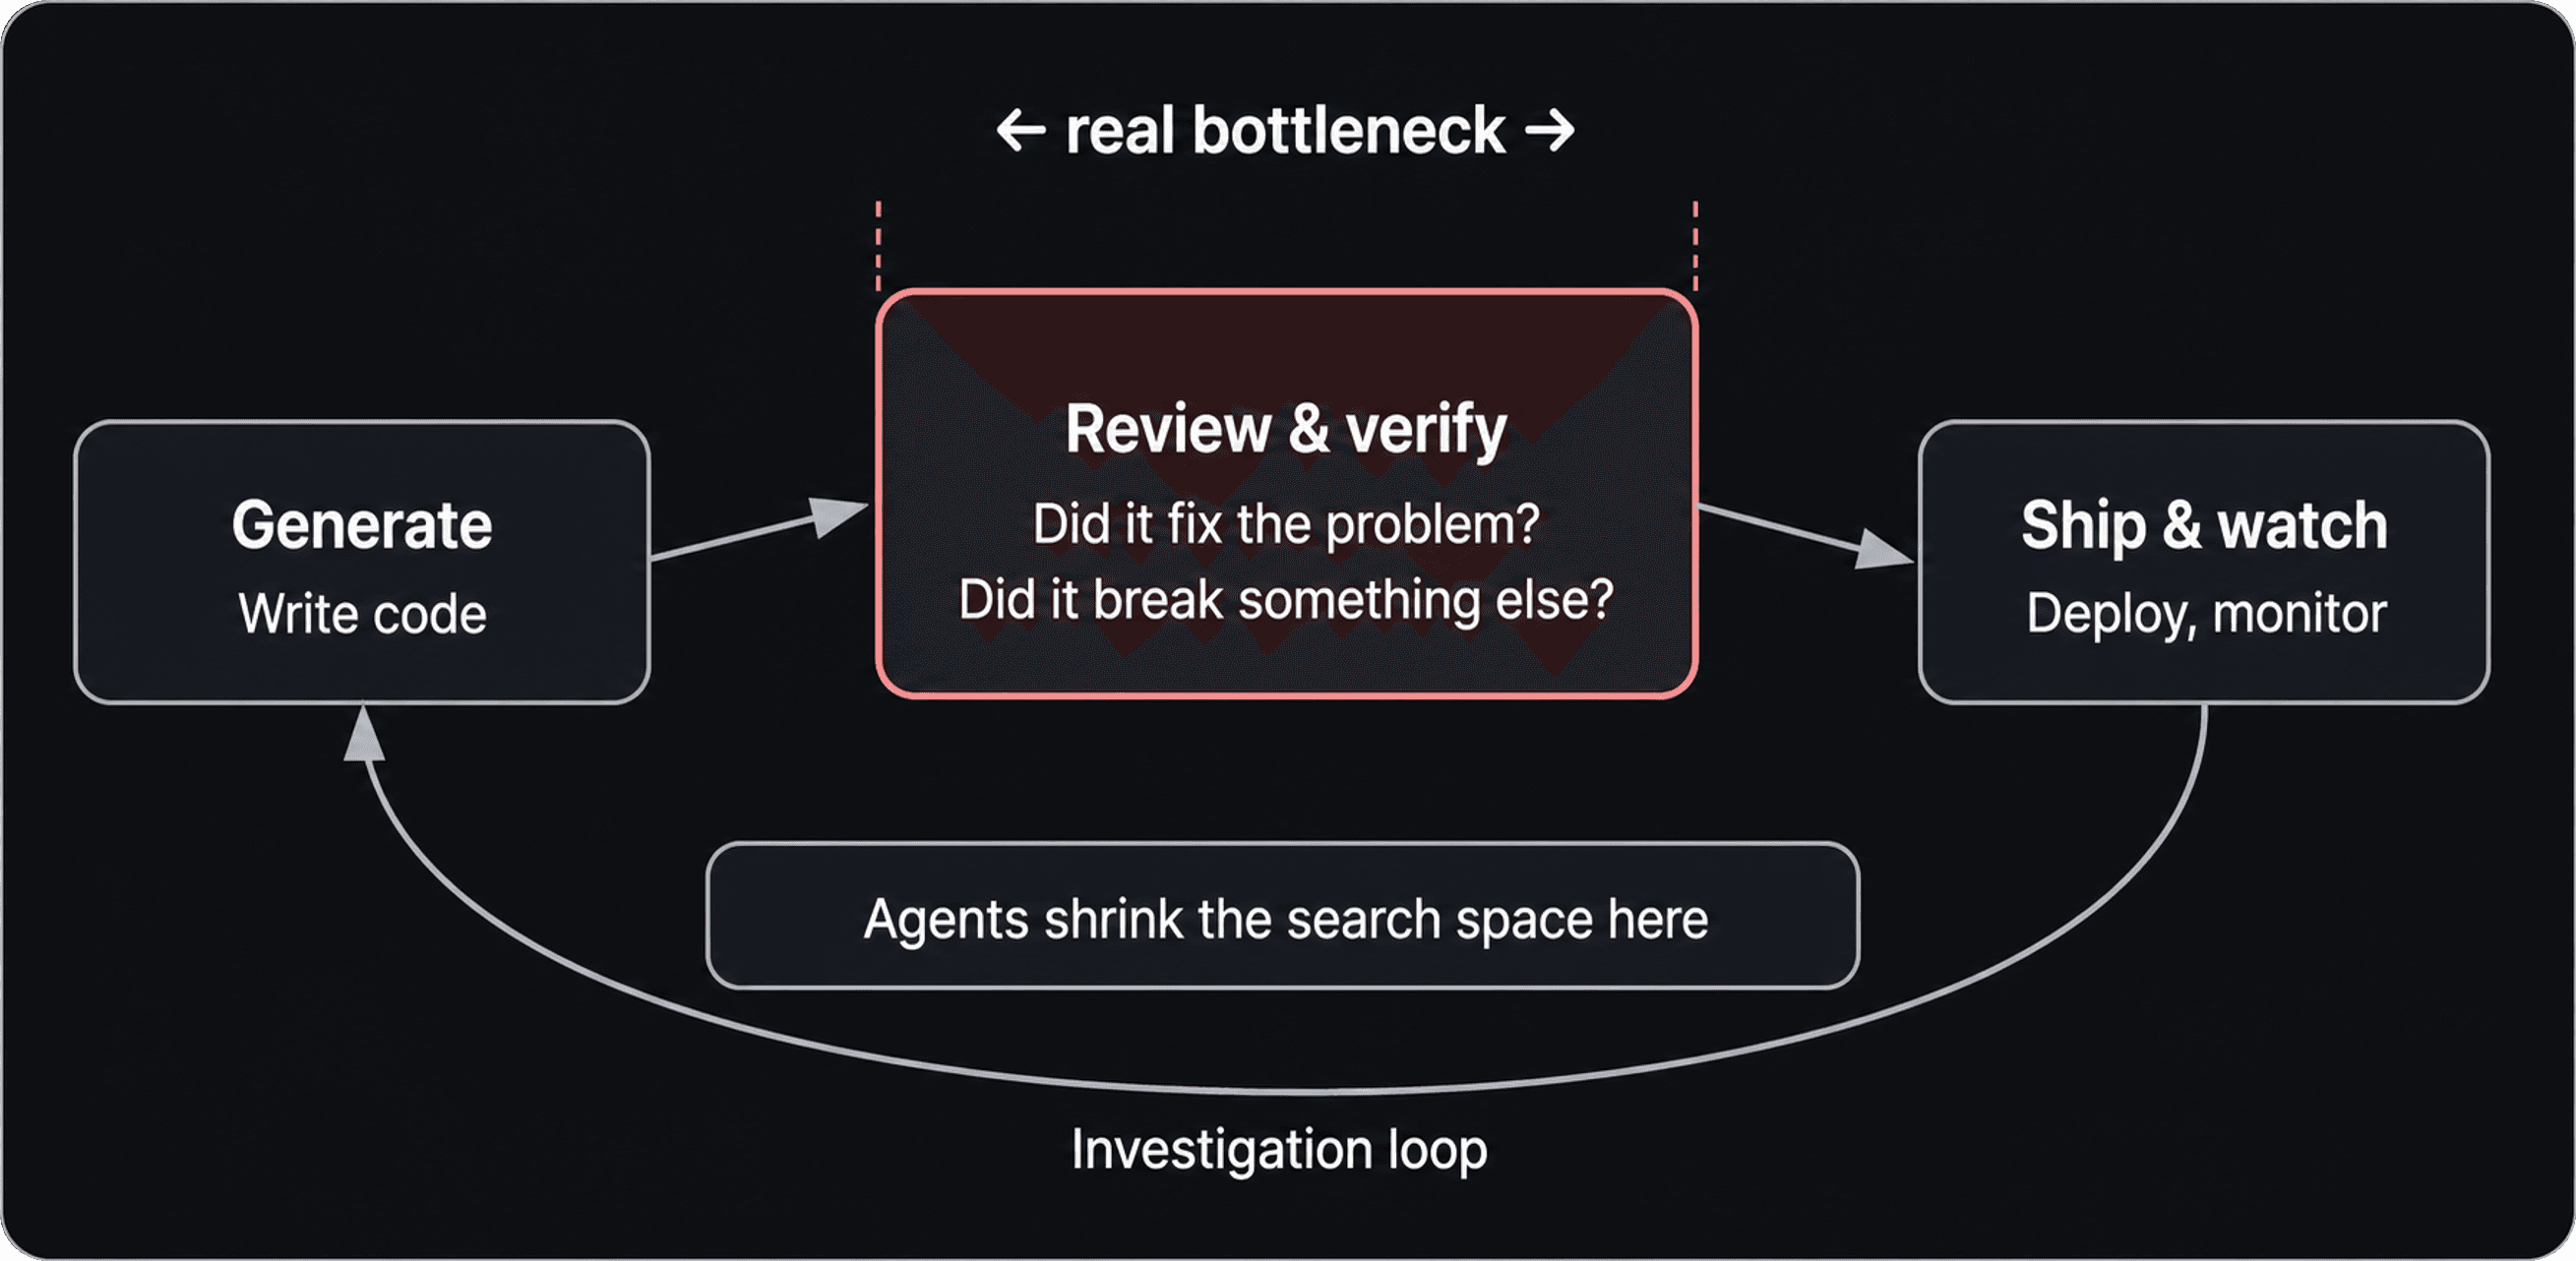
För de flesta team som inför agentbaserad kodning flyttas flaskhalsen från generering till granskning. Om återkopplingscykeln inte förbättras blir nettoökningen av utvecklingstakten nära noll.
I storskaliga CI-miljöer med miljontals nattliga tester och hundratals utvecklare skapar agenten störst värde genom att identifiera ansvariga och göra en första bedömning, inte genom att generera kod.
Användbara resultat från en agent tål granskning och förklarar orsakssamband, inte bara mönstermatchningar.
Utformningen av lagret för bevisinsamling och sammanställning av kontext är viktigare än genereringslagret.
De flesta diskussioner om agentbaserad kodning utgår fortfarande från ett enkelt löfte: att skriva mer kod snabbare.
Ibland växer det till en mer ambitiös vision där agenter planerar arbetet, öppnar PR:er och levererar ändringar med minimalt mänskligt ingripande. Men för de flesta utvecklingsteam är det tydligaste värdet på kort sikt mer begränsat. Det handlar om att minska kostnaden för varje iteration.
Att leverera programvara handlar inte bara om att generera kod. Att skriva kod är bara ett steg i en längre cykel som även omfattar granskning, testning, driftsättning och felsökning när något går fel. De flesta team som inför agentbaserad kodning utan att omforma granskningscykeln flyttar bara flaskhalsen till ett senare led.
Att enbart påskynda genereringen gör inte automatiskt teamet snabbare. Det kan bara flytta mer arbete till granskning, verifiering och förtroendeskapande.
I många utvecklingsmiljöer är det inte dyrast att ta fram ett första utkast, utan att bli säker på att det fungerar.
Löste ändringen faktiskt problemet eller förbättrade den systemet? Orsakade den en regression någon annanstans? Ligger felet i koden, miljön, testerna eller ett beroende? Åtgärdar den föreslagna lösningen orsaken eller bara det synliga symtomet?
Här kan agenter hjälpa till, inte genom att ersätta utvecklare utan genom att göra en strukturerad första genomgång av svåröverskådliga underlag: granska loggar, jämföra de senaste ändringarna, sammanfatta relevanta signaler, spåra sannolika orsaker, köra kontroller och lämna ett resultat som en människa kan granska närmare.
I många team skapar en agent störst hävstång genom något annat än att generera kod från grunden. Det handlar om att begränsa sökområdet kring ett problem innan en människa ägnar timmar åt att göra det manuellt.
Det blir särskilt tydligt i storskaliga arbetsflöden för felsökning. Föreställ dig en nattlig CI-körning med miljontals tester i kodbaser som ändras av hundratals utvecklare – en verklighet för en av våra kunder. När något misslyckas är det svårt att hitta och dirigera ärendet till rätt ansvarig. Problemet kan finnas i applikationskoden, ett beroende, testkörmiljön eller någon annanstans i teknikstacken. Loggarna kan omfatta flera gigabyte, och det team som först upptäcker problemet är inte alltid det som ansvarar för det.
I ett sådant arbetsflöde är det inte naturligt att låta en enda agent skriva lösningen. Det lämpar sig för ett system som snabbt begränsar problemområdet.
En användbar pipeline kan hämta loggar, välja ut relevanta underlag, sammanfatta det viktiga, granska kod i en sandlåda och skapa en strukturerad grundorsaksanalys med tillförlitlighetspoäng, spårbarhet och förslag på nästa steg. För att ta fram en tillförlitlighetspoäng bedömer en ämnesexpert agentens första resultat. Bedömningen matas sedan in i en LLM som fungerar som domare för att automatisera framtida poängsättning och samtidigt bibehålla överensstämmelsen med mänskliga bedömningar.
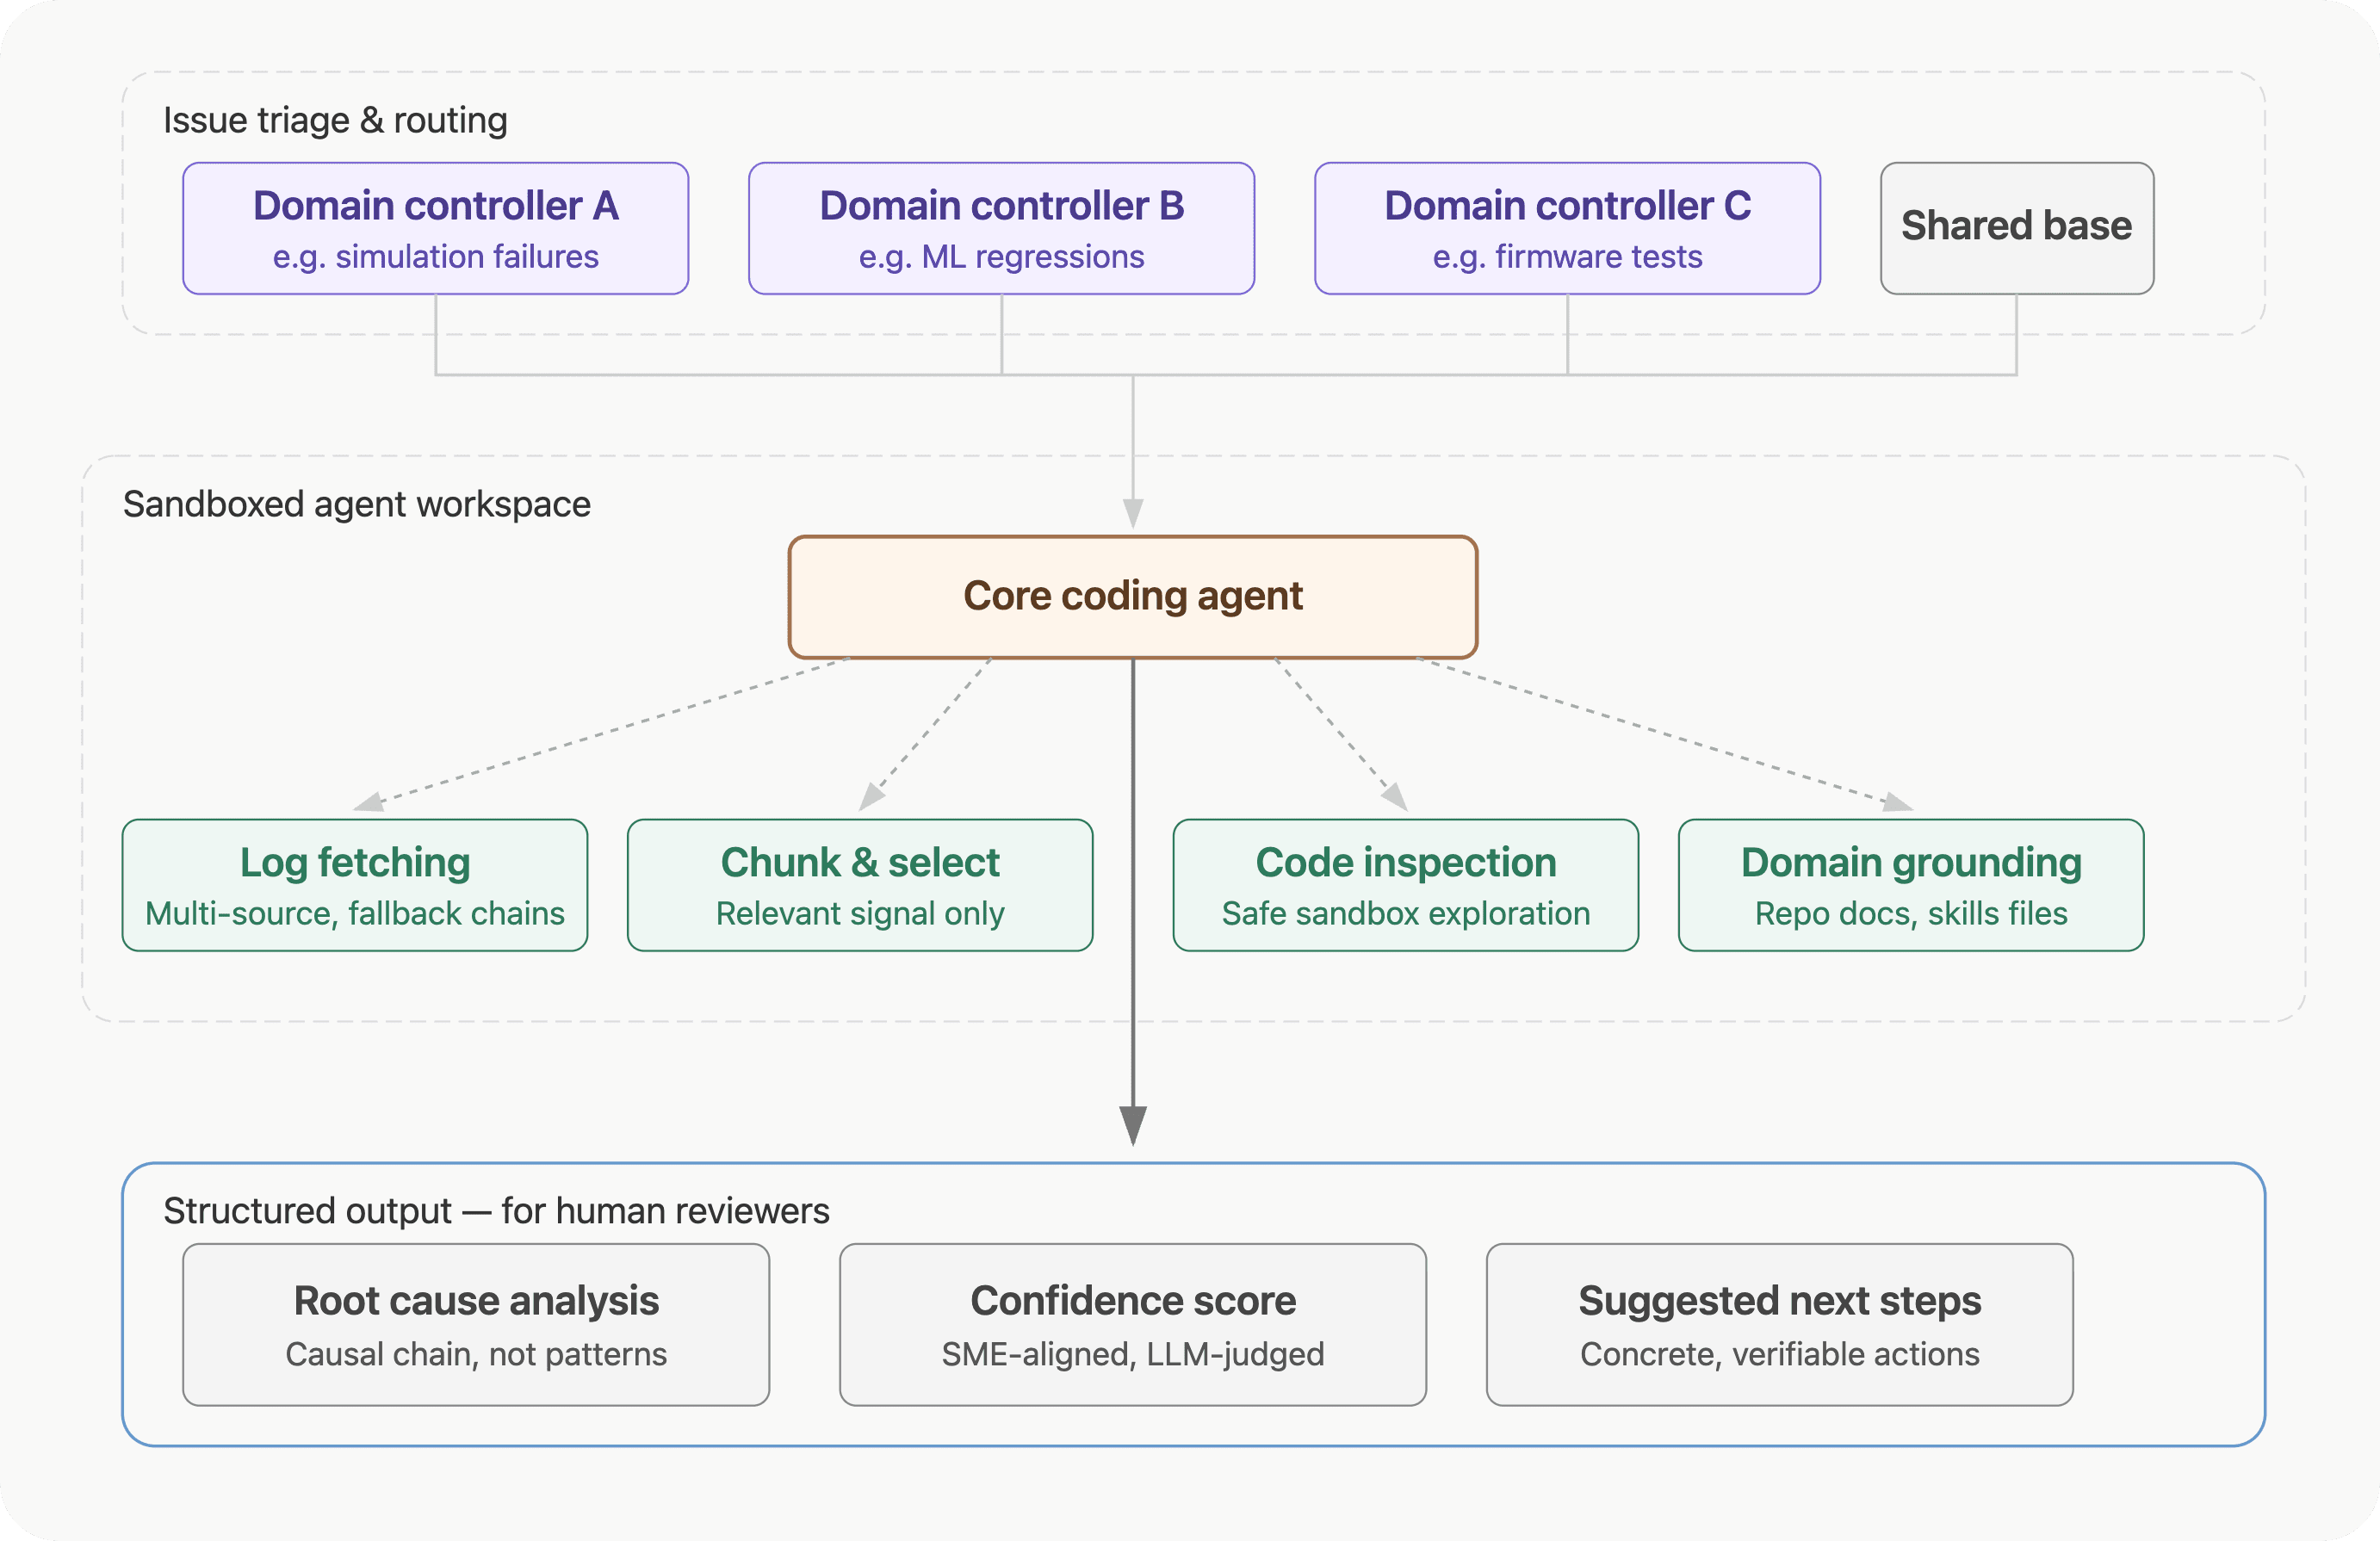
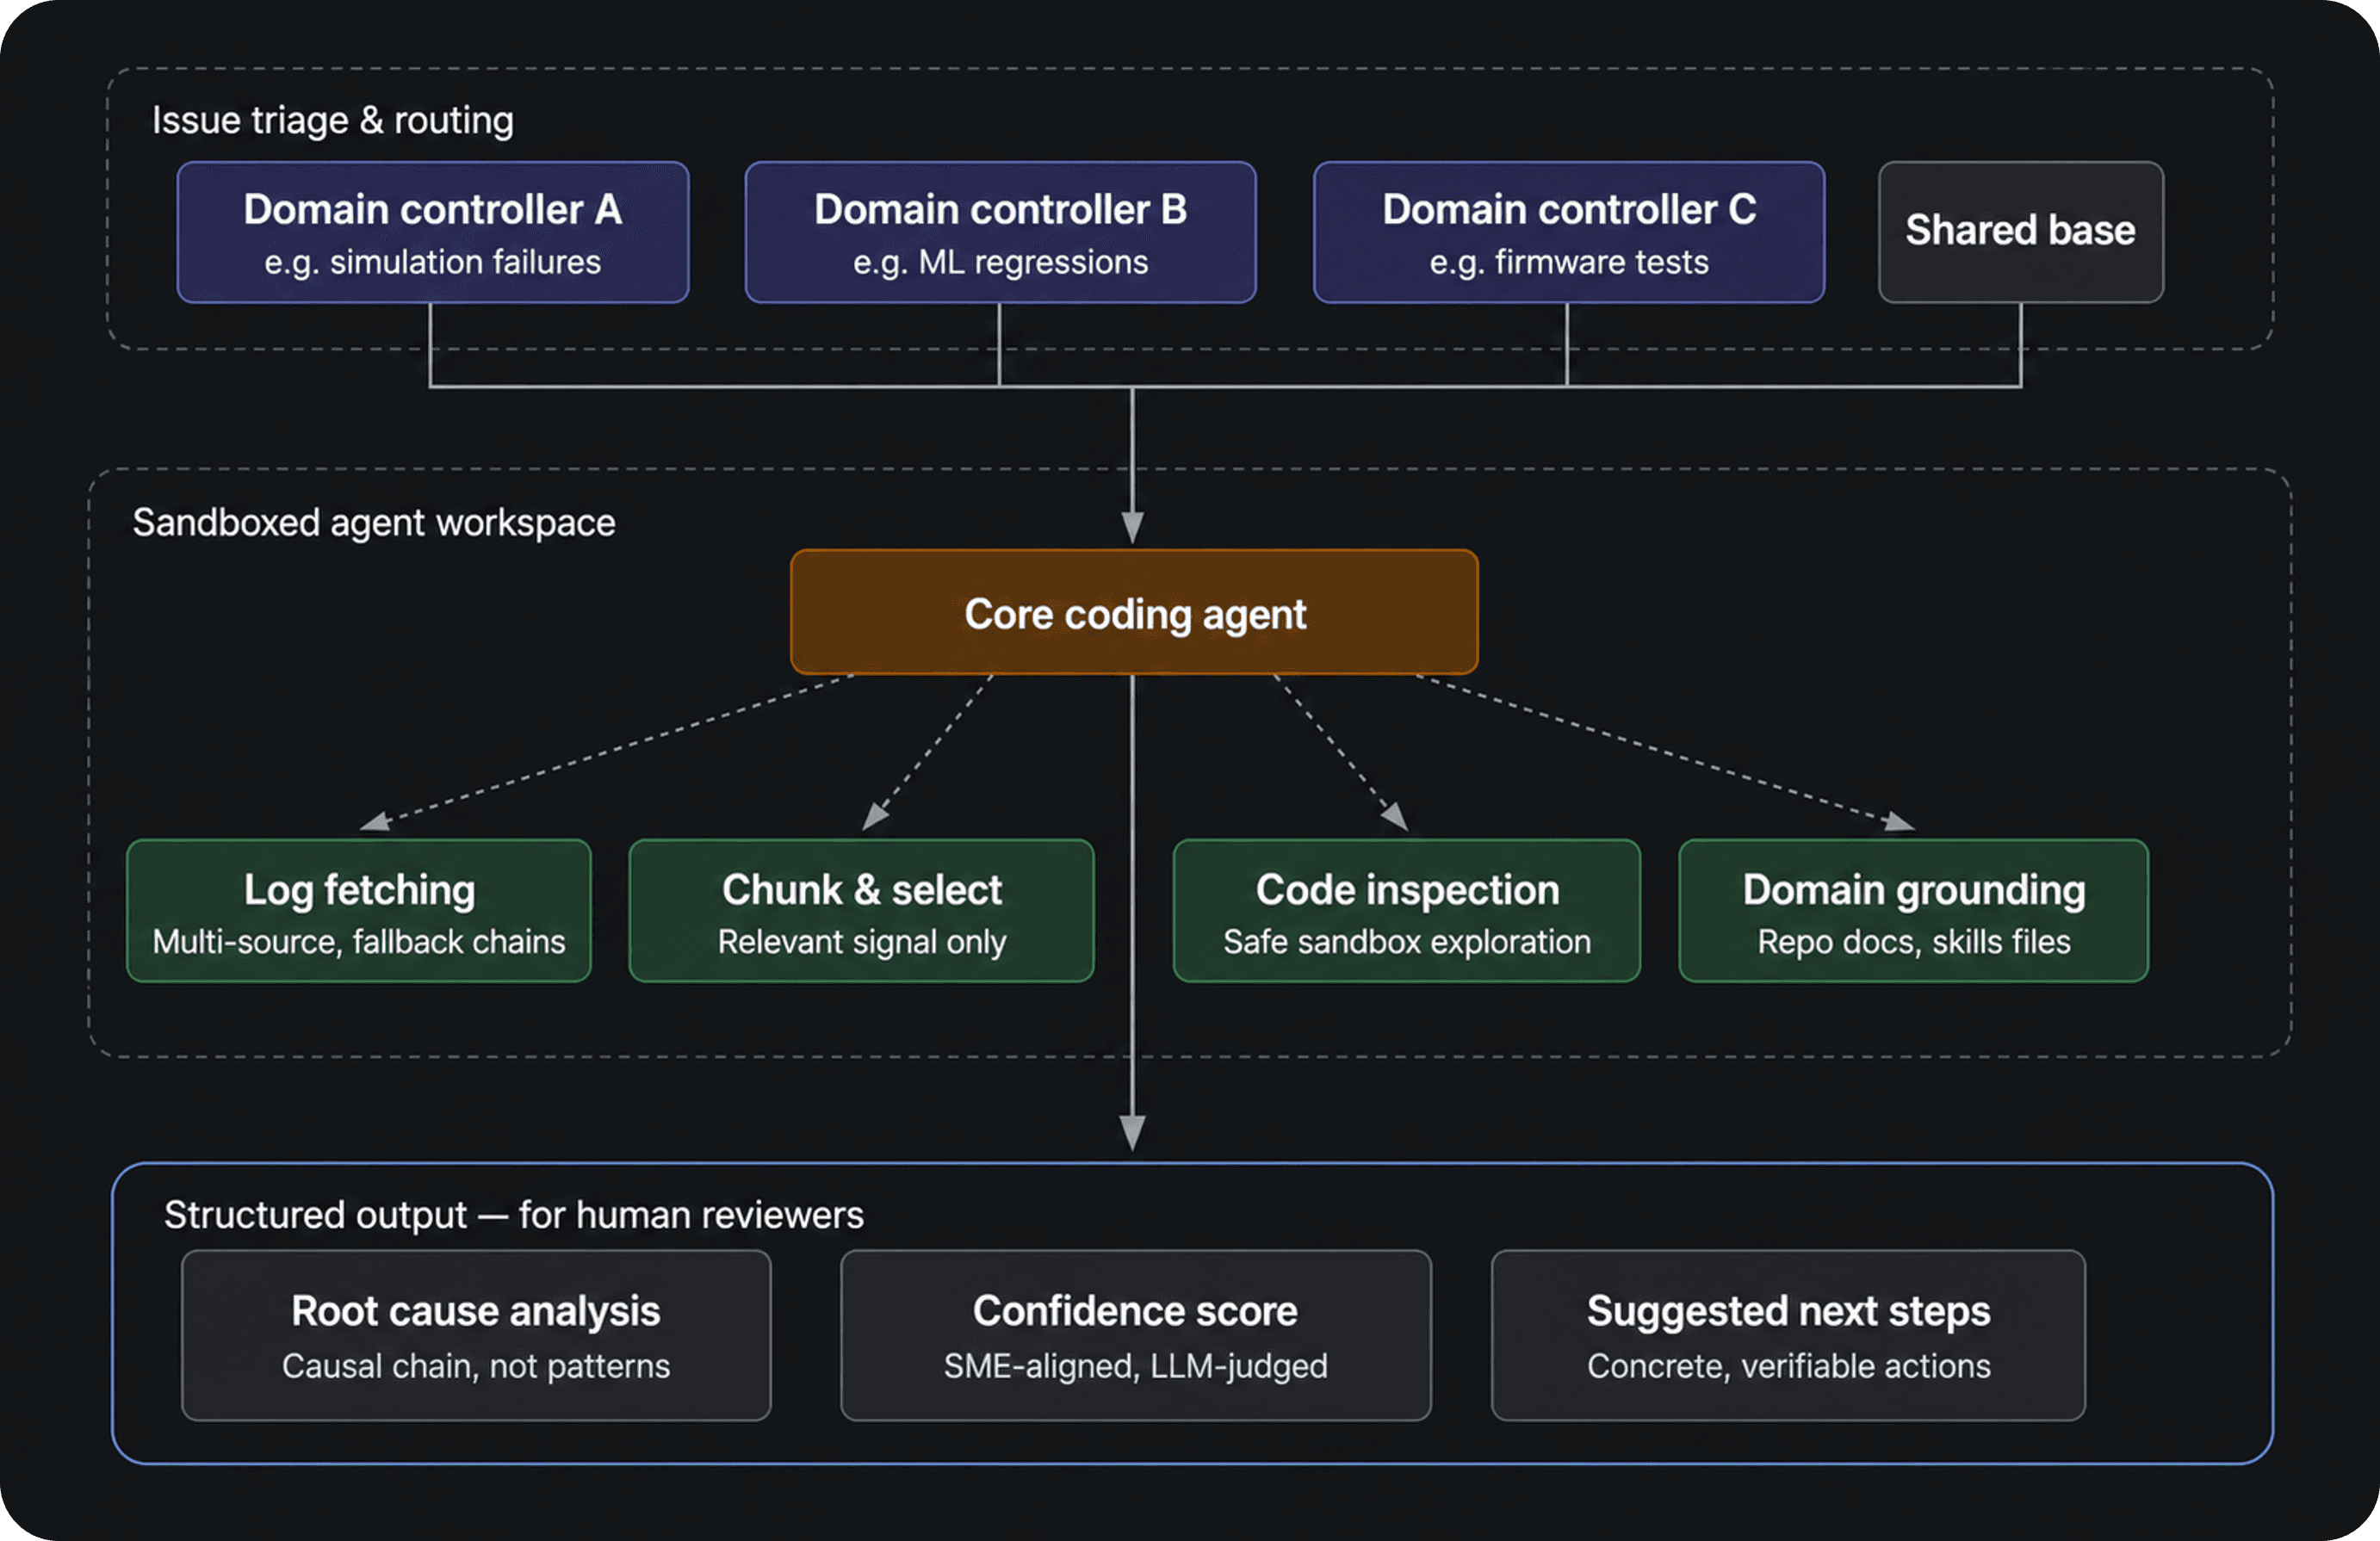
Syftet är inte att undanröja utvecklarnas omdöme, utan att ge granskarna en bättre utgångspunkt. Regressionstriage, PR-granskning, testreparation, versionsvalidering och utredningar efter driftsättning har alla samma grundform. De kräver omfattande underlag och granskning och rymmer mycket osäkerhet. De kräver inte att en agent ersätter utvecklingsprocessen, bara att den hjälper till att föra processen framåt.
Det är också därför team bör vara försiktiga med hur de utvärderar dessa system.
Fel fråga är om en agent kan åstadkomma något imponerande på egen hand. En bättre fråga är om den förbättrar ett verkligt arbetsflöde utan att skapa friktion någon annanstans.
Det innebär att bedöma om resultatet är tillräckligt specifikt för att kunna verifieras, om det förklarar orsakssamband i stället för att bara matcha mönster och om det gör granskningen enklare snarare än svårare. Ett trovärdigt svar är inte nödvändigtvis ett användbart svar. I praktiken litar team på resultat från en agent när de tål granskning och ger något konkret att kontrollera.
Den djupare lärdomen är att användbara agentbaserade system kräver mer än generering. De är beroende av hur underlag samlas in, hur kontext sammanställs, hur resultat kontrolleras och hur osäkerhet tydliggörs för granskaren.
Därför blir den närmaste framtiden för agentbaserad mjukvaruutveckling sannolikt inte ett enda jättesprång mot full autonomi. Det blir troligare en uppsättning väl utformade återkopplingscykler där agenter hjälper team att undersöka, granska, verifiera och finslipa sitt arbete med mindre onödigt arbete mellan stegen.
Det låter kanske mindre dramatiskt än den bredare visionen om autonomi, men ligger mycket närmare hur användbara system faktiskt tas i bruk.