Existujúce systémy autonómneho zlepšovania dosiahli pri programátorských úlohách dobré výsledky. Stále však nie je jasné, či dokážu zlepšiť aj zložité dlhodobé pracovné postupy AI podobné skutočným podnikovým nasadeniam.
Náš výskum Meta-Harness uplatňuje autonómne samovylepšovanie na pracovné postupy agentického vyhľadávania, hlbokého výskumu a signálového spravodajstva. Zároveň pridáva podnikové požiadavky, ako sú hodnotenie na oddelených dátach, auditovateľnosť, kontrola rozpočtu a schválenie človekom.
Meta-Harness výrazne zvýšil výkon v troch reprezentatívnych úlohách. Signal Engine dosiahol 84 % zlepšenie výkonu v oddelenom teste a agentické multimodálne vyhľadávanie prinieslo vyššiu presnosť pri 16-násobne rýchlejšom vykonávaní.
Na rozdiel od väčšiny predchádzajúcich prístupov meria Meta-Harness úspešnosť podľa možností na oddelených množinách údajov, aby overil, či zlepšenia zovšeobecňujú aj mimo dát použitých pri optimalizácii.
Výsledky naznačujú, že autonómne zlepšovanie pracovných postupov možno rozšíriť z programátorských benchmarkov aj na reálne podnikové systémy AI. Ponúka tak praktickú cestu k neustálemu zdokonaľovaniu aplikácií AI.
Nedávny výskum autonómneho výskumu AI vrátane článku Meta-Harness, frameworku CORAL a projektu karpathy/autoresearch ukázal, že programovacie agenty dokážu na základe hodnotiacej metriky iteratívne zlepšovať riešenie. Otvorenou otázkou zostáva, či tieto metódy fungujú aj pri dlhodobých pracovných postupoch AI. Patrí sem napríklad agentické multimodálne vyhľadávanie, pri ktorom musí agent opakovane prehľadávať multimodálne doménové korpusy, aby zodpovedal otázku, alebo zložité procesy spracovania údajov vyžadujúce množstvo závislých krokov, volaní nástrojov a rozhodnutí pri spracovaní výnimiek. Podstatnejšou otázkou je, či zlepšenia pretrvajú aj na dátach, ktoré optimalizátor nikdy nevidel.
Náš výskum a vývoj Meta-Harness je odpoveďou na túto otázku. Preberá myšlienky z nedávneho výskumu a prispôsobuje ich potrebám podnikov: hodnoteniu na oddelených dátach, auditným záznamom, nákladovým stropom a jasnému odovzdaniu ľudskému kontrolórovi pred akýmkoľvek nasadením.
Otestovali sme ho na troch dlhodobých úlohách vytvorených podľa skutočnej práce pre klientov. Signal Engine sleduje živý prúd príspevkov na sieti X o trhu s AI a vytvára štruktúrované správy o trendoch s kvalitnými zdrojmi. Agentické multimodálne vyhľadávanie vyhodnocuje kombinované textové a obrazové dopyty a vracia najrelevantnejšie strany dokumentov. Hlboký výskum koordinuje viacero agentov, ktorí prehľadávajú web, vzájomne overujú zdroje a píšu rozsiahle výskumné správy.
Signal Engine: súhrnné skóre oddeleného testu 0,456 → 0,841, relatívny nárast o 84 %. CORAL a karpathy/autoresearch zostali pri rovnakom rozpočte pod hodnotou 0,50.
Agentické multimodálne vyhľadávanie: NDCG@10 v oddelenom teste 0,705 → 0,744, pričom reálny čas jedného hodnotenia klesol z 869 s na 54 s. To znamená 16-násobné zrýchlenie pri vyššej presnosti.
Hlboký výskum: súhrnné skóre kvality správ 0,449 → 0,802 pri 10 referenčných otázkach, kým východiskové metódy dosiahli približne 0,52. Táto úloha nemala oddelenú časť dát, preto výsledok považujeme len za skóre na trénovacích dátach.
Efektivita vyhľadávania: s prediktívnym preraďovaním hypotéz dosiahol Signal Engine pri rovnakom rozpočte hodnotenia 91 % najlepšieho skóre referenčného behu za 3 iterácie namiesto 20.
Väčšina systémov autonómneho výskumu optimalizuje a hodnotí na rovnakej množine údajov, takže nemožno určiť, či výsledok zovšeobecňuje. Pri Signal Engine a agentickom multimodálnom vyhľadávaní uplatňujeme prísne rozdelenie: trénovaciu množinu, na ktorej môžu kandidáti získavať skóre, vývojovú množinu na základné kontroly a oddelenú testovaciu množinu, ktorú optimalizátor nikdy nevidí. Každý uvedený výsledok pochádza z jednej konkrétnej verzie kódu vyhodnotenej na všetkých častiach dát. Nikdy teda nekombinujeme najlepšie trénovacie skóre jedného kandidáta s najlepším testovacím skóre iného.
V každom kole harness vytvorí súbor štruktúrovaných hypotéz na úpravu kódu. Každá hypotéza pomenúva mechanizmus, ktorý chce zmeniť, predchádzajúcu verziu, z ktorej vychádza, a typ zlyhania, na ktorý sa zameriava. Pred spustením nákladných hodnotení súbor prefiltruje krok zoradenia. Vybrané hypotézy prevezmú paralelní výkonní agenti. Zdieľajú spoločnú vedomostnú databázu, no kód upravujú v úplne izolovaných pracovných priestoroch, takže každý kandidát sa hodnotí spravodlivo a nezávisle. Na konci kola systém vyberie jedného víťaza: kandidáta s najvyšším skóre, ktorý zároveň prešiel všetkými kontrolami vo viditeľných častiach dát. Tento víťaz sa stane východiskom pre ďalšie kolo. Každý pokus zapíše do úložiska dôkazov bez možnosti prepisovania pevnú sadu údajov: záplatu kódu, skóre jednotlivých častí dát, denník udalostí a štyri krátke analýzy vytvorené LLM, ktoré sa venujú priebehu, chybám, nákladom a reflexii. Navrhovateľ v ďalšom kole túto históriu načíta. Harness tak využíva už získané poznatky namiesto opakovania rovnakých slepých uličiek.

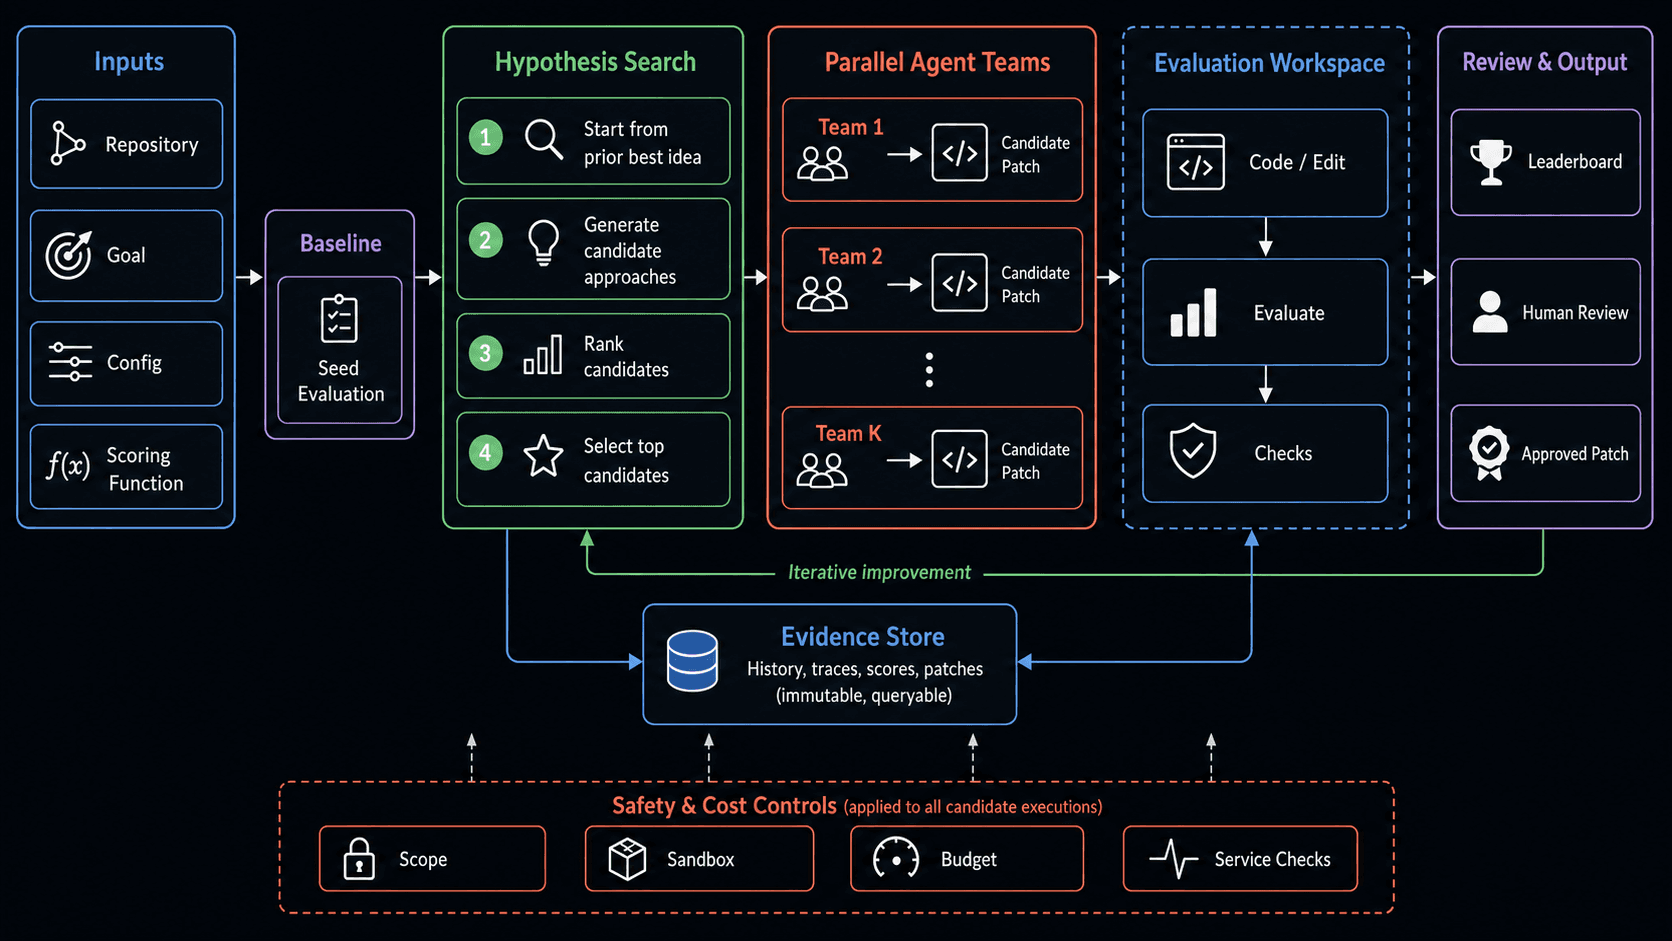
Bezpečný priebeh cyklu zabezpečujú tri ochranné mechanizmy. Pravidlá rozsahu obmedzujú, ktoré súbory môže kandidát upraviť, a všetky zmeny mimo povoleného rozsahu vrátia späť. Limity tokenov a času ukončia beh po prekročení stropu výdavkov, zatiaľ čo obmedzenia súbežnosti udržujú harness v rámci limitov požiadaviek modelu a GPU. Samotný harness navyše nikdy nič nenasadzuje. Vytvorí zoradeného, úplne zdokumentovaného kandidáta. Rozdiely potom skontroluje ľudský technik a rozhodne, či sa má kandidát nasadiť do produkcie.
V lokálnom technologickom prostredí stojí každé kolo uvedeného cyklu na piatich technických pilieroch.
Izolácia pracovných priestorov. Pre každého kandidáta samostatný pracovný strom git. Vetvy zdieľajú databázu objektov, ale nikdy nie svoje súbory. Kandidáti tak môžu bežať paralelne s takmer nemennými nárokmi na disk a rozdiel oproti aktuálne najlepšej verzii možno ľahko zobraziť.
Izolované prostredie na spúšťanie. Konfigurácia ponúka dva režimy: natívny podproces na rýchle iterácie alebo úplne izolované prostredie. Korpusy sa pripájajú iba na čítanie a dočasný adresár každého pokusu sa po vyhodnotení odstráni. Pokus preto nemôže zmeniť množinu údajov ani preniesť stav do nasledujúceho pokusu.
Pravidlá rozsahu. Zoznam povolených ciest definovaný v konfigurácii experimentu. Všetky zmeny mimo neho sa pred vyhodnotením pokusu vrátia späť a pokus sa označí. Rozdiely zobrazené kontrolórovi tak zaručene zostanú v deklarovanom rozsahu.
Dodržiavanie rozpočtu. Tri vrstvy: limity tokenov a času jednotlivého pokusu, celkový strop jedného behu a limit súbežnosti. Spoločne zabezpečujú predvídateľné výdavky a udržujú harness v rámci limitov požiadaviek modelu a infraštruktúry.
Úložisko dôkazov. Súbor JSONL bez možnosti prepisovania obsahujúci záplatu kódu, skóre jednotlivých častí dát, denník udalostí a štyri analýzy vytvorené LLM. Materializované zobrazenia (rebríček, najlepšia verzia a index zlyhaní) sa po každom pokuse obnovia. Ďalšie kolá tak môžu vychádzať z histórie a každý beh pritom zostáva reprodukovateľný bajt po bajte.
Žiadny z týchto pilierov nie je voliteľný. Cieľom harnessu je dať kontrolórovi na konci behu niečo, čo môže skutočne schváliť: víťazného kandidáta, rozdiely v presne vymedzenom rozsahu, úplný záznam všetkých pokusov a známe náklady. Odstránením ktoréhokoľvek z piatich pilierov jedna z týchto záruk zanikne.
Všetky tri experimenty používajú rovnakú stratégiu hypotéz. V každej iterácii navrhovateľ vytvorí viac hypotéz, než umožňuje spustiť rozpočet: M = 8 kandidátov pri rozpočte na odoslanie K = 4. Samostatný radiaci LLM potom všetkých 8 zoradí počas jediného tridsaťsekundového volania. Má pritom úplný prehľad: aktuálne najlepšie skóre a jeho slabé rozmery, analýzy zlyhaní z nedávnych pokusov aj všetkých 8 návrhov vedľa seba. Najlepšie 4 návrhy prevezme vykonávací systém, pričom každý stojí 15 až 30 minút. Zvyšné 4 sa vyradia skôr, než spotrebujú akékoľvek zdroje.
Základné modely zostali po celý čas nezmenené. Harness upravoval iba kód okolo nich. Signal Engine a hlboký výskum používali gpt-5.5. Agentické multimodálne vyhľadávanie používalo model s otvorenými váhami Qwen3.6-35B-A3B, ktorý sa lokálne poskytoval prostredníctvom vLLM, spolu s obrazovým vyhľadávačom ColQwen3-4B. Túto kombináciu sme zvolili pre jej predvídateľné lokálne náklady.
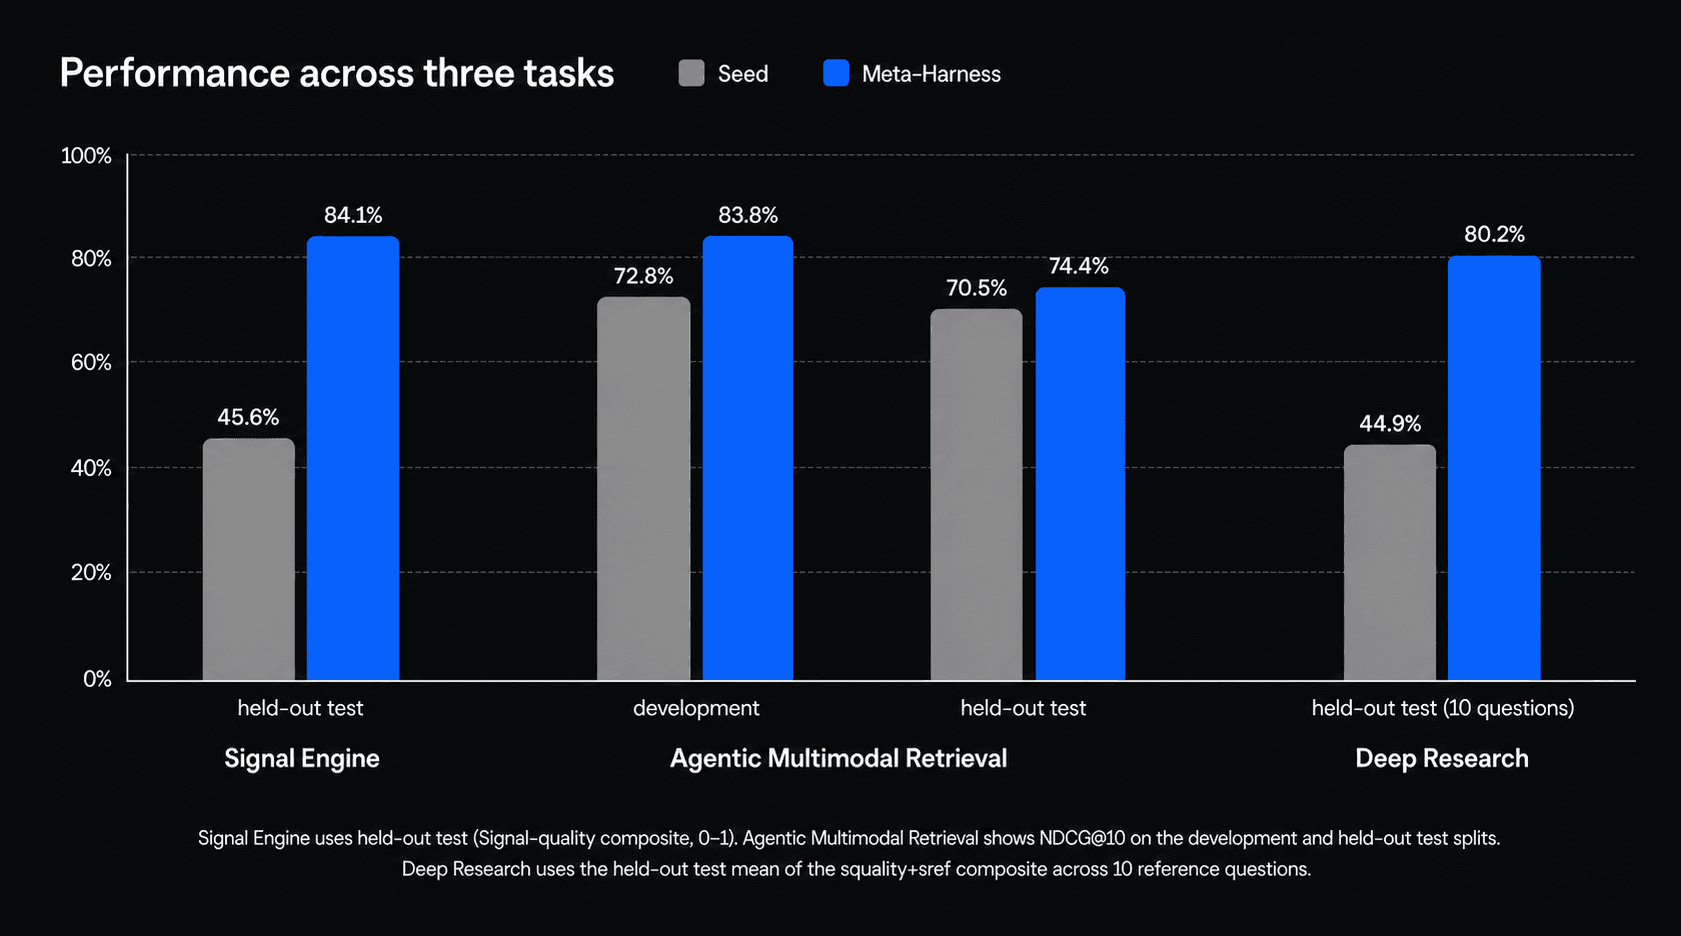
Nasledujúci graf znázorňuje vývoj skóre našich troch hlavných úloh. „Východisková verzia“ je počiatočný kód napísaný ľudským technikom. „Meta-Harness“ je najlepšia verzia, ktorú Meta-Harness našiel. Pri všetkých troch úlohách pozorujeme zlepšenie výkonu v oddelenej testovacej množine.
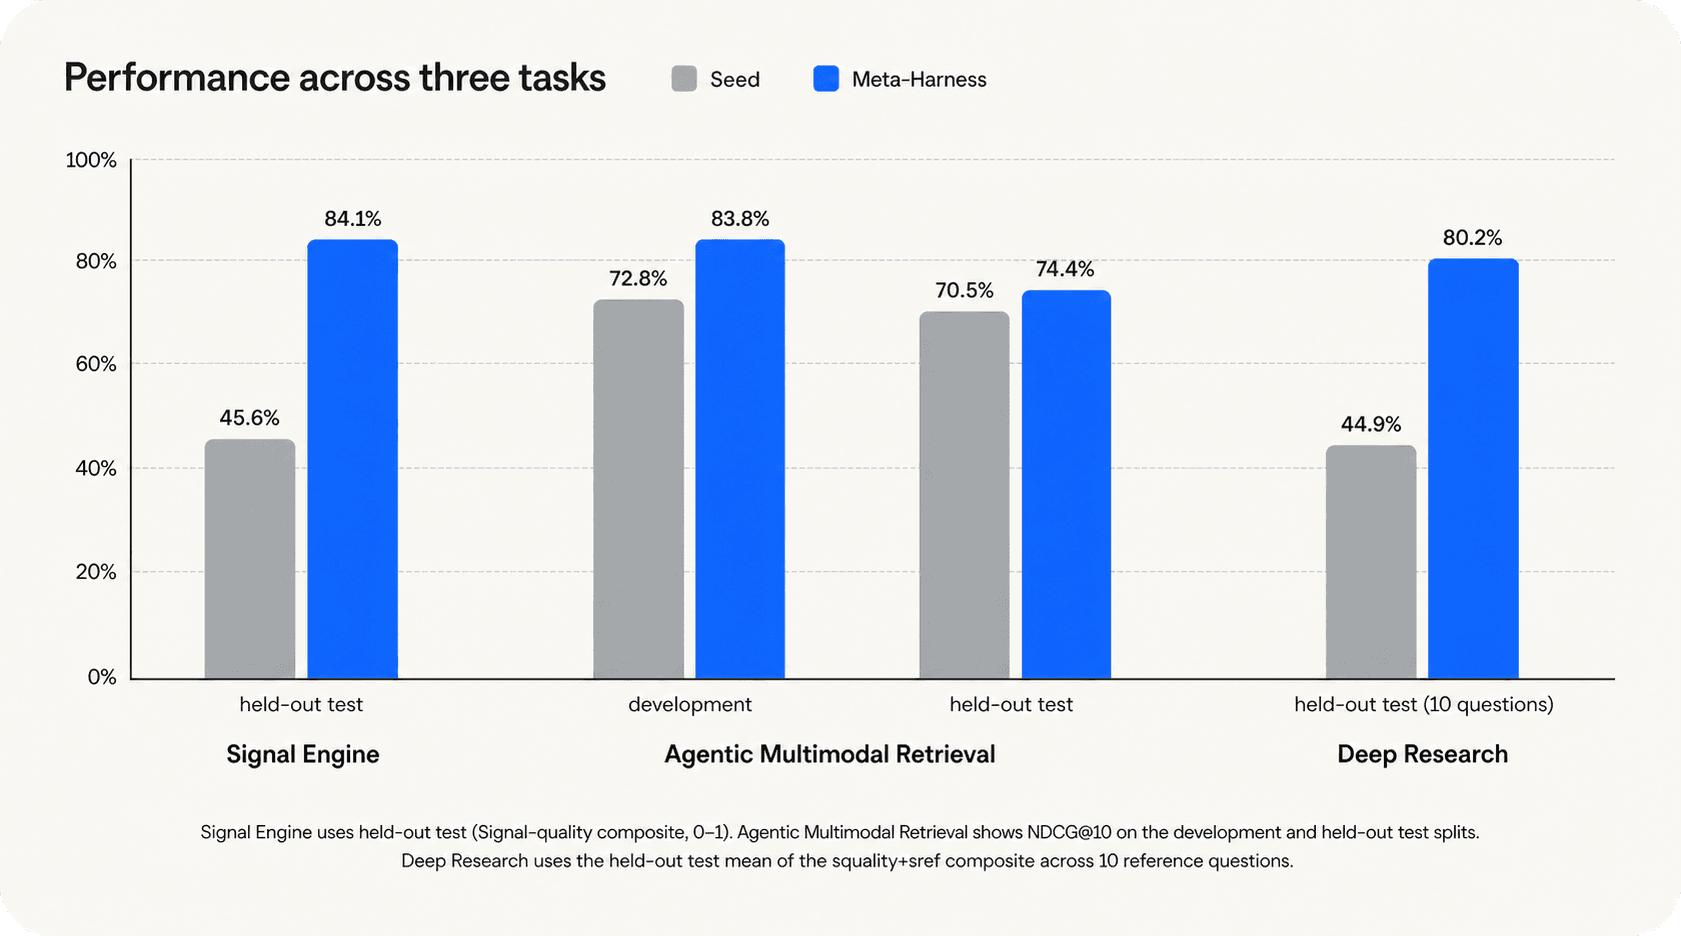
Signal Engine hodnotil posudzovací LLM podľa aktuálnosti, faktickej správnosti, podrobnosti a tónu. Použilo sa 150 trénovacích tweetov a 150 oddelených testovacích tweetov. Najlepšia verzia počas behu zvýšila súhrnné trénovacie skóre z 0,431 na 0,756 a skóre oddeleného testu z 0,456 na 0,841. Zlepšenia nevyplynuli iba z úprav príkazov, ale zo zmien samotného harnessu: víťazné iterácie sa naučili filtrovať šum zo sociálnych sietí, pridali kroky na krížové overovanie faktov a vyžadovali, aby každý výstup vychádzal z explicitných dôkazov. Nasledujúca schéma znázorňuje proces iterácie.

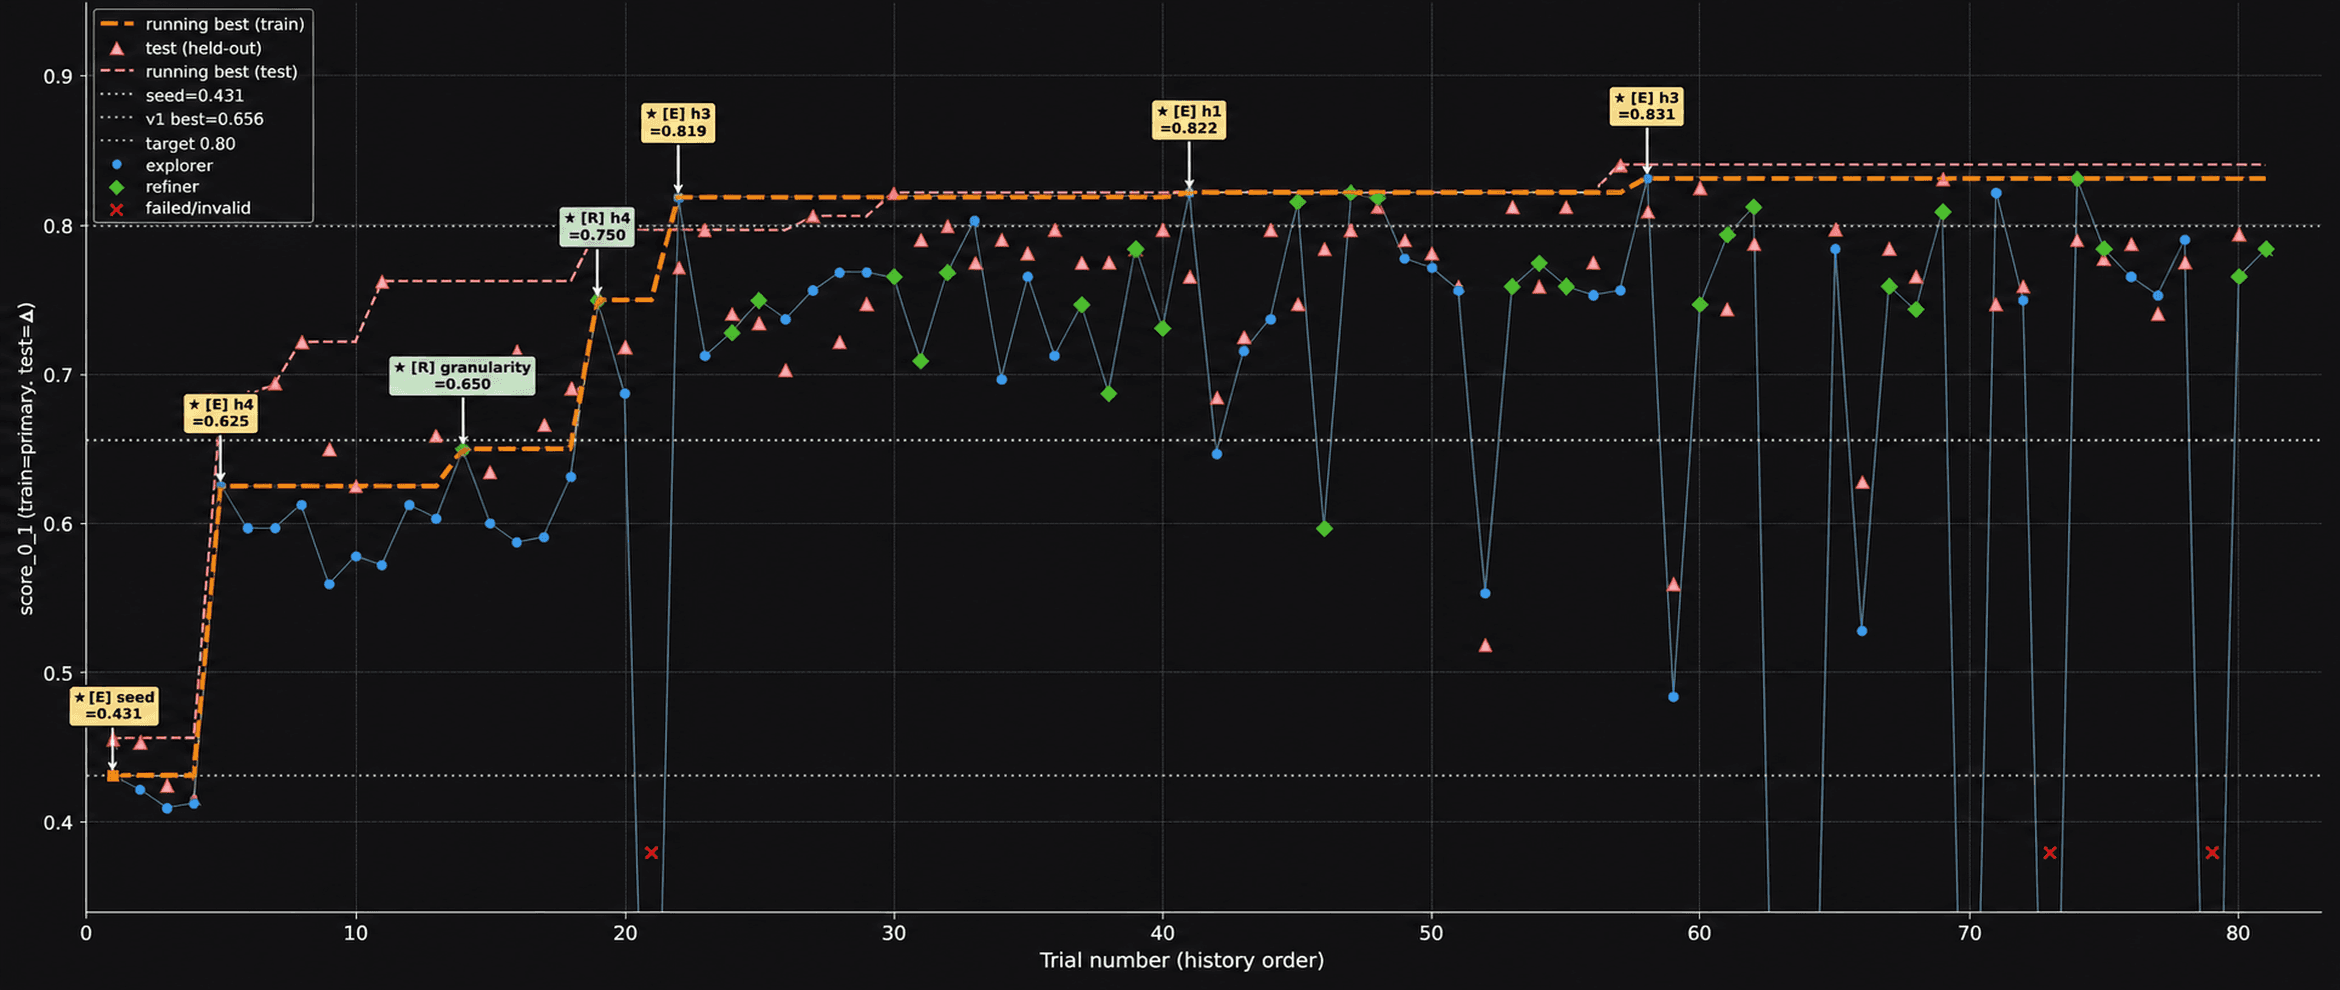
História pokusov ukazuje, ako sa tieto zlepšenia postupne hromadili. Skorá štrukturálna zmena zvýšila dovtedajšie maximum na 0,625, podrobnejšie spracovanie dôkazov ho posunulo na 0,679 a zdokonalený cyklus reflexie a hodnotiacich kritérií až na 0,819. Približne polovica behov kandidátov dosiahla horšie výsledky alebo úplne zlyhala, no rebríček neovplyvnila. Každá vetva bežala izolovane, rozdiely neúspešných verzií sa zahodili a zlyhania sa zapísali do úložiska reflexií, aby ďalší navrhovateľ nezopakoval rovnakú slepú uličku.
Najdôležitejšie je, že krivka oddeleného testu počas celého behu rástla spolu s trénovacou krivkou. To naznačuje, že harness zlepšoval pracovný postup, a nie že si iba zapamätával trénovací korpus. Skóre oddeleného testu bolo mierne vyššie než trénovacie skóre. Považujeme to za bežný výberový šum medzi dvoma malými, navzájom sa neprekrývajúcimi časťami dát.
Agentické multimodálne vyhľadávanie meriame pomocou NDCG@10 na verejnej časti Computer Science množiny ViDoRe V3, upravenej na 20 trénovacích, 10 vývojových a 20 oddelených testovacích dopytov. Harness zvýšil NDCG@10 v oddelenom teste z 0,705 na 0,744 a zároveň skrátil celkový reálny čas hodnotenia z 869 sekúnd na 54 sekúnd.
Hlboký výskum sa pri 10 referenčných otázkach hodnotí pomocou súhrnného skóre vecnej kvality a kvality zdrojov posudzovaného LLM podľa metodiky DeepResearch-Eval. Vylepšený kód zvýšil priemer z 0,449 na 0,802. Víťazné zmeny boli v rozdieloch ľahko rozpoznateľné: úvodný plánovací krok, ktorý porovná prístupy pred nasadením výskumných agentov, a záverečná kontrola zameraná na oblasti, v ktorých správy v minulosti dosahovali slabé výsledky. Keďže táto množina je malá a jej hodnotenie nákladné, nerozdelili sme ju a výsledok považujeme za skóre na trénovacích dátach.
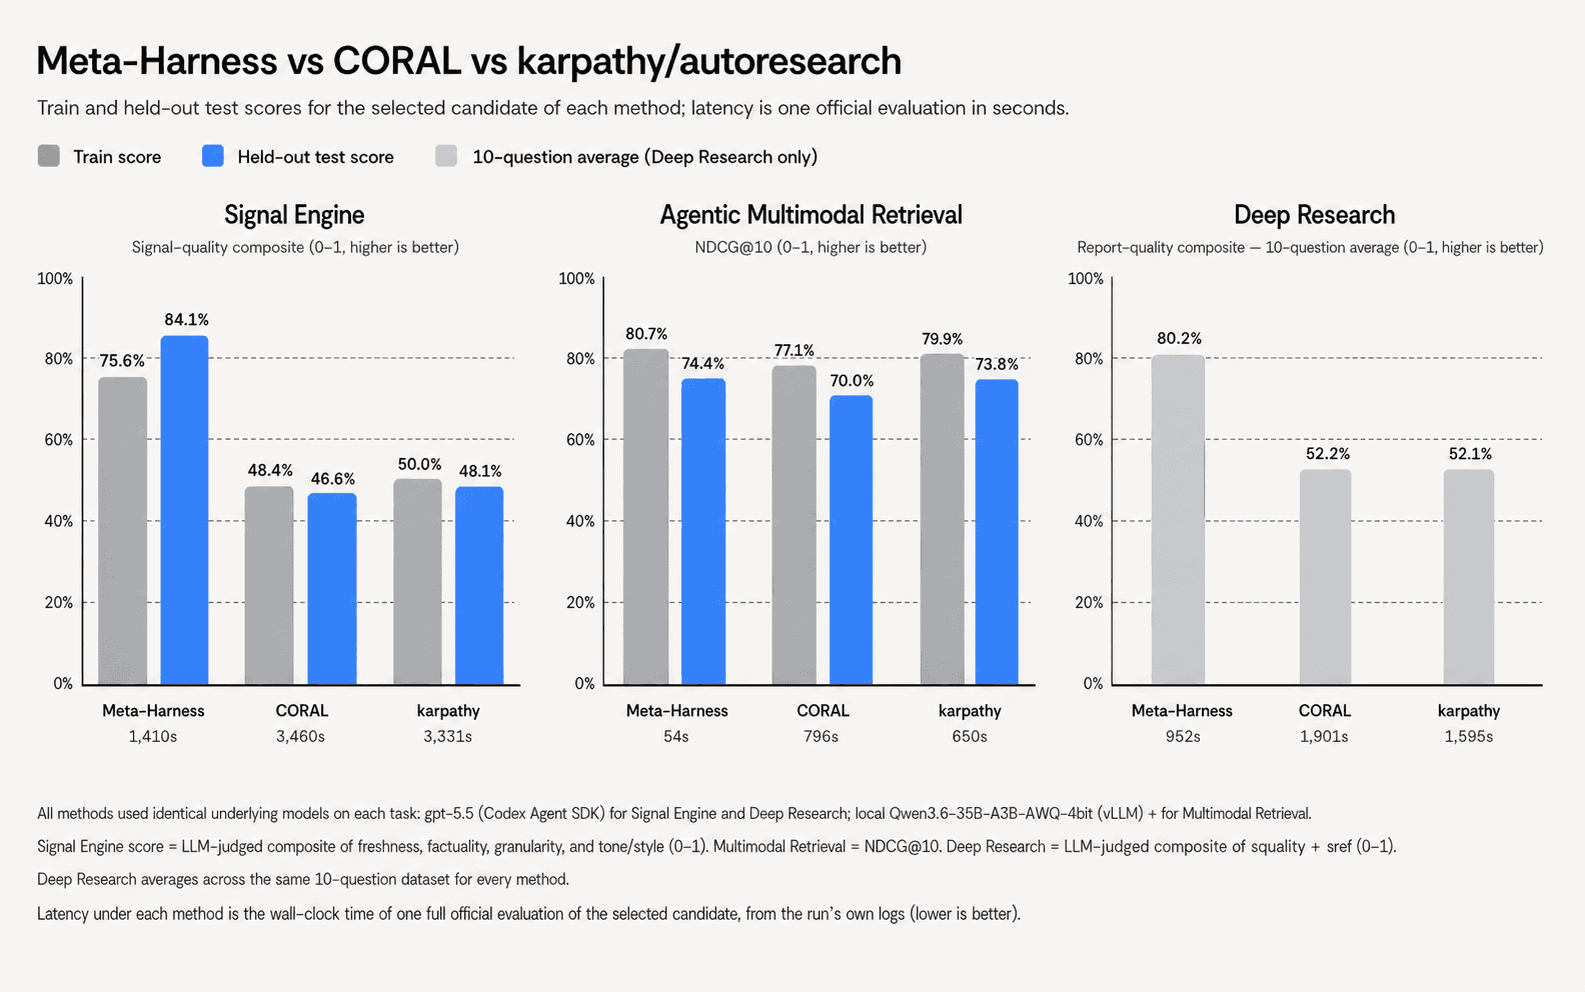
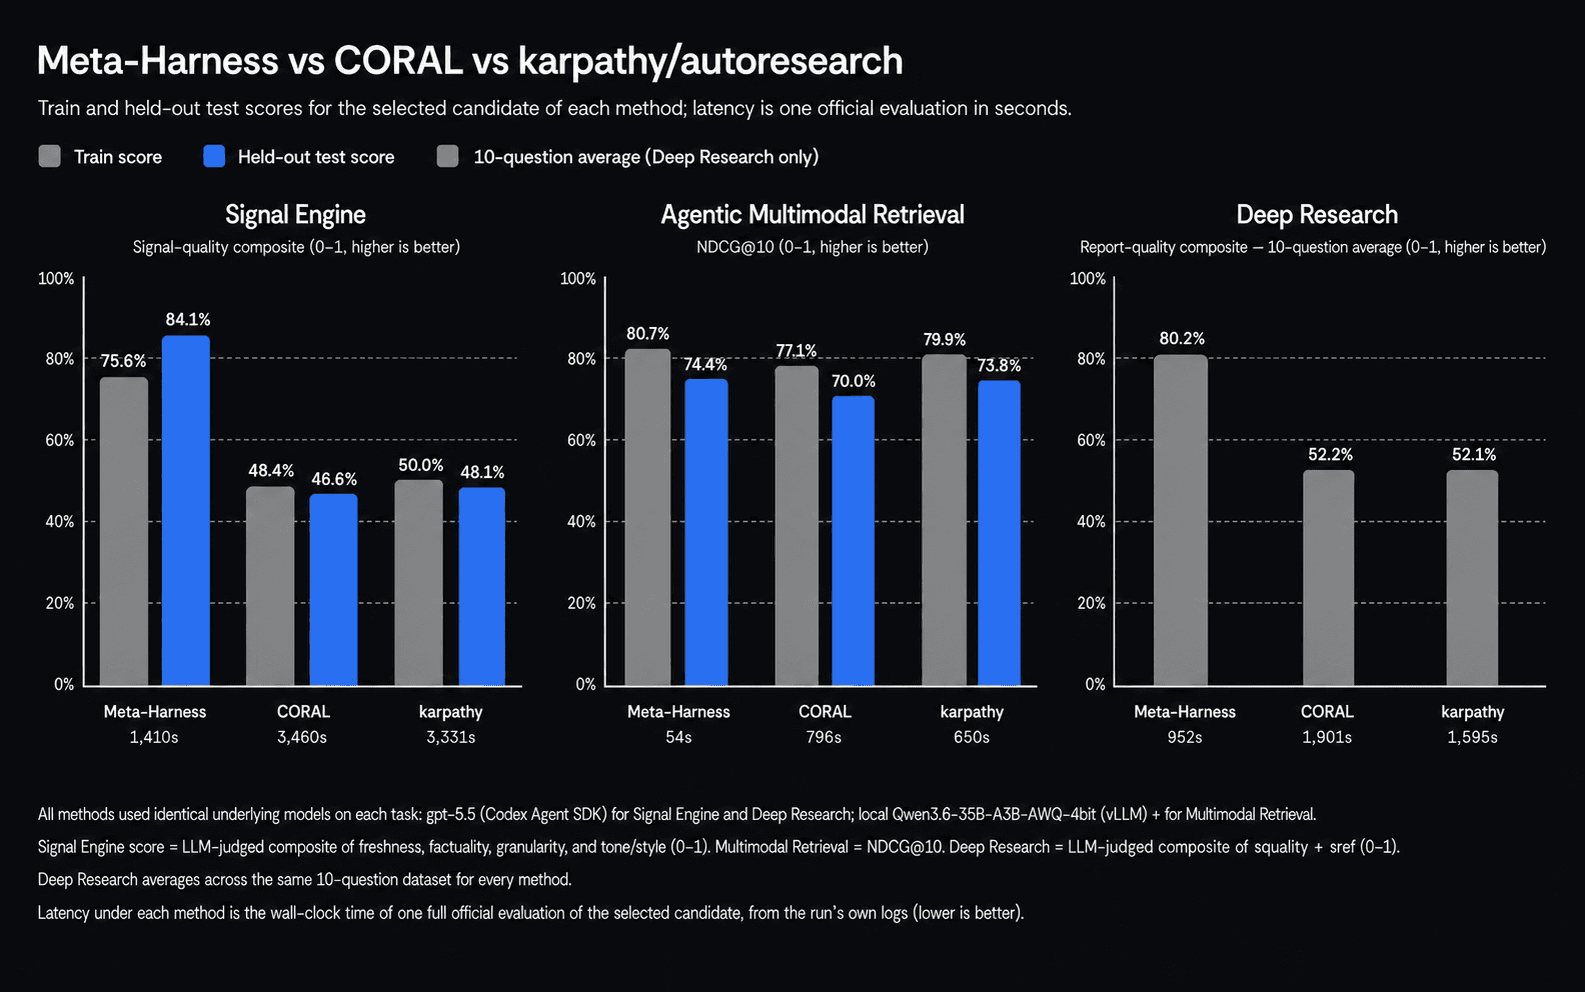
Všetky tri metódy sme porovnali pri rovnakom rozpočte: rovnaké množiny údajov, rovnaké základné modely, rovnaký limit iterácií a rovnaký celkový počet hodnotení kandidátov. Meta-Harness dosiahol v oddelenom teste Signal Engine skóre 0,841, zatiaľ čo obe východiskové metódy zostali pod hodnotou 0,50. Pri agentickom multimodálnom vyhľadávaní dosiahol náš tím najvyššie NDCG@10 v oddelenom teste (0,744 oproti 0,700 pri CORAL a 0,738 pri karpathy) a oficiálne hodnotenie vykonal dvanásť- až štrnásťkrát rýchlejšie: za 54 s oproti 786 s a 650 s. Pri hlbokom výskume dosiahol náš tím skóre 0,802, zatiaľ čo obe východiskové metódy zostali približne na hodnote 0,52. Pri všetkých výsledkoch platí jedna výhrada: CORAL a karpathy/autoresearch sme implementovali nanovo podľa ich publikovaných opisov. Časť rozdielu preto môže vyplývať z odlišnej implementácie, nielen zo samotných metód.
Rozdiel vysvetľujú štyri návrhové rozhodnutia. Po prvé, náš tím ešte pred úpravou kódu vytvorí štruktúrovanú návrhovú špecifikáciu. Tá ho vedie skôr k štrukturálnym zmenám, napríklad novým fázam procesu, než k úpravám príkazov. Po druhé, spúšťa súbežné vetvy založené na spoločnom aktuálne najlepšom kandidátovi. Zlepšenia sa tak hromadia rýchlejšie než pri nezávislých agentoch CORAL alebo striktne sekvenčnom cykle karpathy. Po tretie, každý pokus zanechá štruktúrované artefakty (skóre, denníky udalostí a štyri analýzy vytvorené LLM), ktoré si načíta ďalší navrhovateľ. Východiskové metódy uchovávajú iba jednoduché denníky pokusov. Po štvrté, adaptívny riadiaci systém po stagnácii nasmeruje navrhovateľa k prieskumu a po úspechu k zdokonaľovaniu. Prediktívne preraďovanie hypotéz navyše vyradí slabé nápady skôr, než spotrebujú rozpočet.
Krivky oddelených testov dokazujú zovšeobecnenie v rámci domény, nie prenos medzi doménami. Nemožno očakávať, že pracovný postup vyladený na získavanie signálov o trhu s AI bude bez opätovného spustenia harnessu fungovať rovnako dobre s právnymi či biomedicínskymi textami. Harness navyše optimalizuje iba cieľ definovaný hodnotiteľom. Hlučnú trénovaciu množinu alebo nesprávne kalibrovaného hodnotiteľa teda presne preučí. Pred serióznym behom odporúčame aspoň 20 kvalitne vybraných trénovacích položiek a samostatnú vývojovú časť dát. Najväčším praktickým obmedzením sú náklady. Každé hodnotenie opätovne spúšťa celý proces na všetkých častiach dát. Samotný vybraný kandidát vyhľadávania spotreboval približne 2,2 milióna vstupných tokenov a dôkladná optimalizácia s modelom triedy gpt-5.5 stojí pri jednej úlohe stovky až niekoľko tisíc dolárov. Tieto čísla napokon pochádzajú z jednotlivých behov, nie z opakovaných pokusov. Preto ich zverejňujeme ako technický blogový článok, a nie ako formálnu štúdiu.
Meta-Harness ukazuje, že autonómne zlepšovanie kódu môže byť dostatočne disciplinované na podnikové využitie. Základom sú štrukturálne hypotézy, prediktívne predbežné filtrovanie, izolované hodnotenie, testovanie na oddelených dátach všade, kde to údaje umožňujú, a úplný auditný záznam každej prijatej zmeny. Technickému tímu spoločne poskytujú predvídateľnú cestu od funkčného východiskového procesu k preukázateľne lepšiemu. Prevádzkovému vedúcemu ponúkajú jednoduchý model: výhody autonómneho prieskumu v prísnom rámci zohľadňujúcom rozpočet, pričom pred nasadením vždy rozhoduje človek.