У большинства команд, внедряющих агентное программирование, узкое место смещается с генерации на проверку, и без перестройки этого цикла прирост общей скорости близок к нулю.
В масштабных CI-средах с миллионами еженочных тестов и сотнями инженеров самая ценная задача для агента — определить ответственных и провести первичный анализ, а не генерировать код.
Полезный результат работы агента выдерживает тщательную проверку и объясняет причинно-следственные связи, а не просто выявляет совпадения с известными шаблонами.
Продумать уровень сбора свидетельств и формирования контекста важнее, чем уровень генерации.
Большинство разговоров об агентном программировании по-прежнему начинается с простого обещания: писать больше кода и делать это быстрее.
Иногда оно перерастает в более амбициозную концепцию: агенты планируют работу, открывают PR и выпускают изменения с минимальным участием человека. Но для большинства инженерных команд наиболее очевидная краткосрочная выгода гораздо конкретнее. Она заключается в снижении затрат на итерации.
Разработка и выпуск ПО — это не только генерация кода. Написание кода — лишь один из этапов продолжительного цикла, который также включает проверку, тестирование, развертывание и расследование сбоев. Большинство команд, внедряющих агентное программирование без перестройки цикла проверки, лишь перемещают узкое место на следующий этап.
Само по себе ускорение генерации не означает, что команда автоматически начнет работать быстрее. Оно может лишь увеличить объем работы, связанной с проверкой, подтверждением корректности и обеспечением доверия.
Во многих инженерных средах основная сложность не в создании первого варианта, а в обретении уверенности в его корректности.
Действительно ли изменение устранило проблему или улучшило систему? Не привело ли оно к регрессии в другом месте? Причина сбоя — в коде, среде, тестах или зависимости? Предложенное исправление устраняет причину или лишь видимый симптом?
Здесь агенты могут помочь не потому, что заменяют инженеров, а потому, что способны провести структурированный первичный анализ разрозненных данных: изучить журналы, сопоставить недавние изменения, обобщить значимые сигналы, проследить вероятные причины, выполнить проверки и предоставить человеку результат для дальнейшего изучения.
Во многих командах наиболее эффективное применение агента — вовсе не генерация кода с нуля. Его задача — сузить область поиска проблемы, прежде чем человек потратит часы на это вручную.
Особенно наглядно это проявляется в масштабных процессах отладки. Представьте, что в рамках еженочного CI выполняются миллионы тестов в кодовых базах, которые изменяют сотни инженеров. Для одного из наших клиентов это реальность. При сбое бывает сложно определить ответственную команду. Проблема может находиться в коде приложения, зависимости, тестовой обвязке или другой части стека. Объем журналов может достигать гигабайтов, а команда, первой обнаружившая проблему, не всегда отвечает за затронутый компонент.
Такой процесс по своей природе не предполагает, что один агент напишет исправление. Для него нужна система, которая быстро сужает область поиска проблемы.
Эффективный конвейер может получать журналы, отбирать значимые свидетельства, обобщать главное, изучать код в изолированной среде и выдавать структурированный анализ первопричины с оценкой уверенности, прослеживаемостью и рекомендациями по дальнейшим действиям. Чтобы сформировать оценку уверенности, профильный эксперт оценивает первоначальный результат работы агента. Затем эти данные передаются LLM-судье, чтобы в дальнейшем автоматизировать оценивание, сохранив согласованность с экспертным мнением человека.
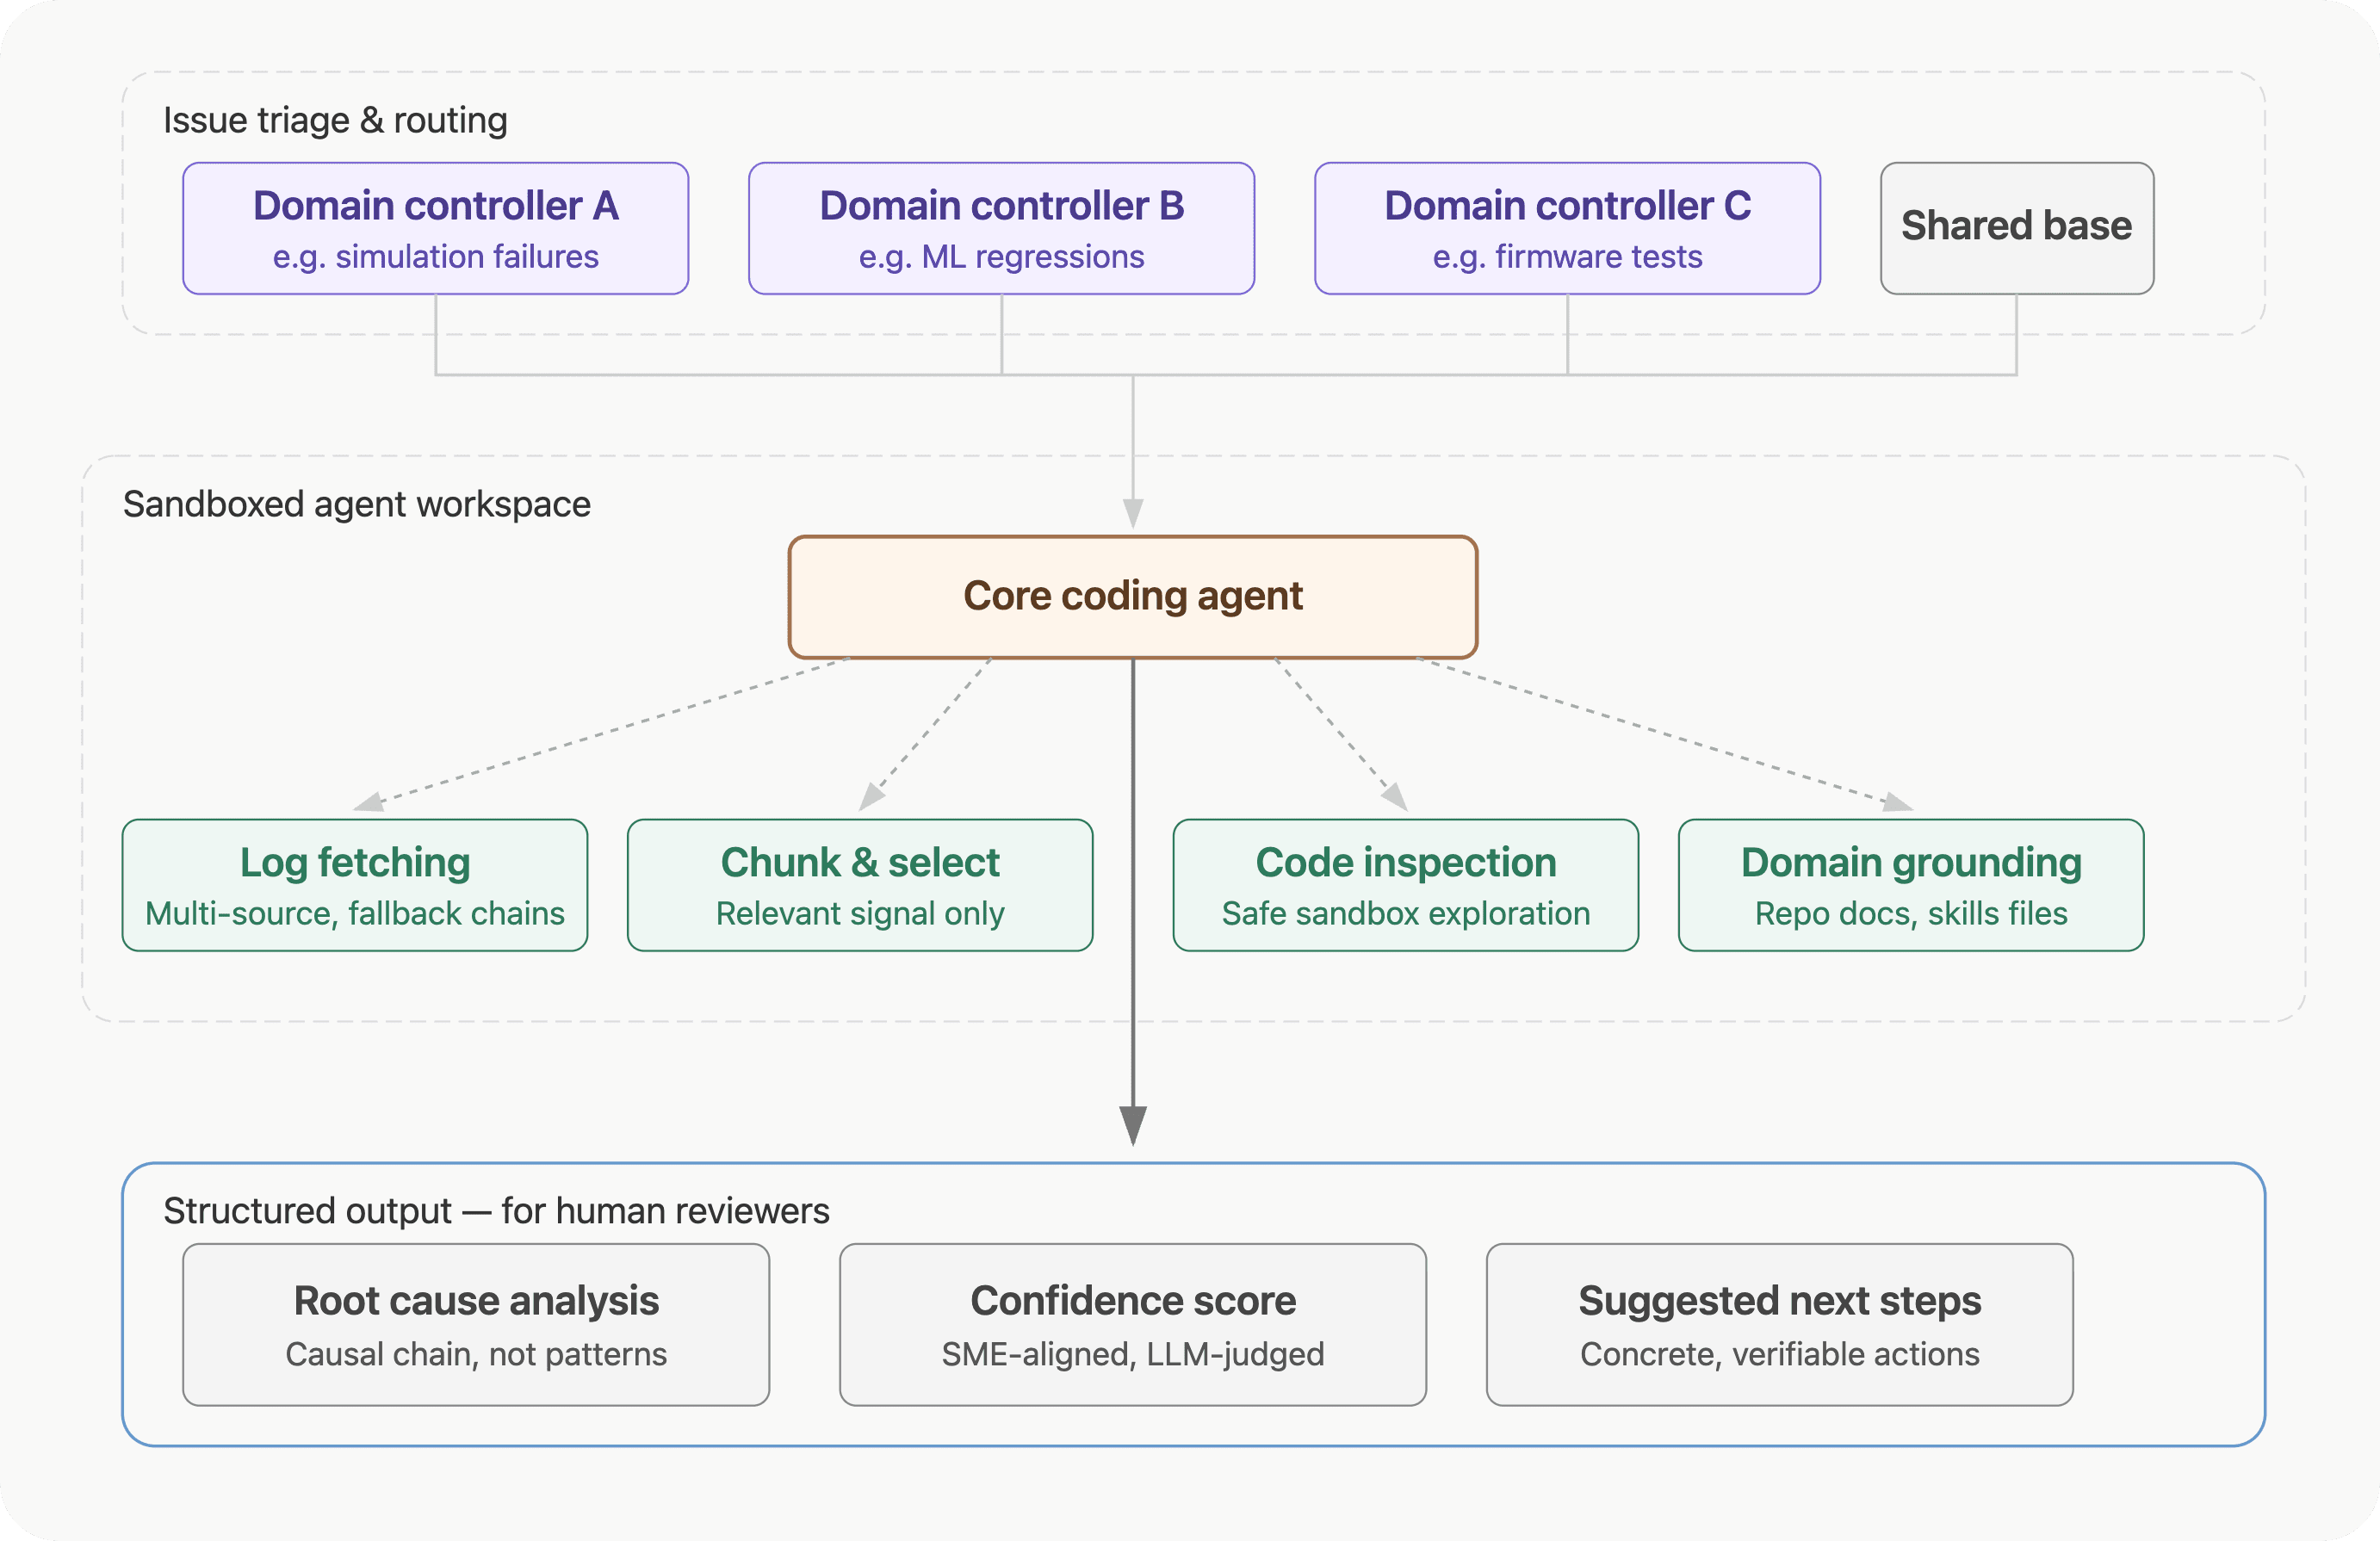
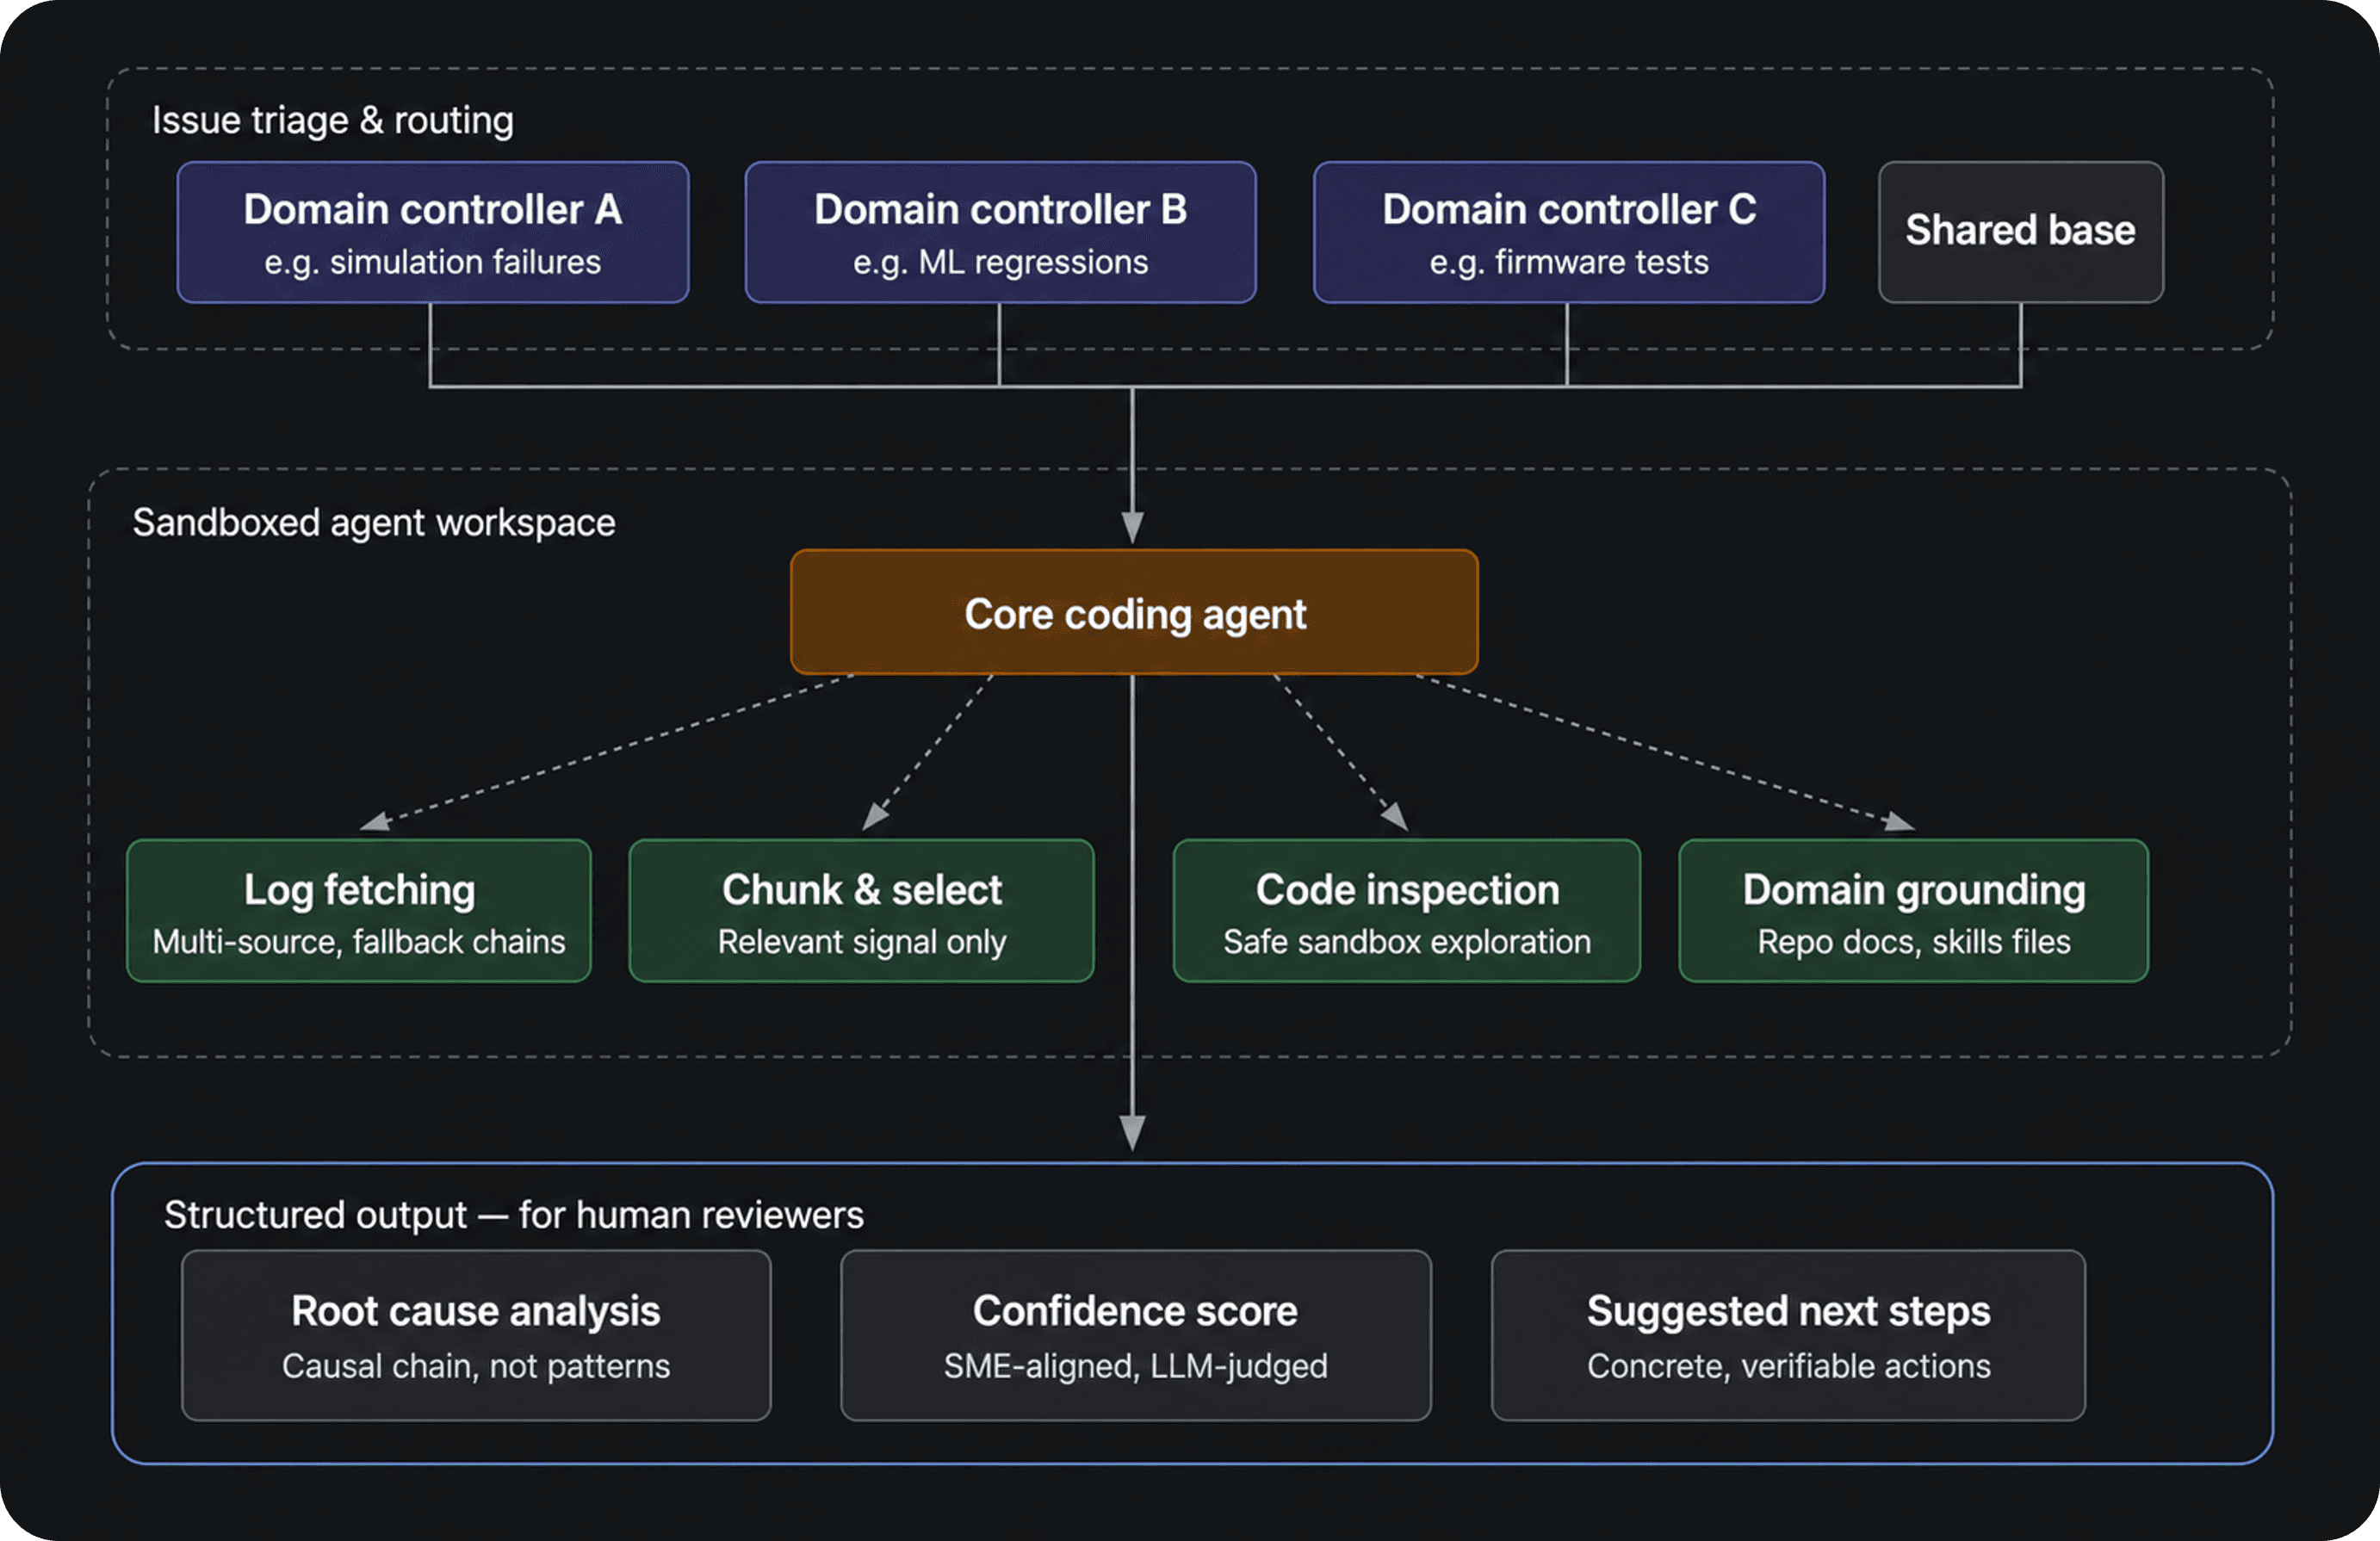
Цель не в том, чтобы исключить инженерное суждение, а в том, чтобы дать проверяющим более надежную отправную точку. Анализ регрессий, проверка PR, исправление тестов, валидация релизов и расследование после развертывания устроены одинаково. Все они требуют изучения множества свидетельств и тщательной проверки, а также сопряжены с неопределенностью. Агент должен не заменять инженерный процесс, а лишь помогать продвигать его вперед.
По этой же причине командам следует внимательно выбирать способы оценки таких систем.
Неправильно спрашивать, способен ли агент сам по себе создать нечто впечатляющее. Лучше спросить, совершенствует ли он реальный рабочий процесс, не создавая помех на других этапах.
Для этого нужно понять, достаточно ли конкретен результат для проверки, объясняет ли он причинно-следственные связи, а не просто совпадения с известными шаблонами, и упрощает ли проверку, а не усложняет ее. Правдоподобный ответ не обязательно полезен. На практике команды доверяют результатам работы агента, если они выдерживают тщательную проверку и содержат конкретные утверждения, которые можно подтвердить.
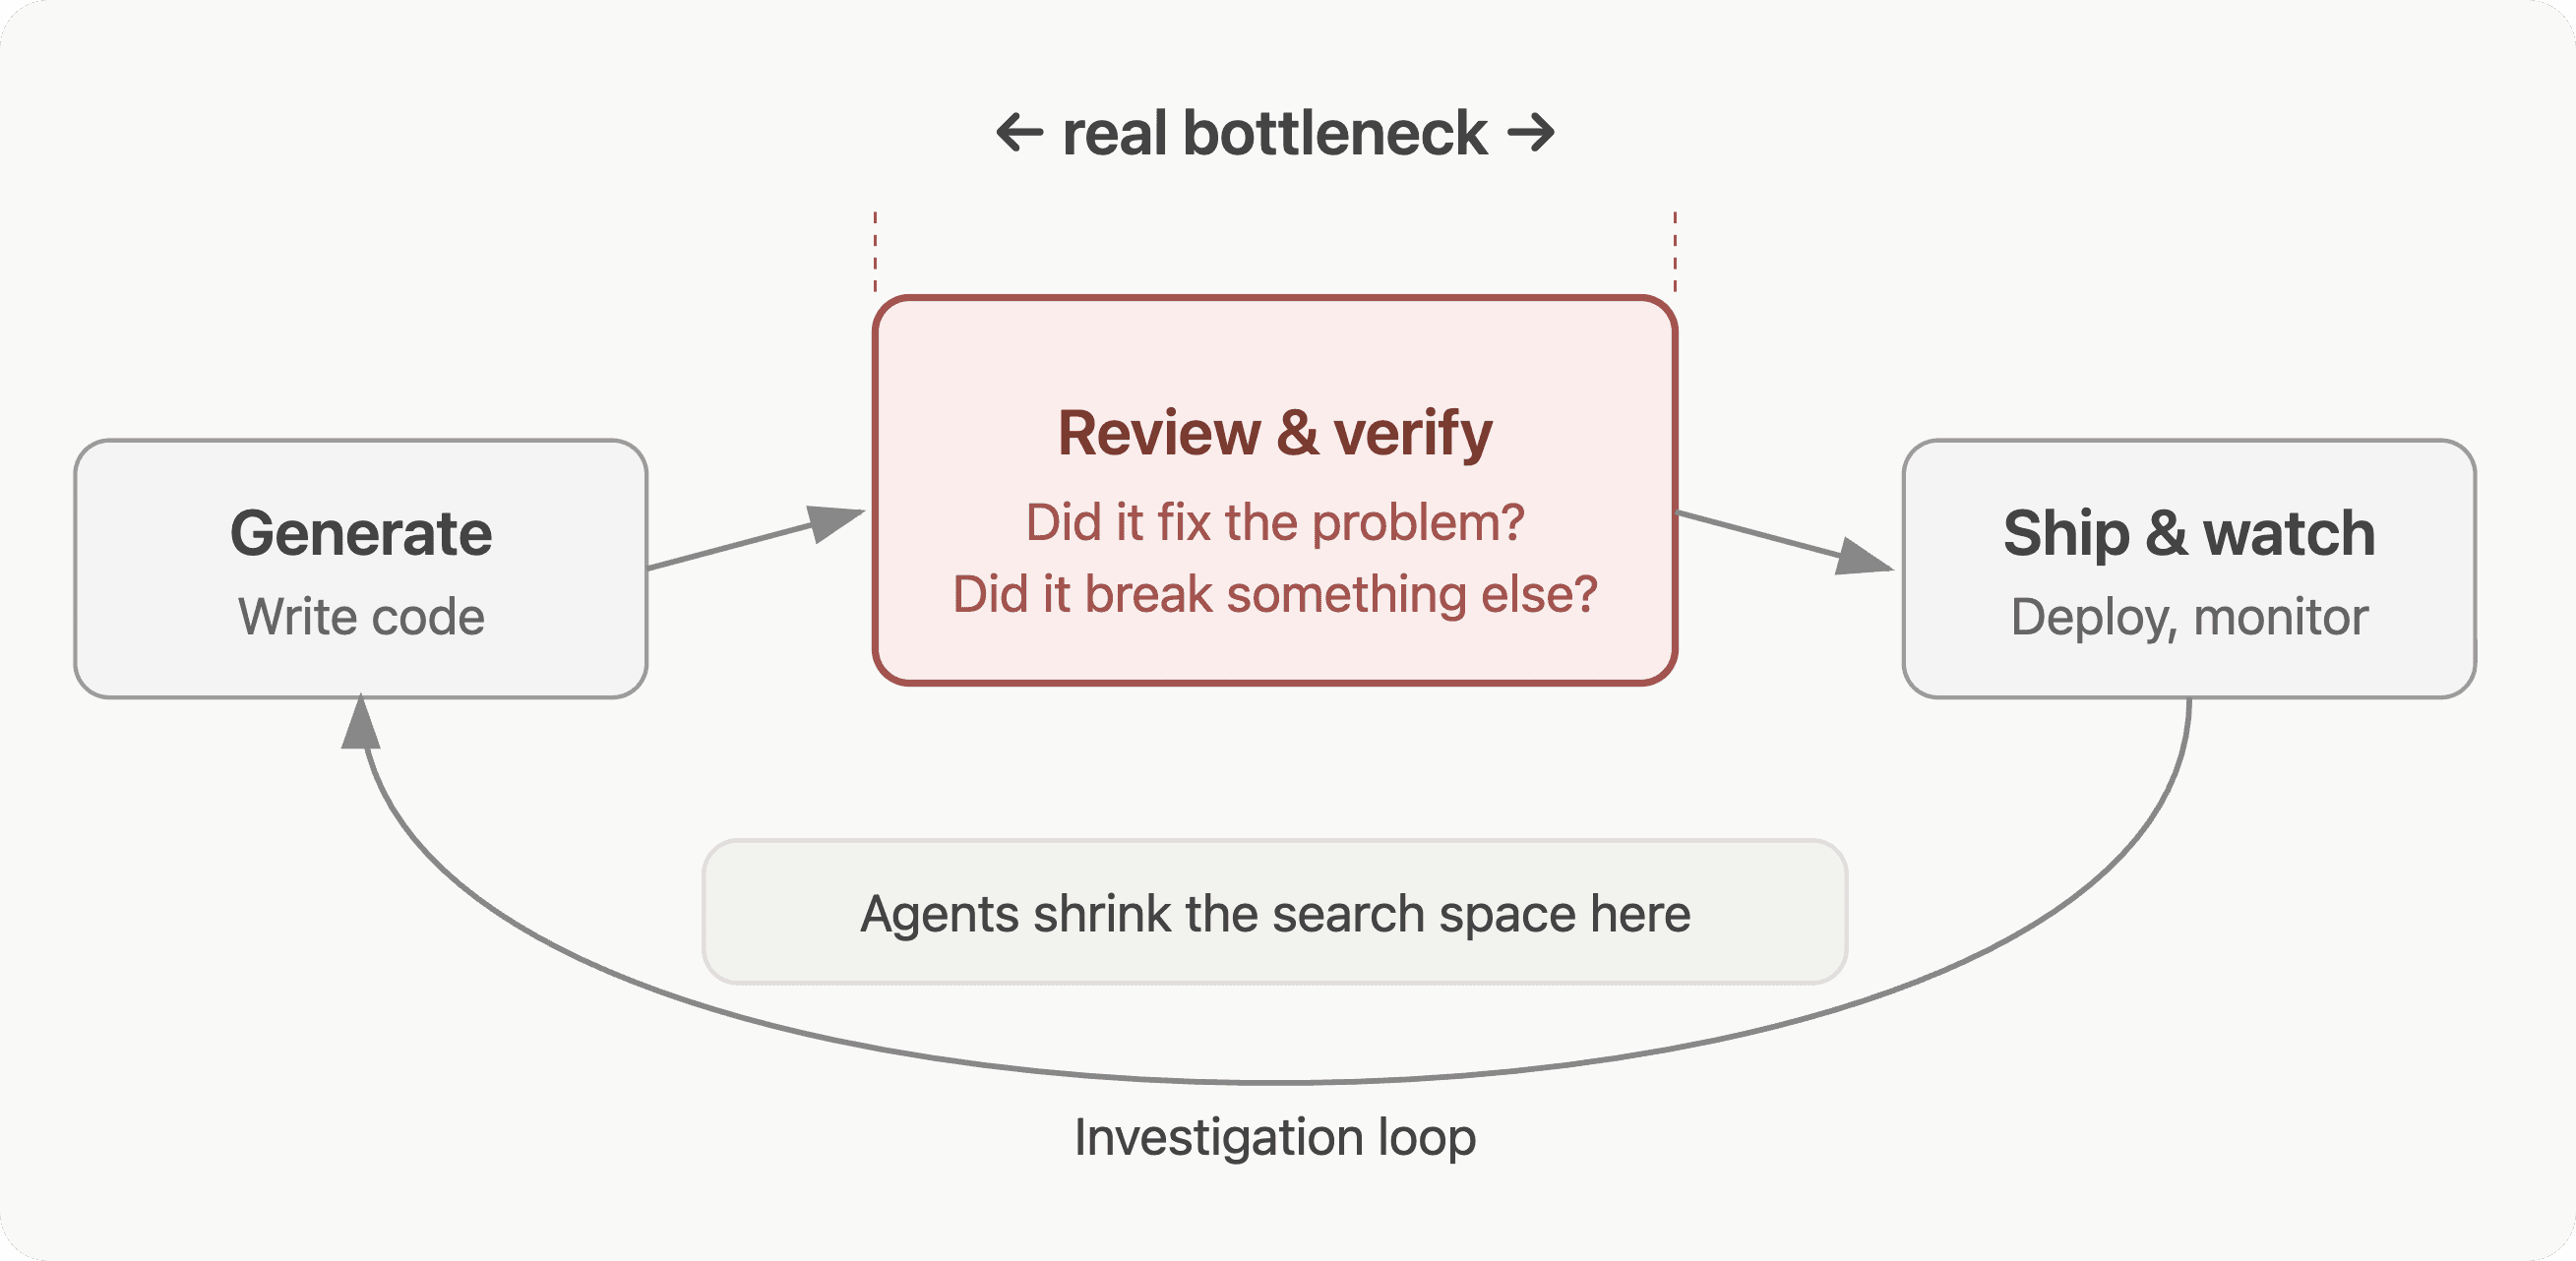
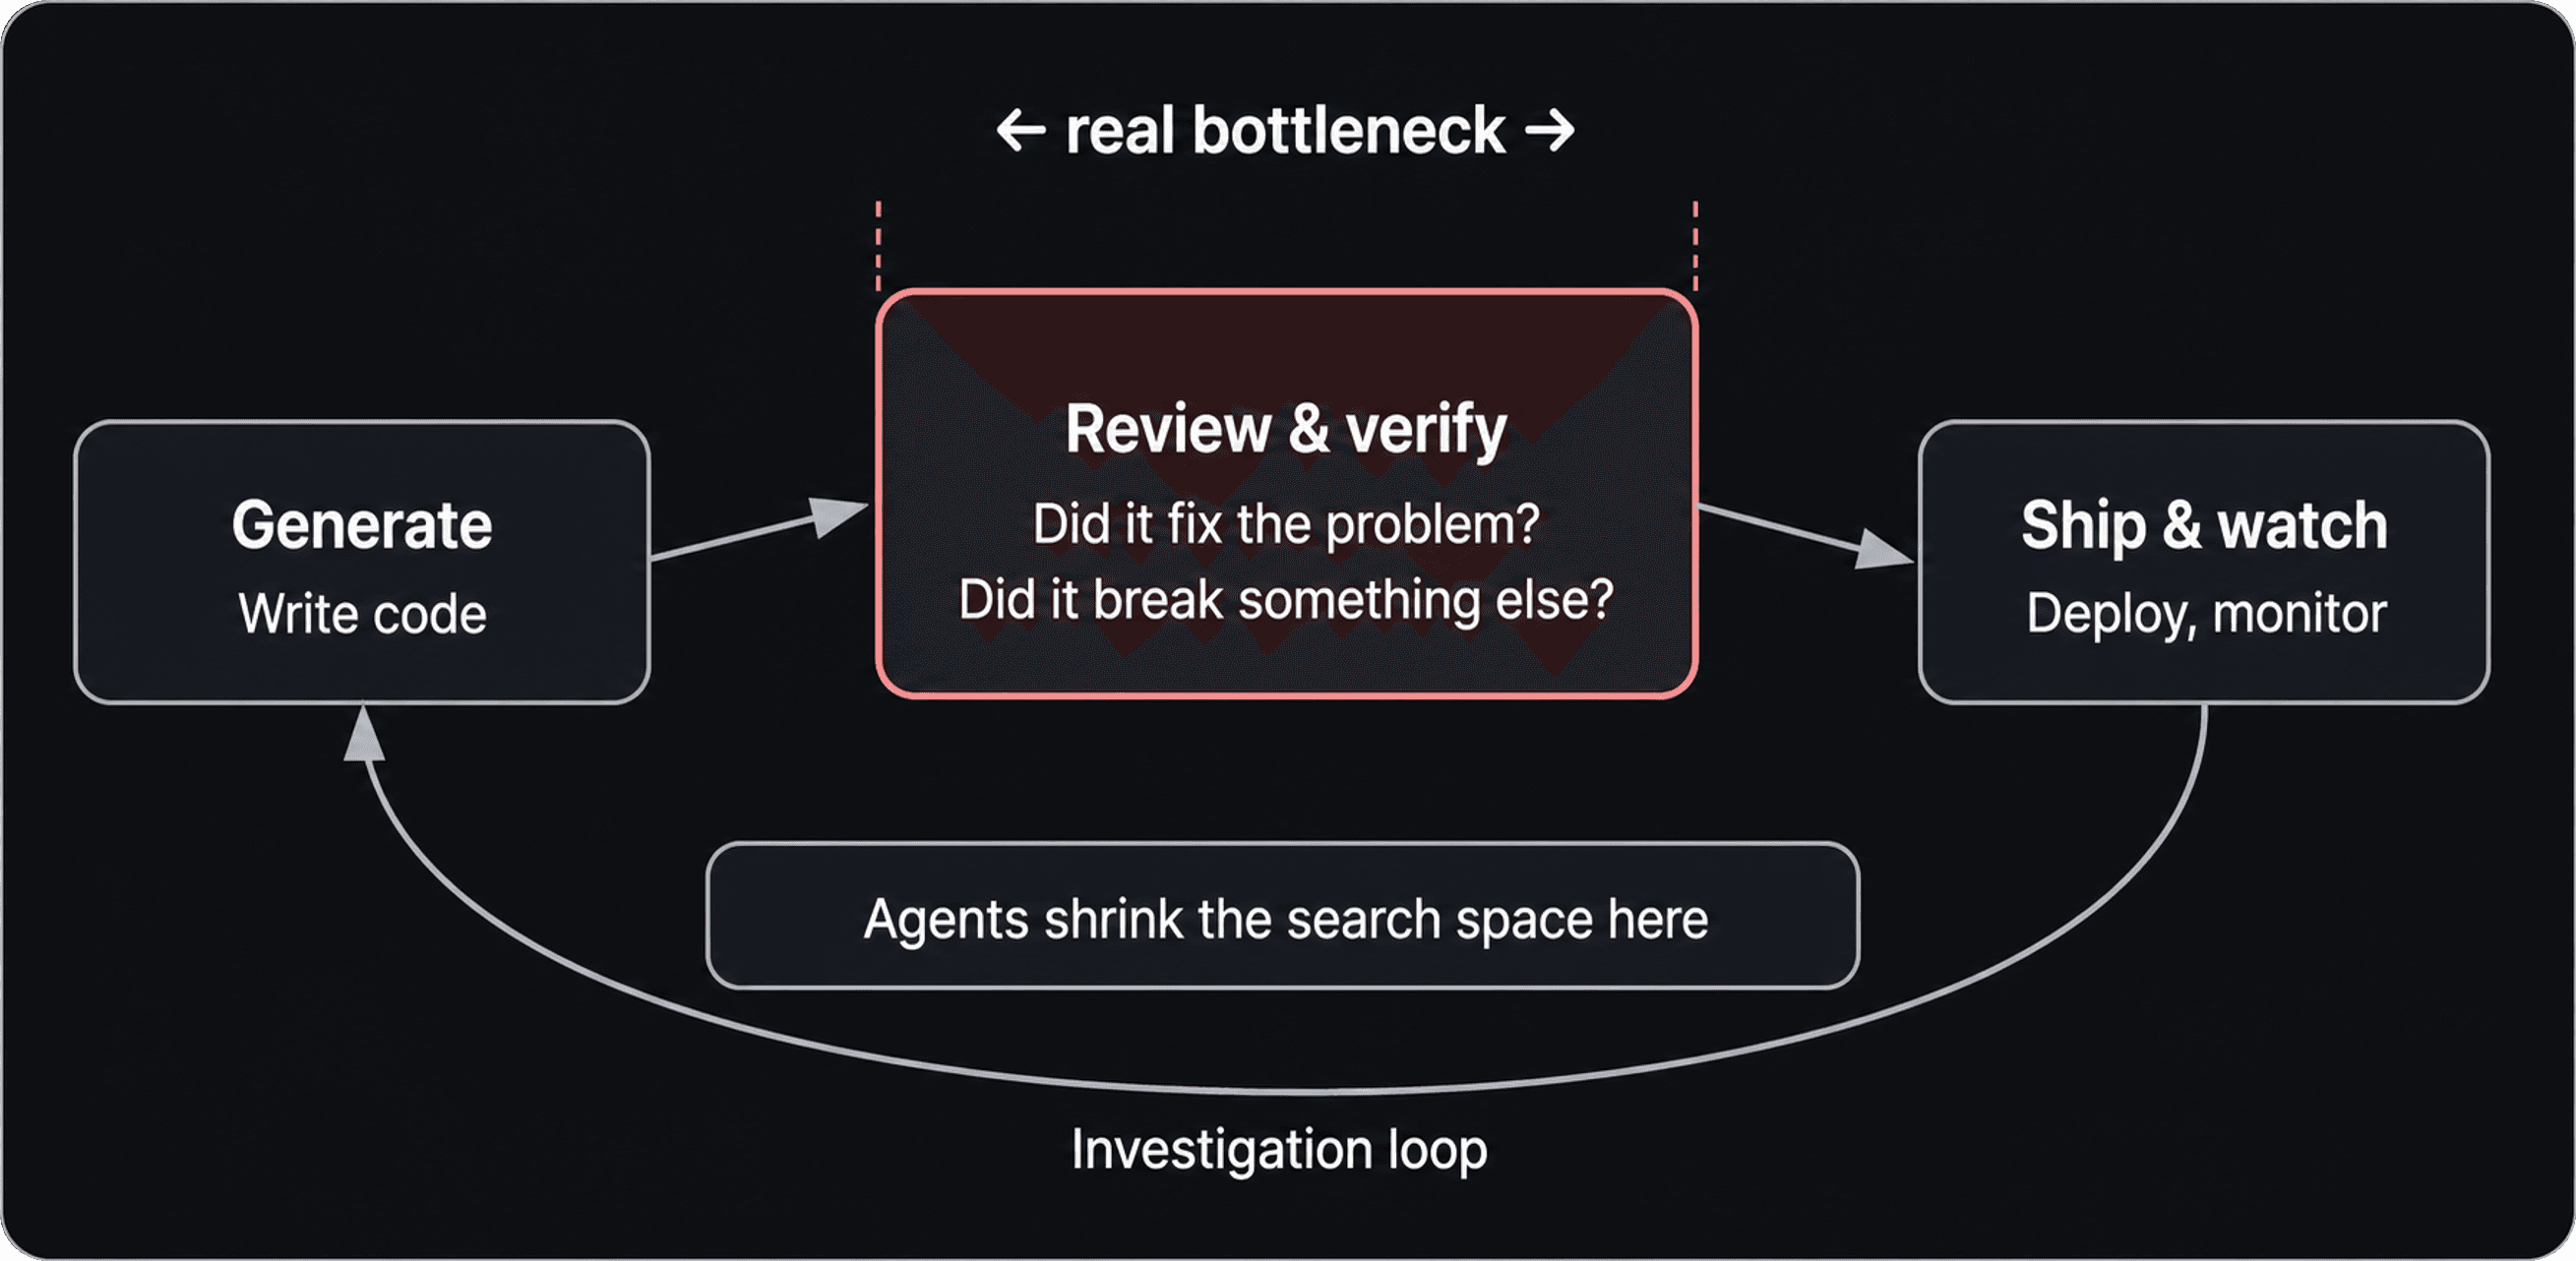
Главный вывод заключается в том, что полезным агентным системам одной генерации недостаточно. Их эффективность зависит от того, как собираются свидетельства, формируется контекст, проверяются результаты и представляется проверяющему информация о неопределенности.
Поэтому в ближайшем будущем агентная разработка вряд ли совершит один гигантский скачок к полной автономности. Скорее появится набор тщательно спроектированных циклов, в которых агенты помогают командам анализировать, проверять, подтверждать и совершенствовать свою работу, сокращая лишние усилия между этапами.
Это может выглядеть не так эффектно, как масштабная концепция автономности, зато гораздо точнее отражает реальное внедрение полезных систем.