W większości zespołów wdrażających kodowanie agentowe wąskim gardłem przestaje być generowanie, a staje się nim przegląd kodu. Bez usprawnienia tego cyklu wzrost tempa pracy jest bliski zeru.
W środowiskach CI działających na dużą skalę (z milionami testów wykonywanych co noc i setkami inżynierów) największą wartość daje wykorzystanie agenta do kierowania zgłoszeń do właściwych zespołów i ich wstępnej analizy, a nie do generowania kodu.
Wynik pracy agenta ma wartość, jeśli przechodzi on szczegółową weryfikację i wyjaśnia związki przyczynowe, zamiast jedynie dopasowywać wzorce.
Zaprojektowanie warstwy gromadzenia informacji i budowania kontekstu jest ważniejsze niż zaprojektowanie warstwy generowania.
Większość dyskusji o kodowaniu agentowym nadal zaczyna się od prostej obietnicy: więcej kodu w krótszym czasie.
Czasami wizja ta staje się ambitniejsza: agenci planują pracę, otwierają PR-y i wdrażają zmiany przy minimalnej ingerencji człowieka. Jednak dla większości zespołów inżynieryjnych najbardziej oczywista krótkoterminowa korzyść ma węższy zakres. Chodzi o obniżenie kosztu kolejnych iteracji.
Dostarczanie oprogramowania nie sprowadza się do generowania kodu. Pisanie kodu to tylko jeden etap dłuższego cyklu, który obejmuje przegląd, testowanie, wdrożenie oraz analizę problemów, gdy coś pójdzie nie tak. Większość zespołów, które wdrażają kodowanie agentowe bez przeprojektowania cyklu przeglądu, jedynie sprawia, że wąskie gardło pojawia się na późniejszym etapie.
Samo przyspieszenie generowania nie sprawia automatycznie, że zespół pracuje szybciej. Może jedynie oznaczać więcej pracy przy przeglądzie, weryfikacji i budowaniu zaufania.
W wielu środowiskach inżynieryjnych kosztownym etapem nie jest stworzenie pierwszej wersji, lecz uzyskanie pewności, że jest ona właściwa.
Czy zmiana rzeczywiście rozwiązała problem lub usprawniła system? Czy spowodowała regresję w innym miejscu? Czy źródłem awarii jest kod, środowisko, testy czy zależność? Czy proponowana poprawka usuwa przyczynę, czy tylko widoczny objaw?
Agenci mogą w tym pomóc nie dlatego, że zastępują inżynierów, ale dlatego, że potrafią przeprowadzić systematyczną wstępną analizę nieuporządkowanych informacji: sprawdzić logi, porównać ostatnie zmiany, podsumować istotne sygnały, prześledzić prawdopodobne przyczyny, wykonać testy i przedstawić wynik, który człowiek może zweryfikować.
W wielu zespołach generowanie kodu od podstaw nie jest zastosowaniem agenta, które zapewnia największe korzyści. Większą wartość daje zawężenie obszaru poszukiwań, zanim człowiek poświęci wiele godzin na ręczną analizę.
Widać to szczególnie wyraźnie w procesach debugowania na dużą skalę. Wyobraźmy sobie nocny proces CI, który wykonuje miliony testów w bazach kodu modyfikowanych przez setki inżynierów (dla jednego z naszych klientów to codzienność). Gdy coś zawiedzie, trudno skierować problem do właściwego zespołu. Problem może tkwić w kodzie aplikacji, zależności, otoczeniu operacyjnym testów albo w innej warstwie stosu. Logi mogą zajmować wiele gigabajtów, a zespół, który jako pierwszy zauważy problem, nie zawsze jest za niego odpowiedzialny.
Taki proces nie wymaga jednego agenta, który napisze poprawkę. Lepiej sprawdzi się tu system, który szybko zawęża obszar problemu.
Taki potok może pobierać logi, wybierać istotne informacje, podsumowywać najważniejsze z nich, analizować kod w piaskownicy i tworzyć uporządkowaną analizę przyczyn źródłowych wraz z oceną poziomu pewności, możliwością prześledzenia toku analizy oraz sugerowanymi kolejnymi krokami. Aby wyznaczyć poziom pewności, ekspert dziedzinowy ocenia początkowy wynik pracy agenta. Ta ocena trafia następnie do LLM pełniącego rolę sędziego, aby zautomatyzować kolejne oceny przy zachowaniu zgodności z osądem człowieka.
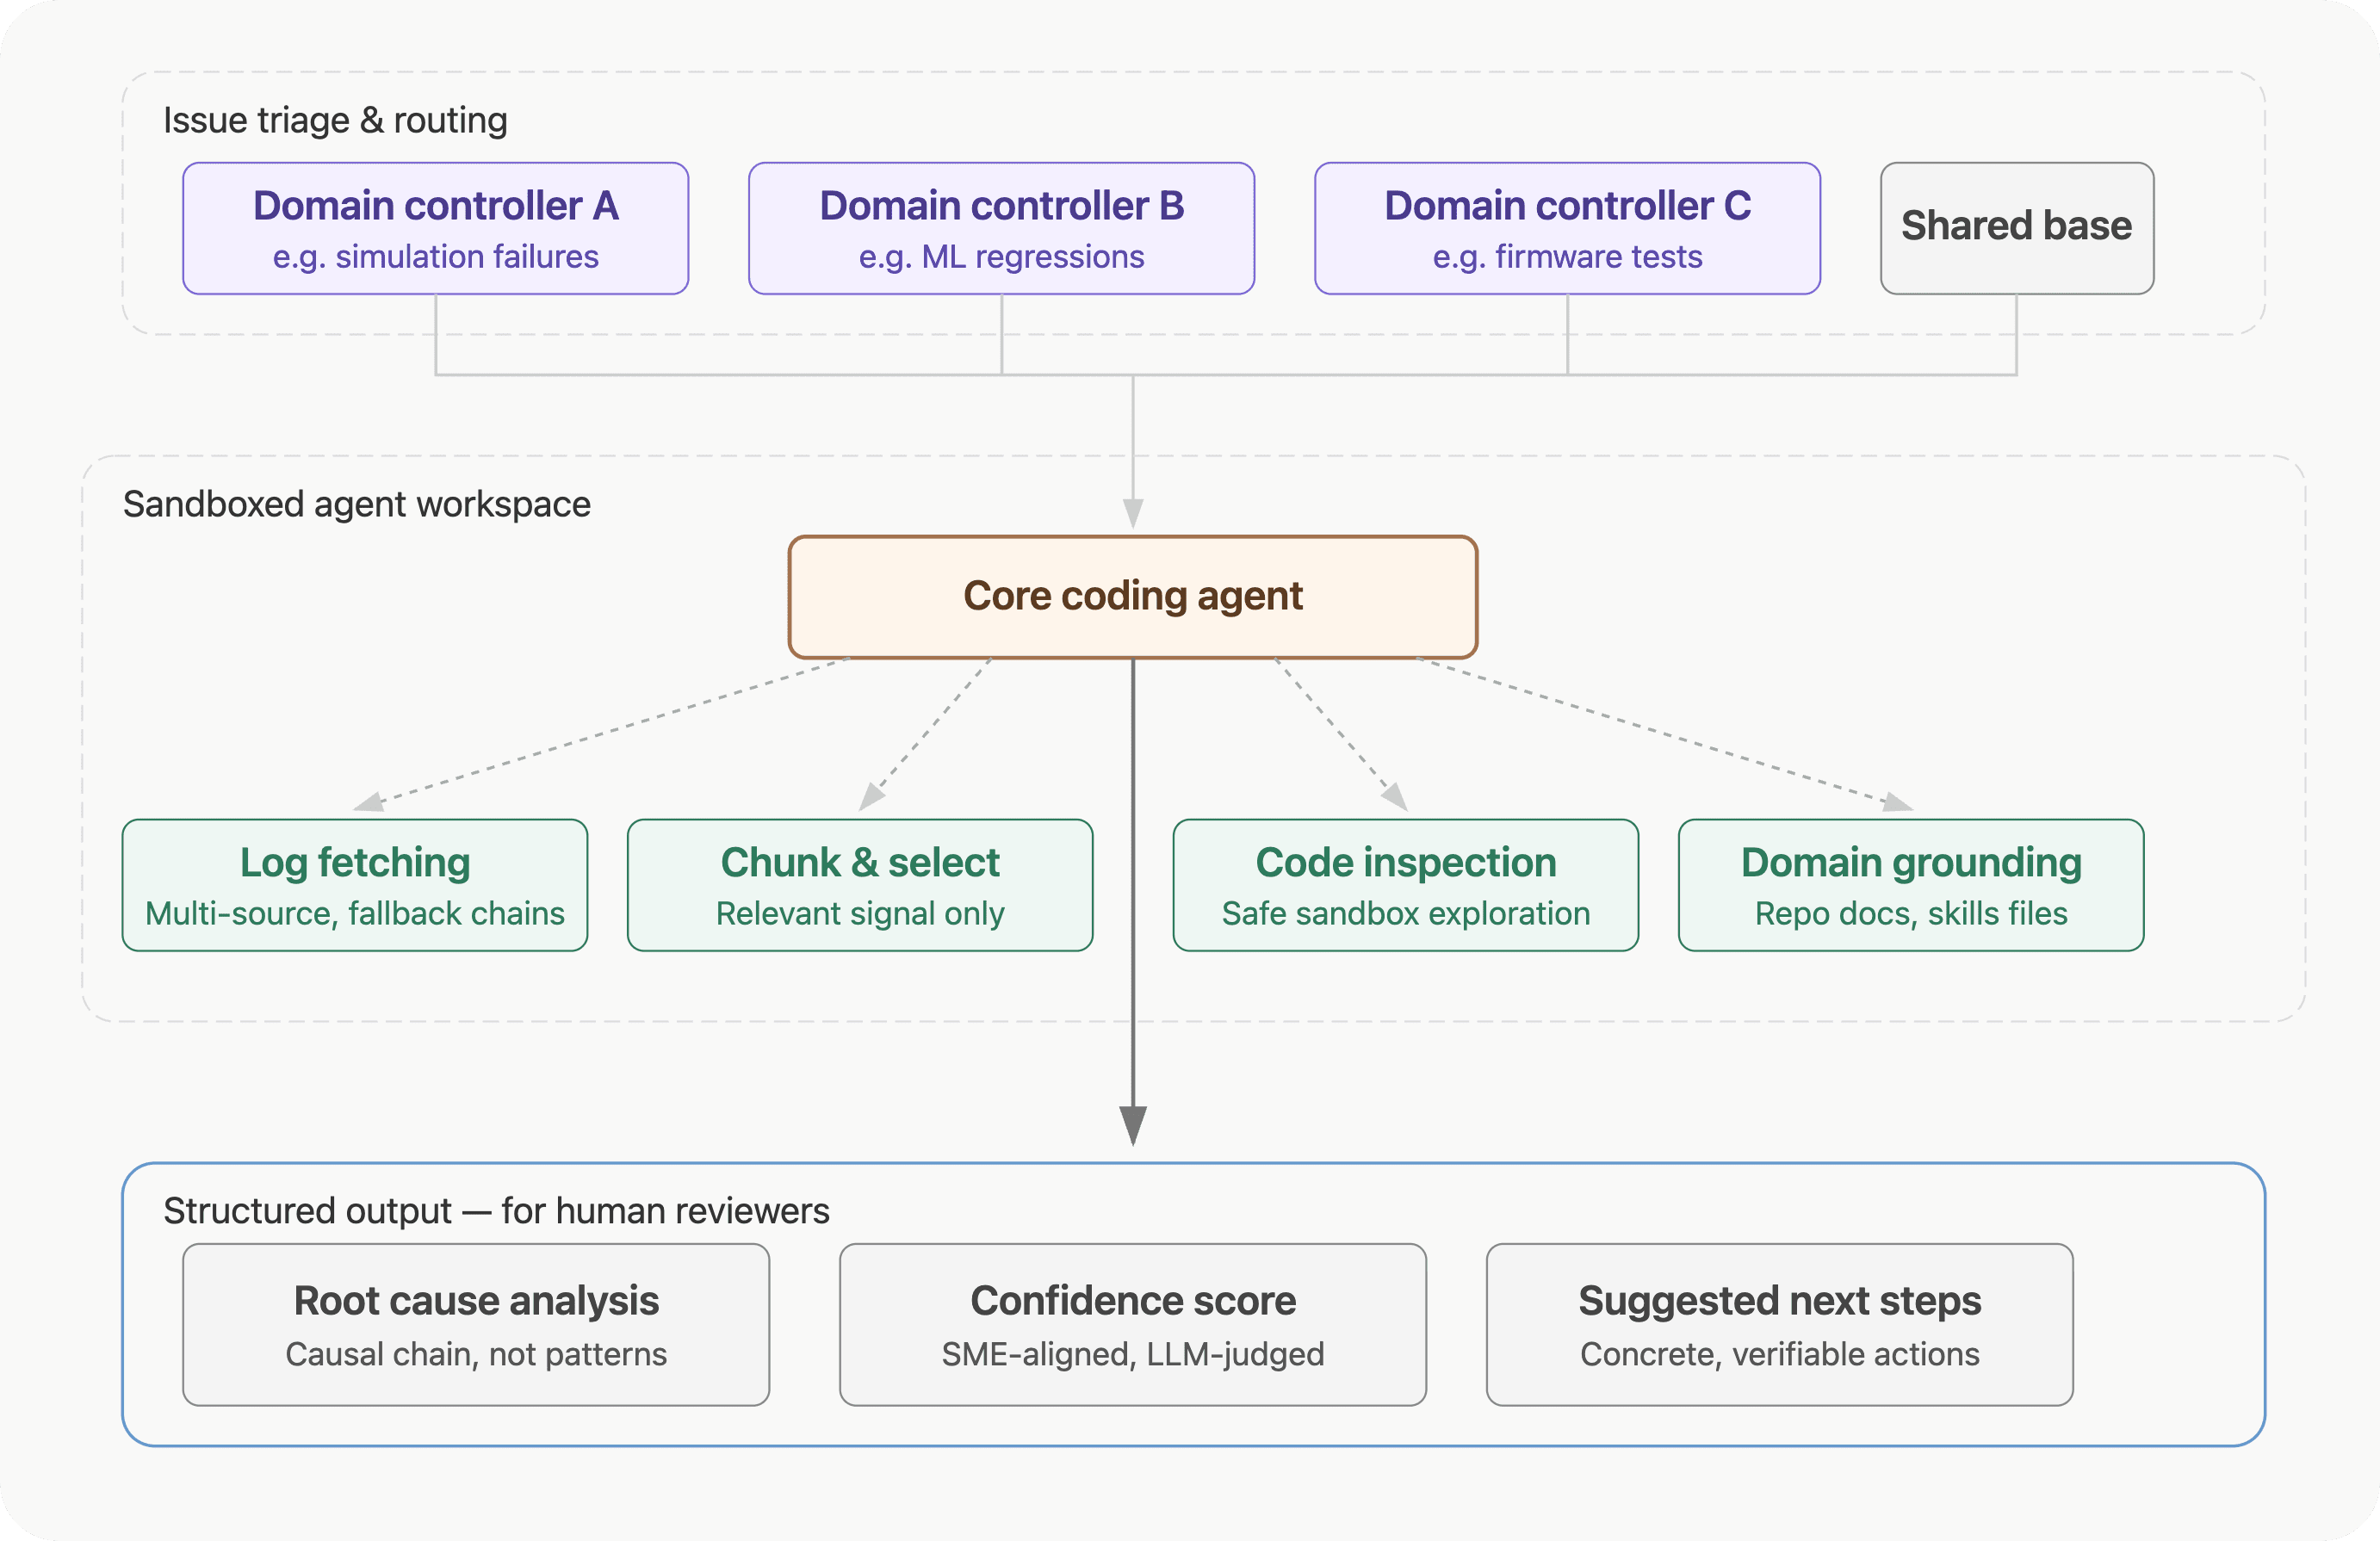
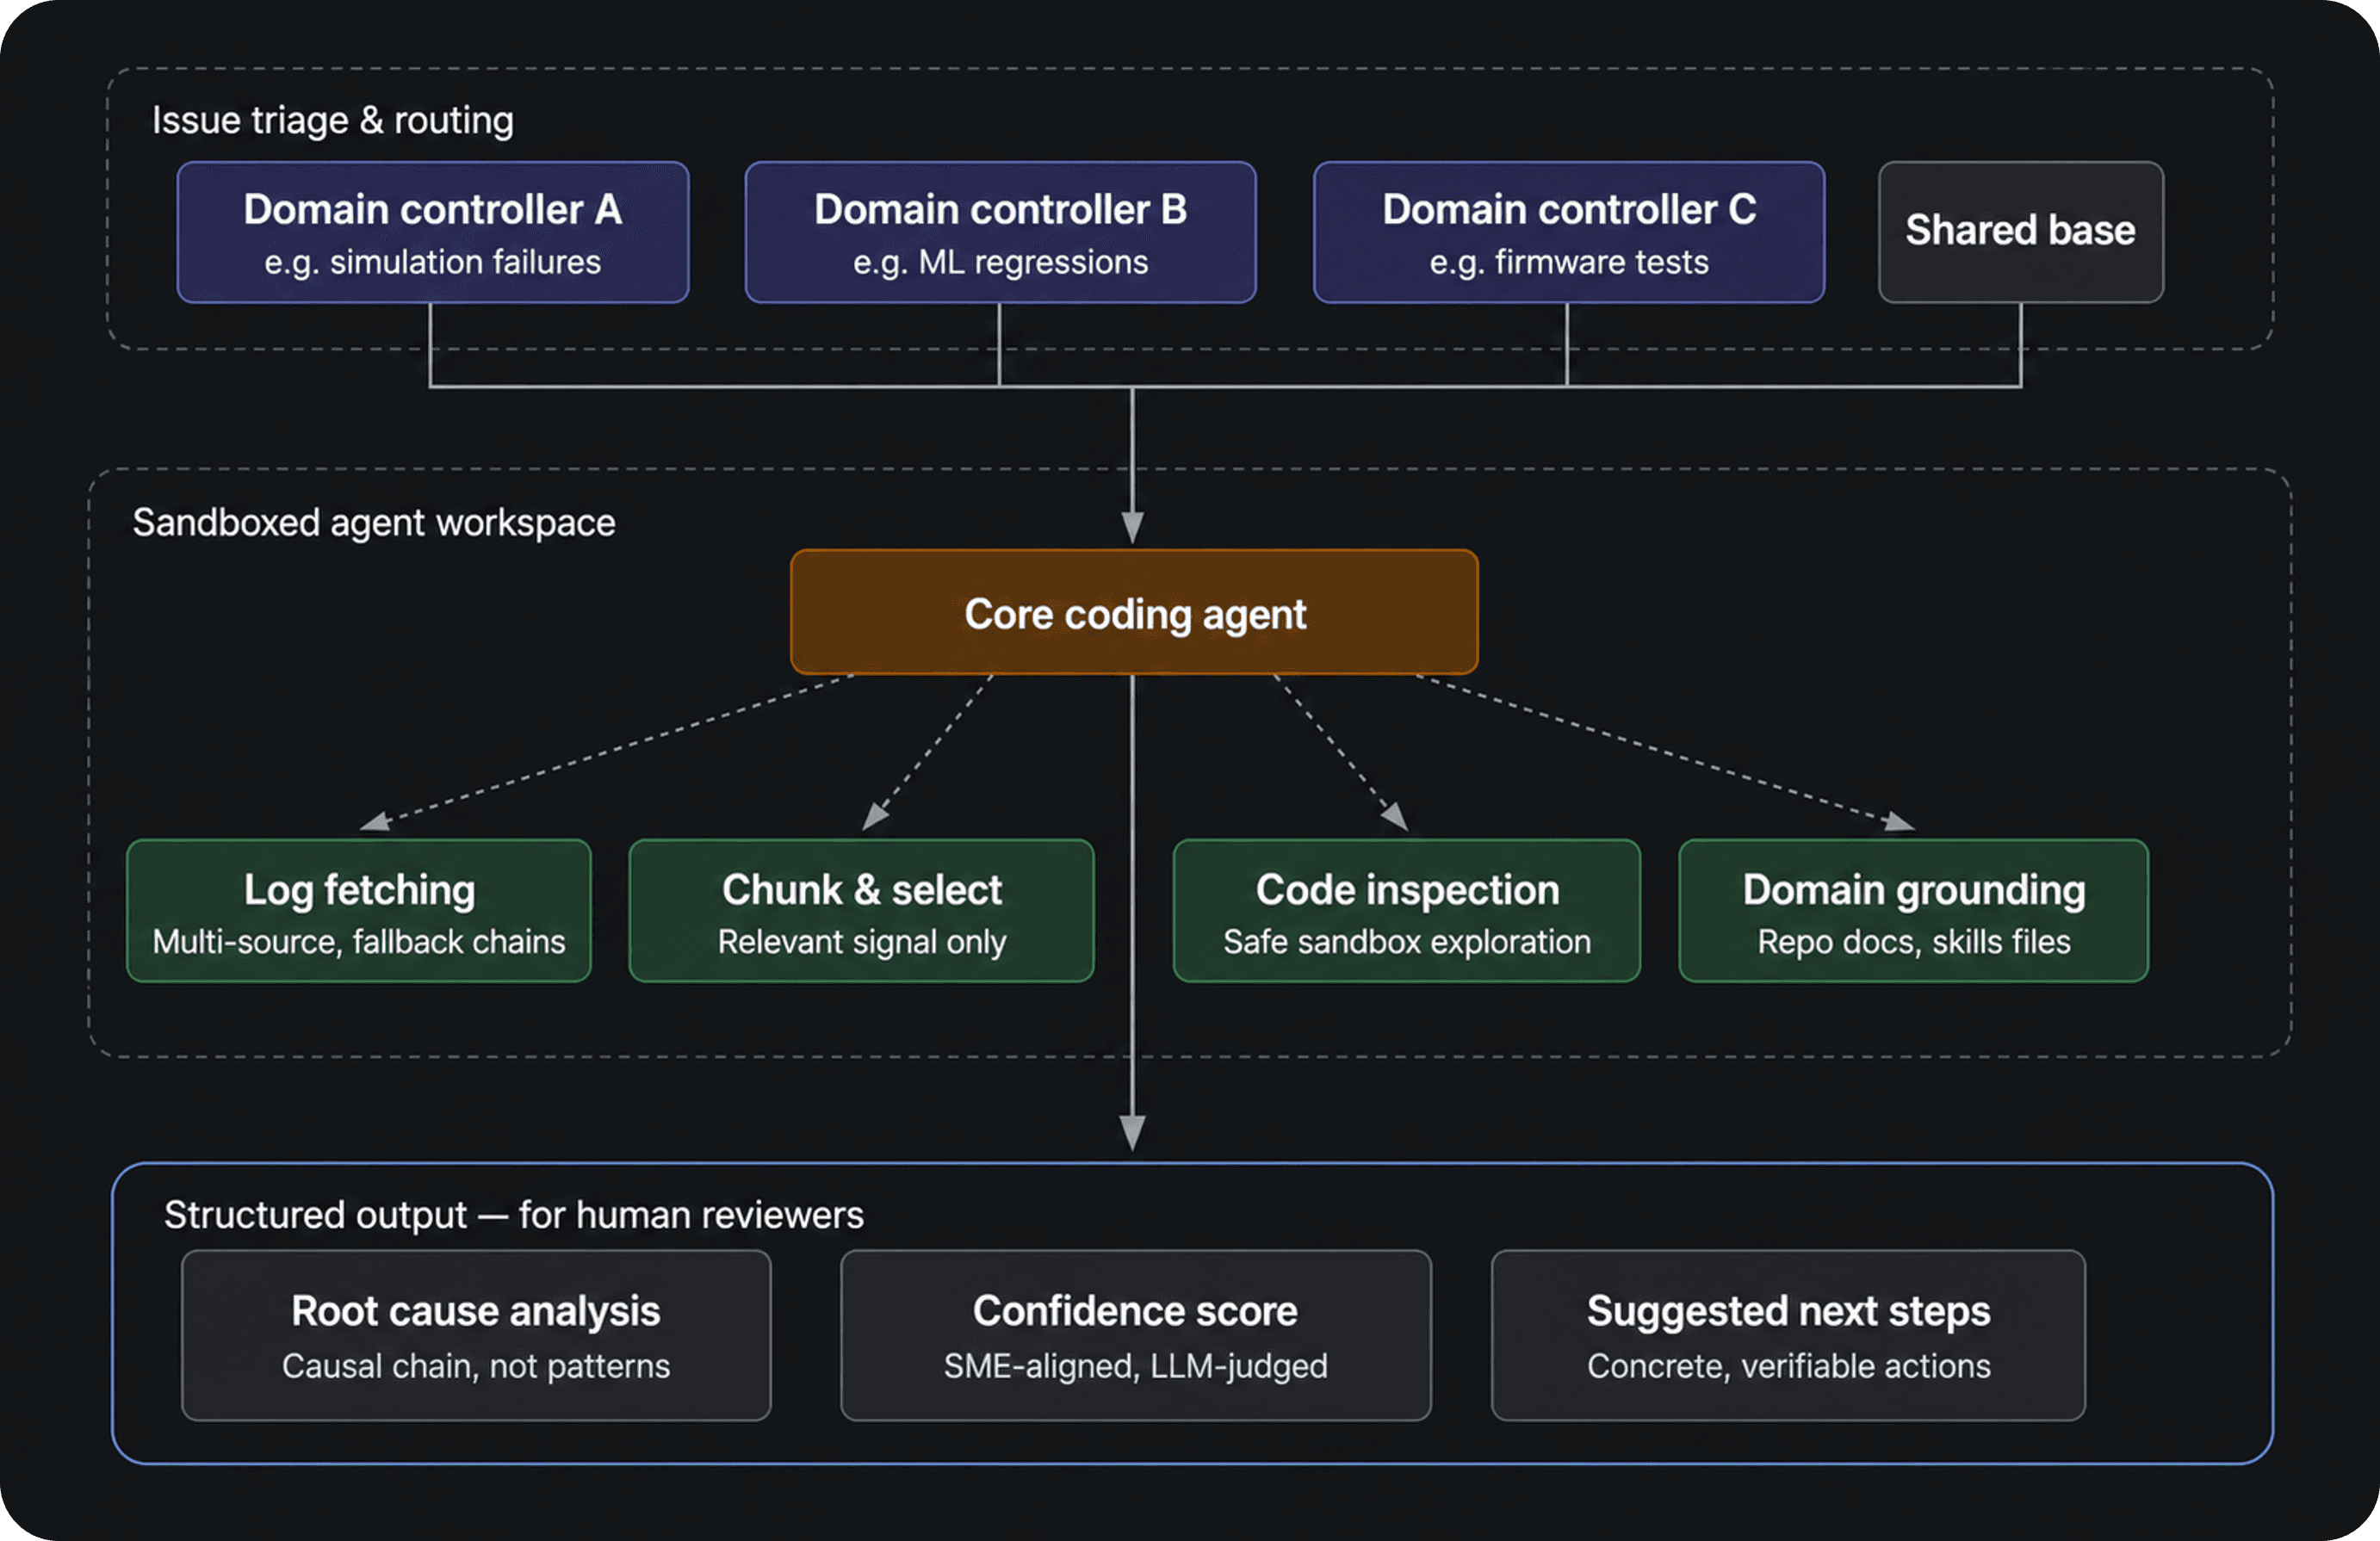
Nie chodzi o wyeliminowanie osądu inżynierskiego, lecz o zapewnienie osobom dokonującym przeglądu lepszego punktu wyjścia. Wstępna analiza regresji, przegląd PR-ów, naprawa testów, walidacja wydań i analiza po wdrożeniu mają tę samą specyfikę. W dużej mierze opierają się na analizie informacji i przeglądzie, a przy tym wiążą się z wieloma niejednoznacznościami. Nie wymagają od agenta zastąpienia procesu inżynieryjnego, lecz jedynie pomocy w jego sprawnym prowadzeniu.
Dlatego zespoły powinny też uważnie dobierać sposób oceny tych systemów.
Niewłaściwe pytanie brzmi: czy agent potrafi stworzyć coś imponującego w oderwaniu od kontekstu? Lepiej zapytać, czy usprawnia rzeczywisty proces pracy, nie powodując zarazem utrudnień w innym miejscu.
Trzeba więc sprawdzić, czy wynik jest wystarczająco konkretny, by można go było zweryfikować, czy wyjaśnia związki przyczynowe, zamiast jedynie dopasowywać wzorce, oraz czy ułatwia przegląd, zamiast go utrudniać. Wiarygodnie brzmiąca odpowiedź nie musi być użyteczna. W praktyce zespoły ufają wynikom pracy agenta, gdy przechodzą one szczegółową weryfikację i wskazują coś konkretnego do sprawdzenia.
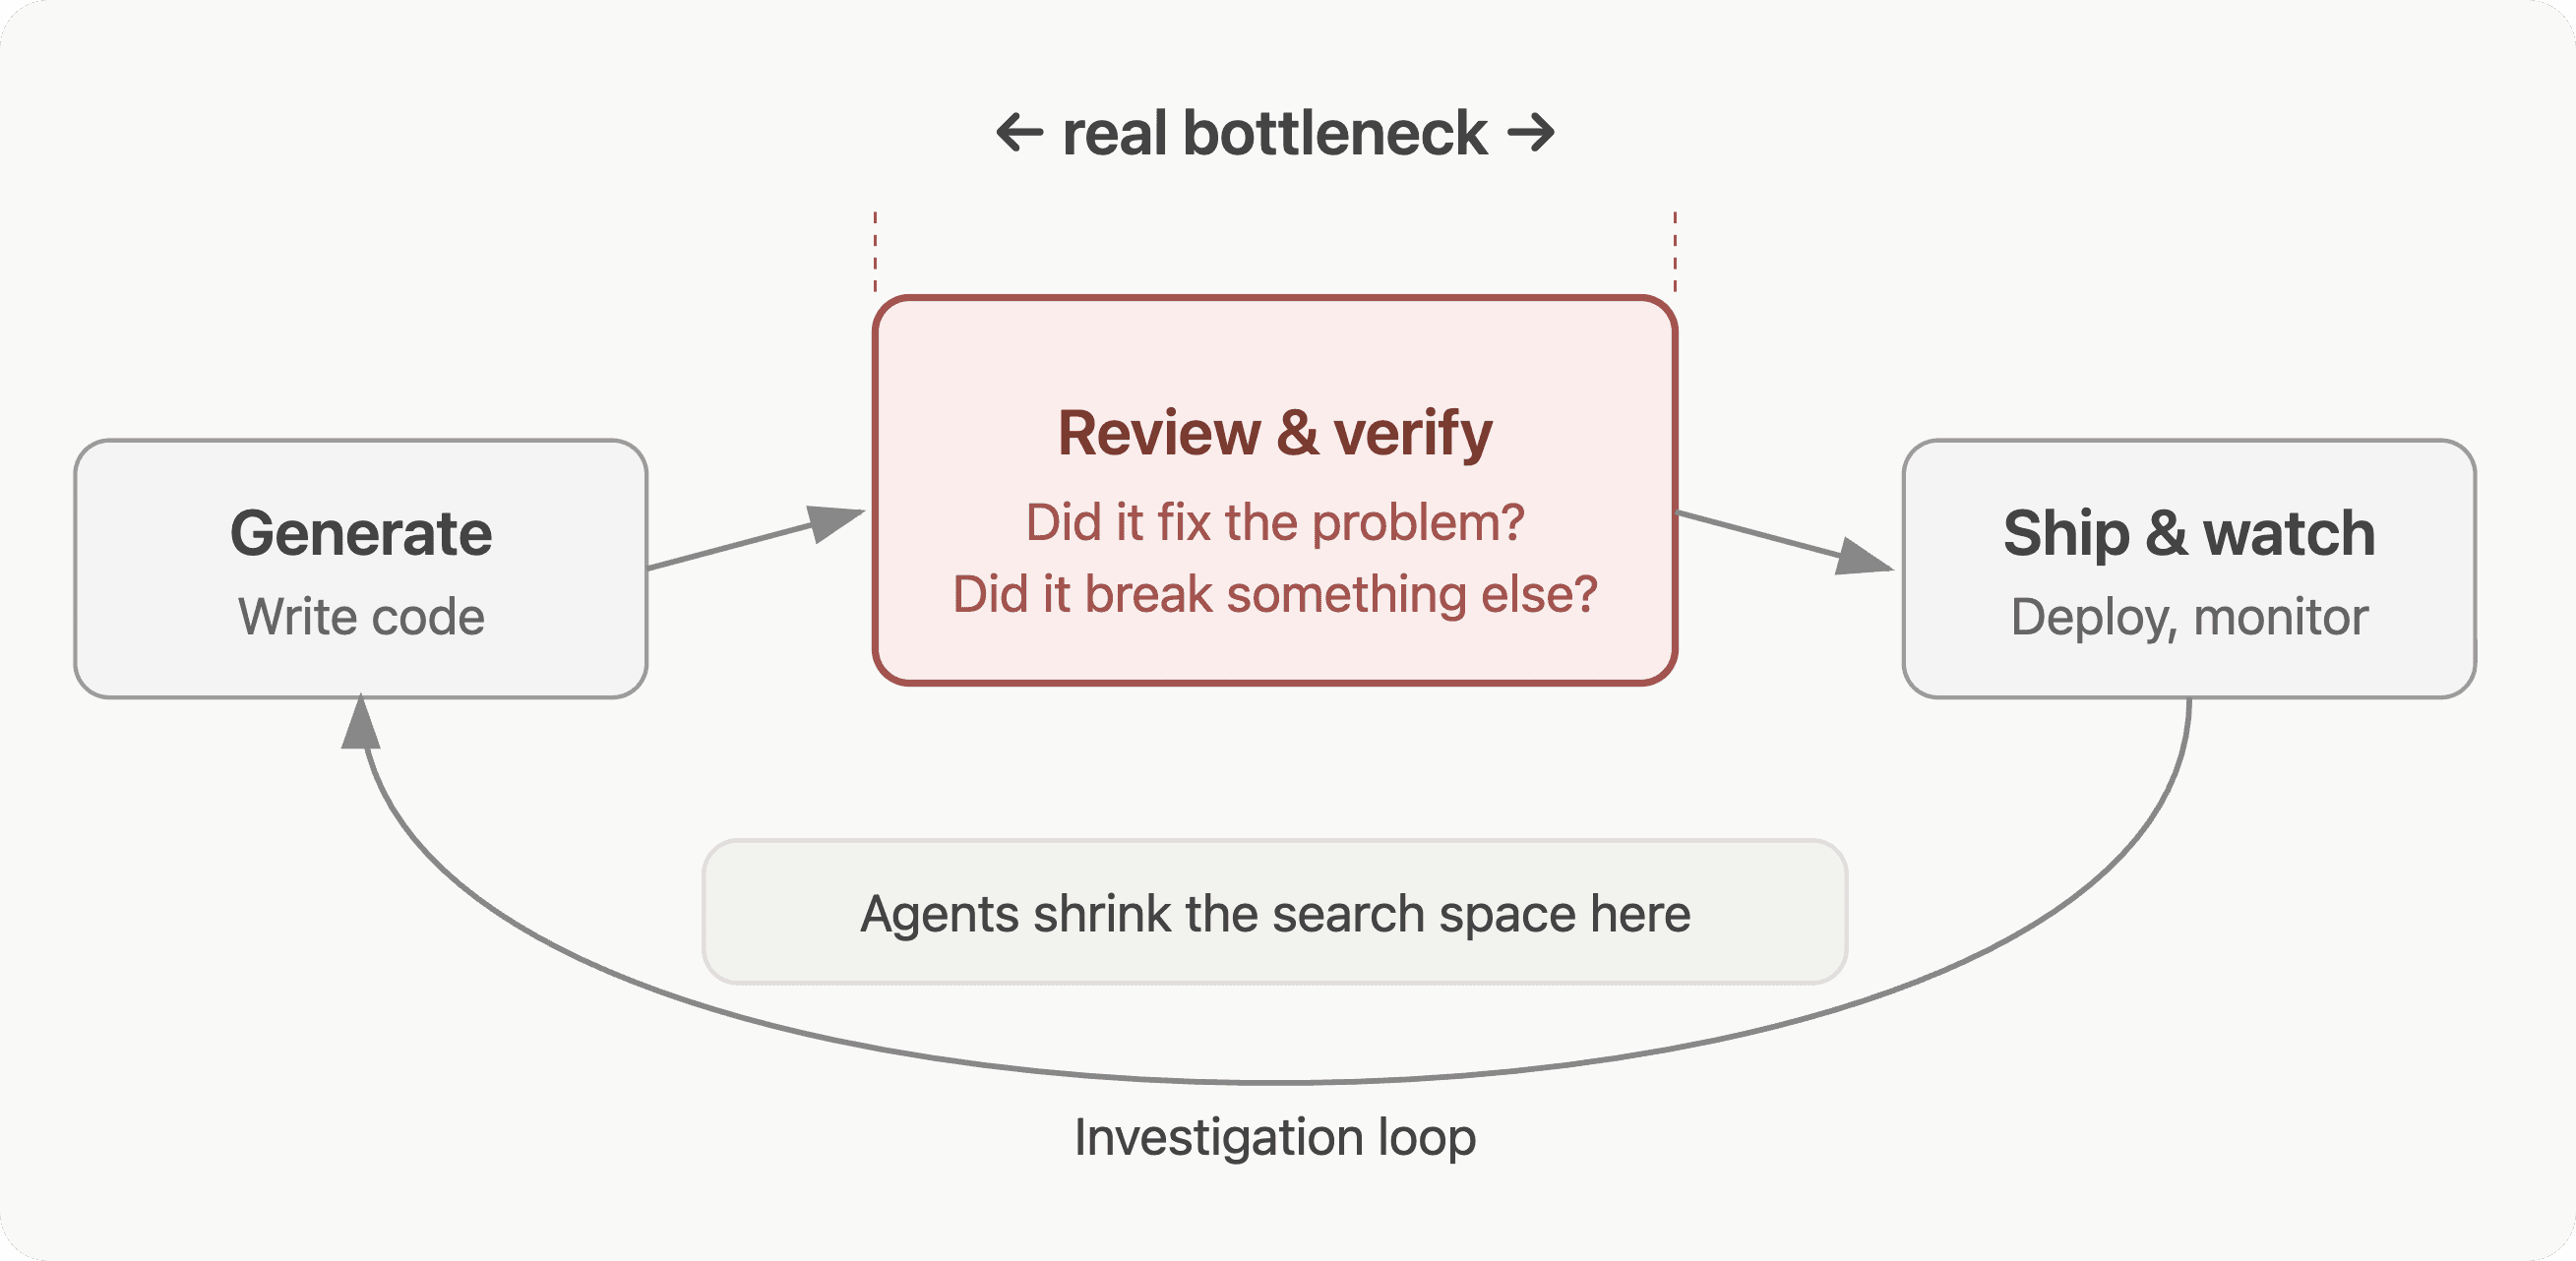
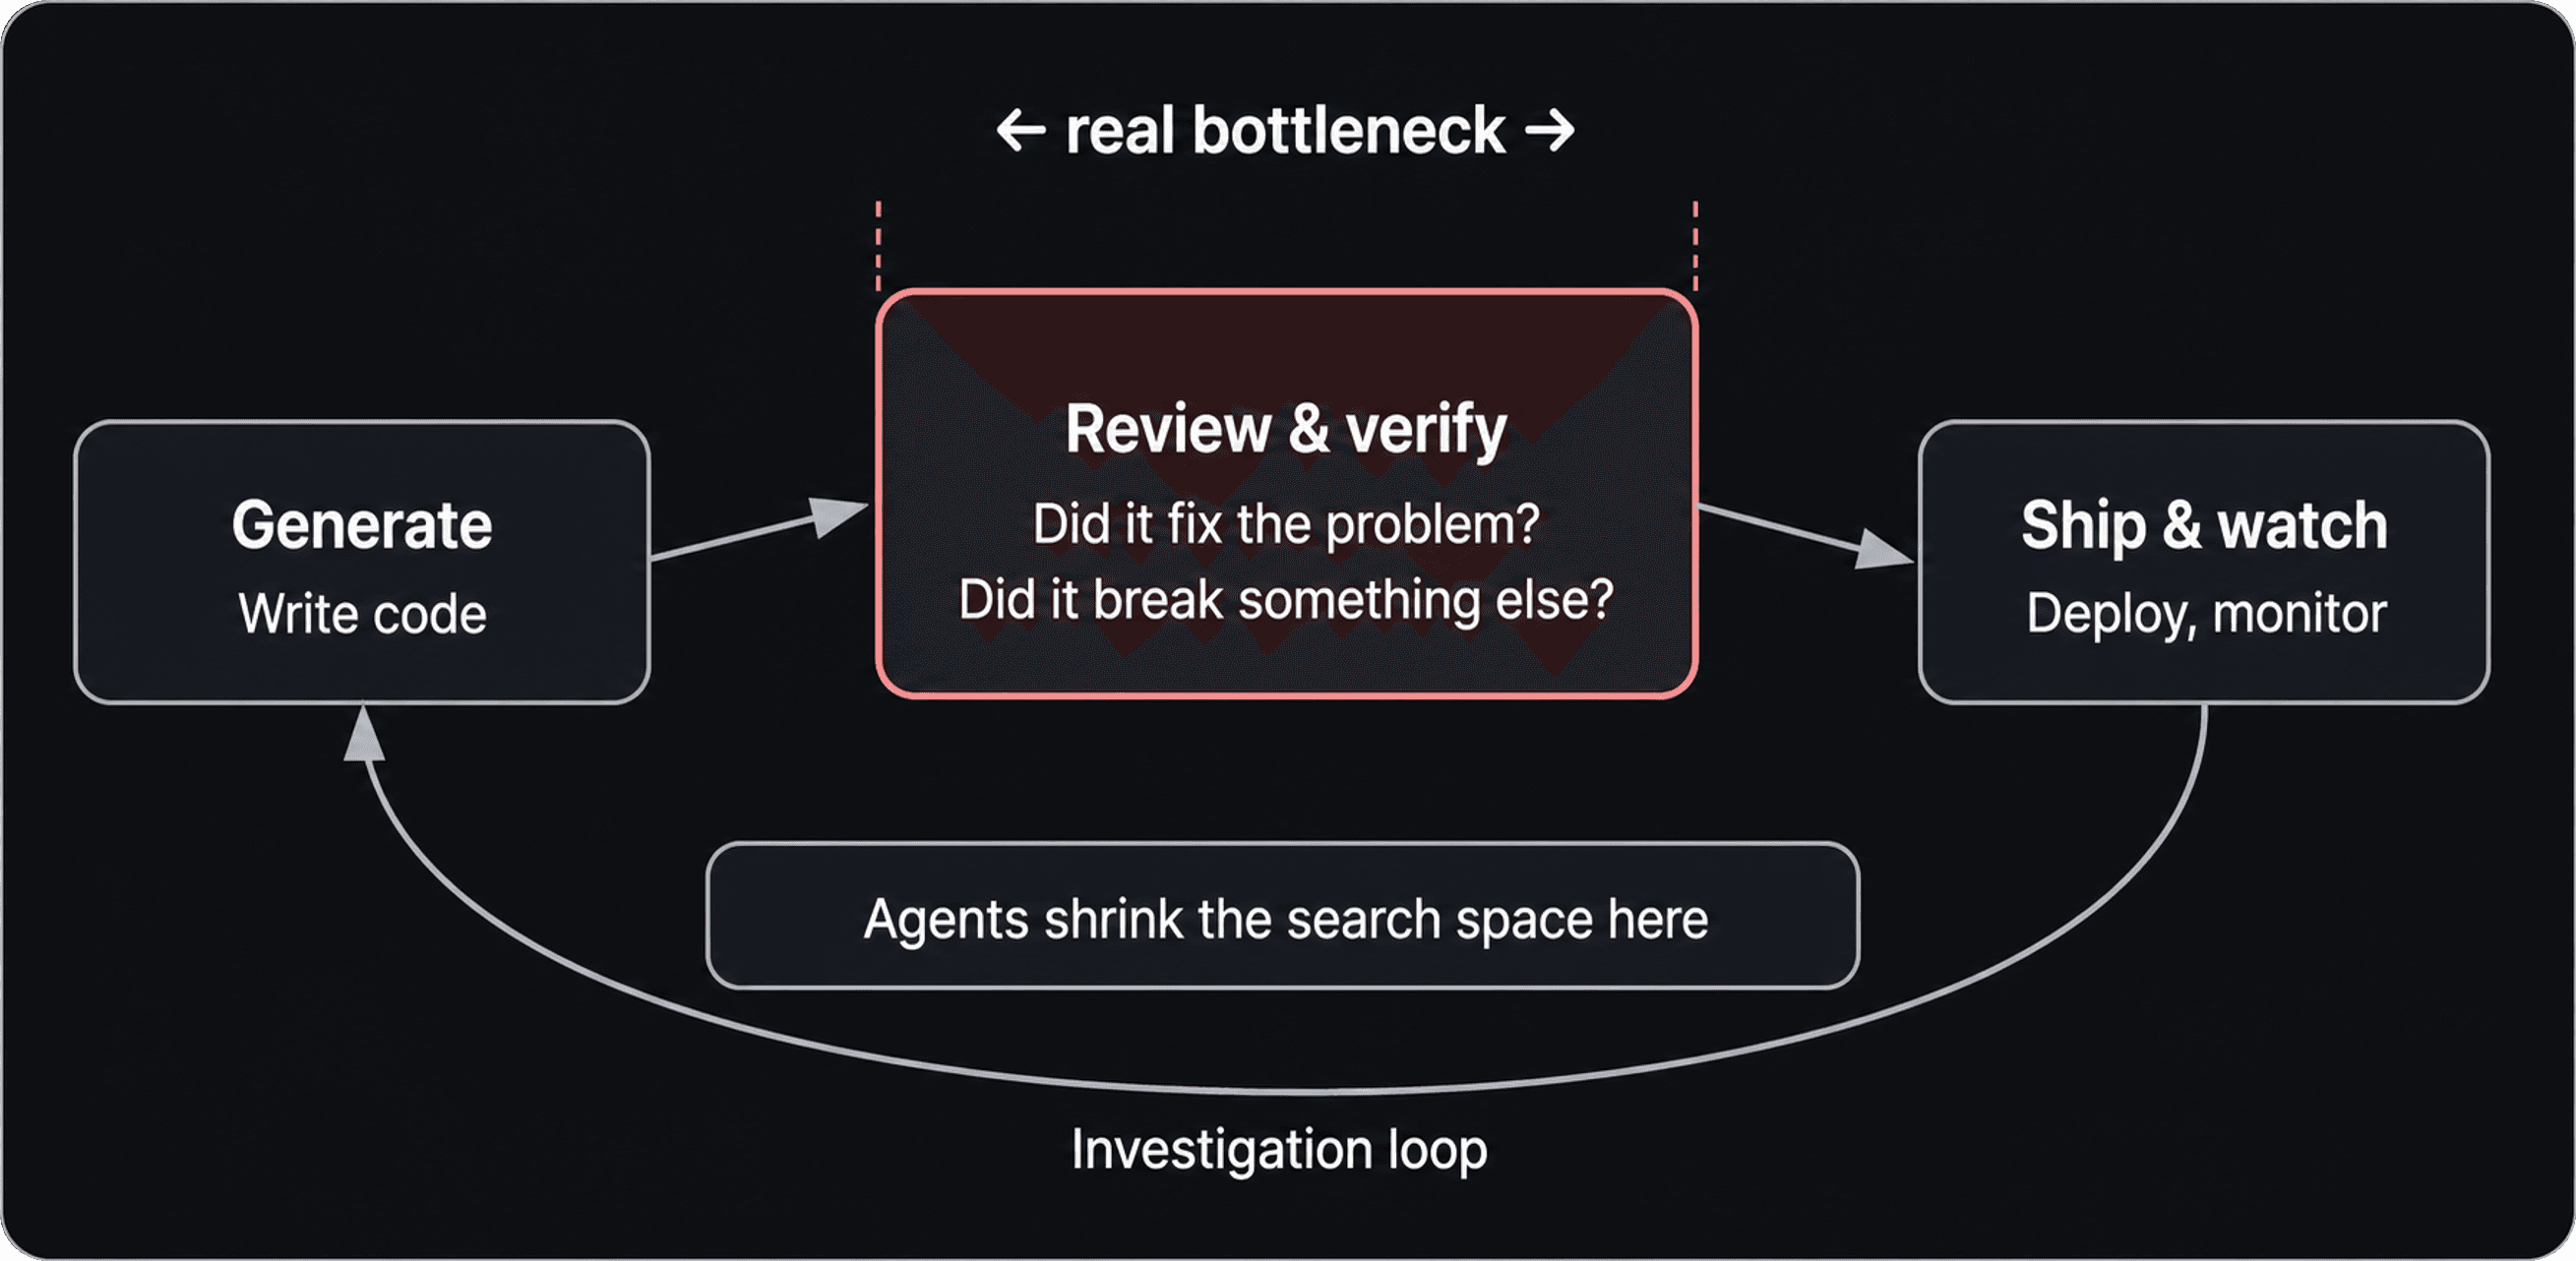
Wniosek jest szerszy: aby systemy agentowe były użyteczne, samo generowanie nie wystarczy. Ich skuteczność zależy od sposobu gromadzenia informacji, budowania kontekstu i sprawdzania wyników, a także od tego, jak przedstawia się osobie dokonującej przeglądu poziom niepewności.
Dlatego w najbliższej przyszłości rozwój inżynierii agentowej raczej nie będzie polegał na jednym wielkim skoku ku pełnej autonomii, ale na szeregu starannie zaprojektowanych cykli, w których agenci pomagają zespołom analizować, przeglądać, weryfikować i udoskonalać pracę, ograniczając zbędny wysiłek między kolejnymi etapami.
Może brzmi to mniej spektakularnie niż ogólna wizja autonomii, ale znacznie lepiej odzwierciedla sposób, w jaki faktycznie wdraża się użyteczne systemy.