Pašreizējās autonomās pilnveides sistēmas ir uzrādījušas labus rezultātus programmēšanas uzdevumos, taču joprojām nav skaidrs, vai tās spēj uzlabot sarežģītas, ilgstošas MI darbplūsmas, kas līdzinās reāliem uzņēmumu risinājumiem.
Mūsu Meta-Harness pētījumā autonomā pašpilnveide tiek izmantota aģentiskās izguves, dziļās izpētes un signālu izlūkošanas darbplūsmās, vienlaikus ievērojot uzņēmumu prasības, piemēram, novērtēšanu ar atliktiem datiem, auditējamību, budžeta kontroli un cilvēka apstiprinājumu.
Trijās reprezentatīvās darba slodzēs Meta-Harness būtiski uzlaboja veiktspēju, tostarp panāca 84% uzlabojumu Signal Engine atliktajā testā, kā arī lielāku aģentiskās multimodālās izguves precizitāti ar 16 reižu ātrāku izpildi.
Atšķirībā no lielākās daļas iepriekšējo pieeju Meta-Harness panākumus, kad vien iespējams, mēra atliktajās datu kopās, lai noskaidrotu, vai uzlabojumi ir vispārināmi ārpus optimizācijā izmantotajiem datiem.
Šie rezultāti liecina, ka autonomu darbplūsmu pilnveidi var izmantot ne tikai programmēšanas etalonuzdevumos, bet arī reālās uzņēmumu MI sistēmās, nodrošinot praktisku ceļu uz nepārtraukti pilnveidojamām MI lietotnēm.
Jaunākie autonomās MI izpētes darbi, tostarp publikācija par Meta-Harness, CORAL izpildes ietvars un karpathy/autoresearch, ir parādījuši, ka programmēšanas aģenti var iteratīvi uzlabot risinājumu, ja ir dota novērtēšanas metrika. Joprojām nav skaidrs, vai šīs metodes darbojas arī ilgstošās MI darbplūsmās, piemēram, aģentiskajā multimodālajā izguvē, kur aģentam atkārtoti jāmeklē multimodālos nozares korpusos, lai atbildētu uz jautājumu, vai sarežģītos datu apstrādes konveijeros, kuros vajadzīgas daudzas savstarpēji atkarīgas darbības, rīku izsaukumi un lēmumi par izņēmumu apstrādi. Būtiskākais jautājums ir, vai ieguvumi saglabājas datos, kurus optimizētājs nekad nav redzējis.
Mūsu Meta-Harness pētniecības un izstrādes projekts sniedz atbildi uz šo jautājumu. Tajā jaunāko pētījumu idejas ir pielāgotas uzņēmumu vajadzībām: novērtēšanai ar atliktiem datiem, audita pierakstiem, izmaksu griestiem un skaidram nodošanas punktam, kurā pirms ieviešanas rezultātu pārskata cilvēks.
Mēs to pārbaudījām trīs ilgstošos uzdevumos, kas veidoti pēc reāliem klientu projektiem. Signal Engine uzrauga tiešraides X ierakstu plūsmu par MI tirgu un sagatavo strukturētus tendenču pārskatus ar uzticamiem avotiem. Aģentiskā multimodālā izguve analizē kombinētus teksta un attēlu vaicājumus, lai atrastu visatbilstošākās dokumentu lapas. Dziļā izpēte koordinē vairākus aģentus, kuri meklē tīmeklī, pārbauda avotus un raksta izvērstus izpētes pārskatus.
Signal Engine: atliktā testa kopējais rezultāts 0,456 → 0,841 — relatīvs pieaugums par 84%. Ar tādu pašu budžetu CORAL un karpathy/autoresearch rezultāti nepārsniedza 0,50.
Aģentiskā multimodālā izguve: atliktā testa NDCG@10 pieauga no 0,705 līdz 0,744, bet viena novērtējuma faktiskais izpildes laiks saruka no 869 s līdz 54 s. Tas nozīmē 16 reižu lielāku ātrumu un vienlaikus augstāku precizitāti.
Dziļā izpēte: pārskatu kvalitātes kopējais rezultāts pieauga no 0,449 līdz 0,802 desmit atsauces jautājumos, savukārt bāzes risinājumu rezultāts bija aptuveni 0,52. Šim uzdevumam nebija atliktas datu kopas, tāpēc šo rādītāju uzskatām tikai par rezultātu izmantotajā izlasē.
Meklēšanas efektivitāte: izmantojot prognozējošo hipotēžu pārkārtošanu, Signal Engine trijās, nevis 20 iterācijās sasniedza 91% no atsauces procesa labākā rezultāta ar tādu pašu novērtēšanas budžetu.
Vairums autonomās izpētes sistēmu optimizē un novērtē vienā un tajā pašā datu kopā, tāpēc nav iespējams noteikt, vai rezultāts ir vispārināms. Signal Engine un aģentiskajai multimodālajai izguvei mēs ievērojam stingru dalījumu: mācību kopa, kurā var novērtēt kandidātus, izstrādes kopa pamata pārbaudēm un atlikta testa kopa, kuru optimizētājs nekad neredz. Katrs publicētais rezultāts iegūts ar vienu konkrētu koda versiju, kas novērtēta visās datu kopās, tāpēc viena kandidāta labākais mācību rezultāts nekad netiek apvienots ar cita kandidāta labāko testa rezultātu.
Katrā kārtā izpildes ietvars ģenerē strukturētu hipotēžu kopu par koda izmaiņām. Katrā hipotēzē ir norādīts maināmais mehānisms, iepriekšējā versija, uz kuru tā balstās, un novēršamais kļūmes veids. Pirms resursu tērēšanas dārgiem novērtējumiem šo kopu filtrē ranžēšanas posmā. Atlikušās hipotēzes saņem paralēli darba aģenti, kuri izmanto kopīgu zināšanu bāzi, bet rediģē kodu pilnībā izolētās darbvietās, lai katru kandidātu novērtētu godīgi un neatkarīgi. Kārtas beigās izpildītājs izvirza vienu uzvarētāju — visaugstāk novērtēto kandidātu, kurš arī izturējis visas pārbaudes redzamajās datu kopās. Šis uzvarētājs kļūst par robežšķirtni, uz kuras balstās nākamā kārta. Katrs izmēģinājums tikai papildināmai pierādījumu krātuvei pievieno noteiktu datu kopumu: koda ielāpu, katras datu kopas rezultātus, notikumu žurnālu un četras īsas LVM sagatavotas analīzes par izpildes gaitu, kļūdām, izmaksām un secinājumiem. Nākamās kārtas priekšlikumu veidotājs pārlasa šo vēsturi, tāpēc izpildes ietvars uzkrāj apgūto, nevis atkārtoti nonāk tajos pašos strupceļos.

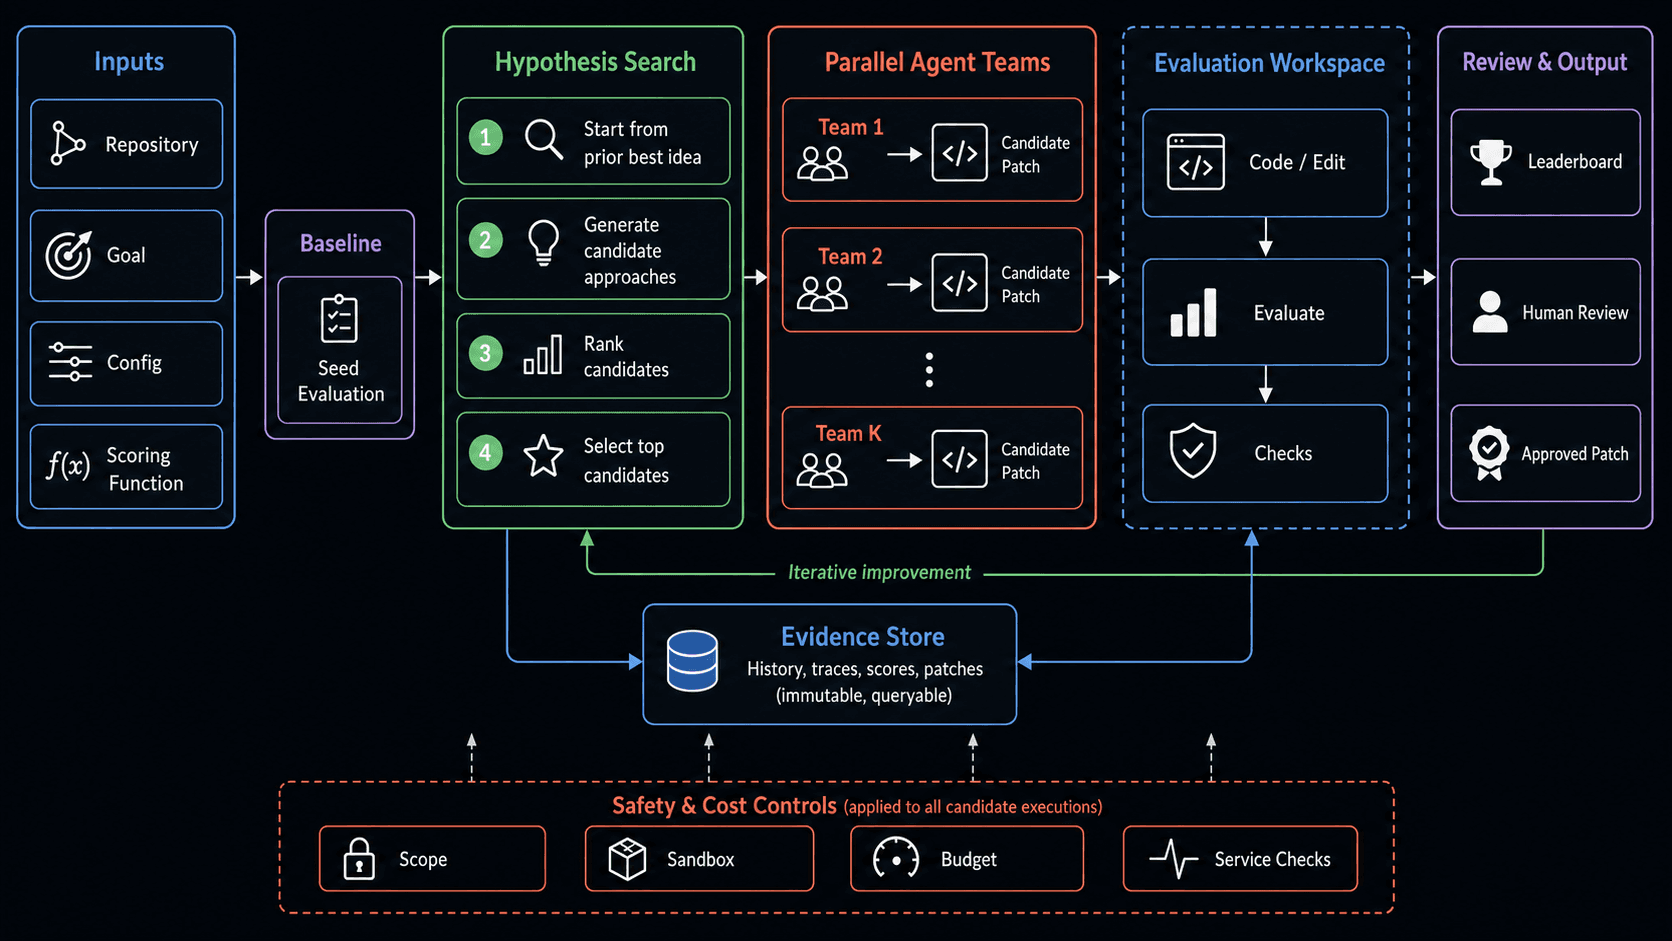
Trīs aizsargmehānismi nodrošina cikla drošu izpildi. Tvēruma politika ierobežo failus, kurus kandidāts drīkst mainīt, un atsauc visas izmaiņas ārpus šī tvēruma. Tekstvienību un faktiskā izpildes laika budžeti aptur procesu, kad izdevumi sasniedz noteikto robežu, bet paralēlās izpildes ierobežojumi nodrošina, ka izpildes ietvars nepārsniedz modeļa un GPU pieprasījumu biežuma limitus. Turklāt izpildes ietvars pats neko neizvieto produkcijā. Tas sagatavo ranžētu, pilnībā dokumentētu kandidātu, bet inženieris pārskata izmaiņas un izlemj, vai tās ieviest produkcijā.
Lokālajā tehnoloģiju stekā katras iepriekš aprakstītā cikla kārtas pamatā ir pieci inženiertehniski pamatmehānismi.
Darbvietu izolācija. Katram kandidātam sava git darba koka kopija. Sazarojumi koplieto objektu datubāzi, bet ne viens otra failus. Tādējādi kandidātus var izpildīt paralēli ar gandrīz nemainīgām diska izmaksām un viegli salīdzināt ar pašreizējo robežšķirtni.
Izpildes smilškaste. Konfigurācijā pieejami divi režīmi: vietējais apakšprocess ātrām iterācijām vai pilnībā izolēta izpildvide. Korpusi tiek montēti tikai lasīšanas režīmā, un katra izmēģinājuma pagaidu direktorijs pēc novērtēšanas tiek dzēsts. Tāpēc izmēģinājums nevar mainīt datu kopu vai nodot savu stāvokli nākamajam izmēģinājumam.
Tvēruma politika. Eksperimenta konfigurācijā norādīts atļauto ceļu saraksts. Pirms izmēģinājuma novērtēšanas visas izmaiņas ārpus tā tiek atsauktas un izmēģinājums tiek atzīmēts. Tādējādi pārskatītājam redzamās izmaiņas garantēti paliek noteiktajā tvērumā.
Budžeta ievērošana. Trīs līmeņi: katra izmēģinājuma tekstvienību un faktiskā laika limiti, kopējais procesa budžeta ierobežojums un paralēlās izpildes limits. Kopā tie ļauj prognozēt izdevumus un nodrošina, ka izpildes ietvars ievēro modeļa un infrastruktūras pieprasījumu biežuma limitus.
Pierādījumu krātuve. Tikai papildināms JSONL fails ar koda ielāpu, katras datu kopas rezultātiem, notikumu žurnālu un četrām LVM sagatavotām analīzēm. Materializētie skati — līderu tabula, robežšķirtne un kļūmju indekss — tiek atjaunoti pēc katra izmēģinājuma. Tādējādi nākamās kārtas var izmantot iepriekšējo vēsturi, bet katrs process joprojām ir precīzi reproducējams līdz pat pēdējam baitam.
Neviens no šiem pamatmehānismiem nav izvēles elements. Izpildes ietvara mērķis ir procesa beigās sniegt pārskatītājam kaut ko, ko patiešām var apstiprināt: uzvarējušo kandidātu, ierobežota tvēruma izmaiņas, pilnīgu visu izmēģinājumu uzskaiti un zināmas izmaksas. Noņemot kaut vienu no šiem pieciem elementiem, zūd arī viena no garantijām.
Visos trijos eksperimentos izmantota viena un tā pati hipotēžu stratēģija. Katrā iterācijā priekšlikumu veidotājs ģenerē vairāk hipotēžu, nekā budžets ļauj izpildīt: M = 8 kandidāti, bet izpildei var nodot K = 4. Atsevišķs LVM ranžētājs vienā 30 sekunžu izsaukumā sakārto visus astoņus, ņemot vērā kopainu: pašreizējo labāko rezultātu un tā vājās dimensijas, neseno izmēģinājumu kļūmju analīzes un visus astoņus priekšlikumus līdzās. Četri labākie tiek nodoti izpildītājam, un katrs maksā 15–30 minūtes izpildes laika. Pārējie četri tiek atmesti, pirms tiem iztērēti jebkādi resursi.
Pamatā esošie modeļi visā procesā palika nemainīgi; izpildes ietvars rediģēja tikai tiem apkārt esošo kodu. Signal Engine un dziļā izpēte darbojās ar gpt-5.5. Aģentiskā multimodālā izguve izmantoja lokāli ar vLLM darbinātu atvērto svaru modeli Qwen3.6-35B-A3B kopā ar attēlu izguves modeli ColQwen3-4B; šī kombinācija tika izvēlēta prognozējamo lokālās infrastruktūras izmaksu dēļ.
Tālāk redzamajā diagrammā parādītas mūsu trīs galveno uzdevumu rezultātu izmaiņas. "Seed" ir cilvēka-inženiera uzrakstītais sākotnējais kods. "Meta-Harness" ir labākā Meta-Harness atrastā versija. Atliktajā testa kopā visu trīs uzdevumu veiktspēja uzlabojās.
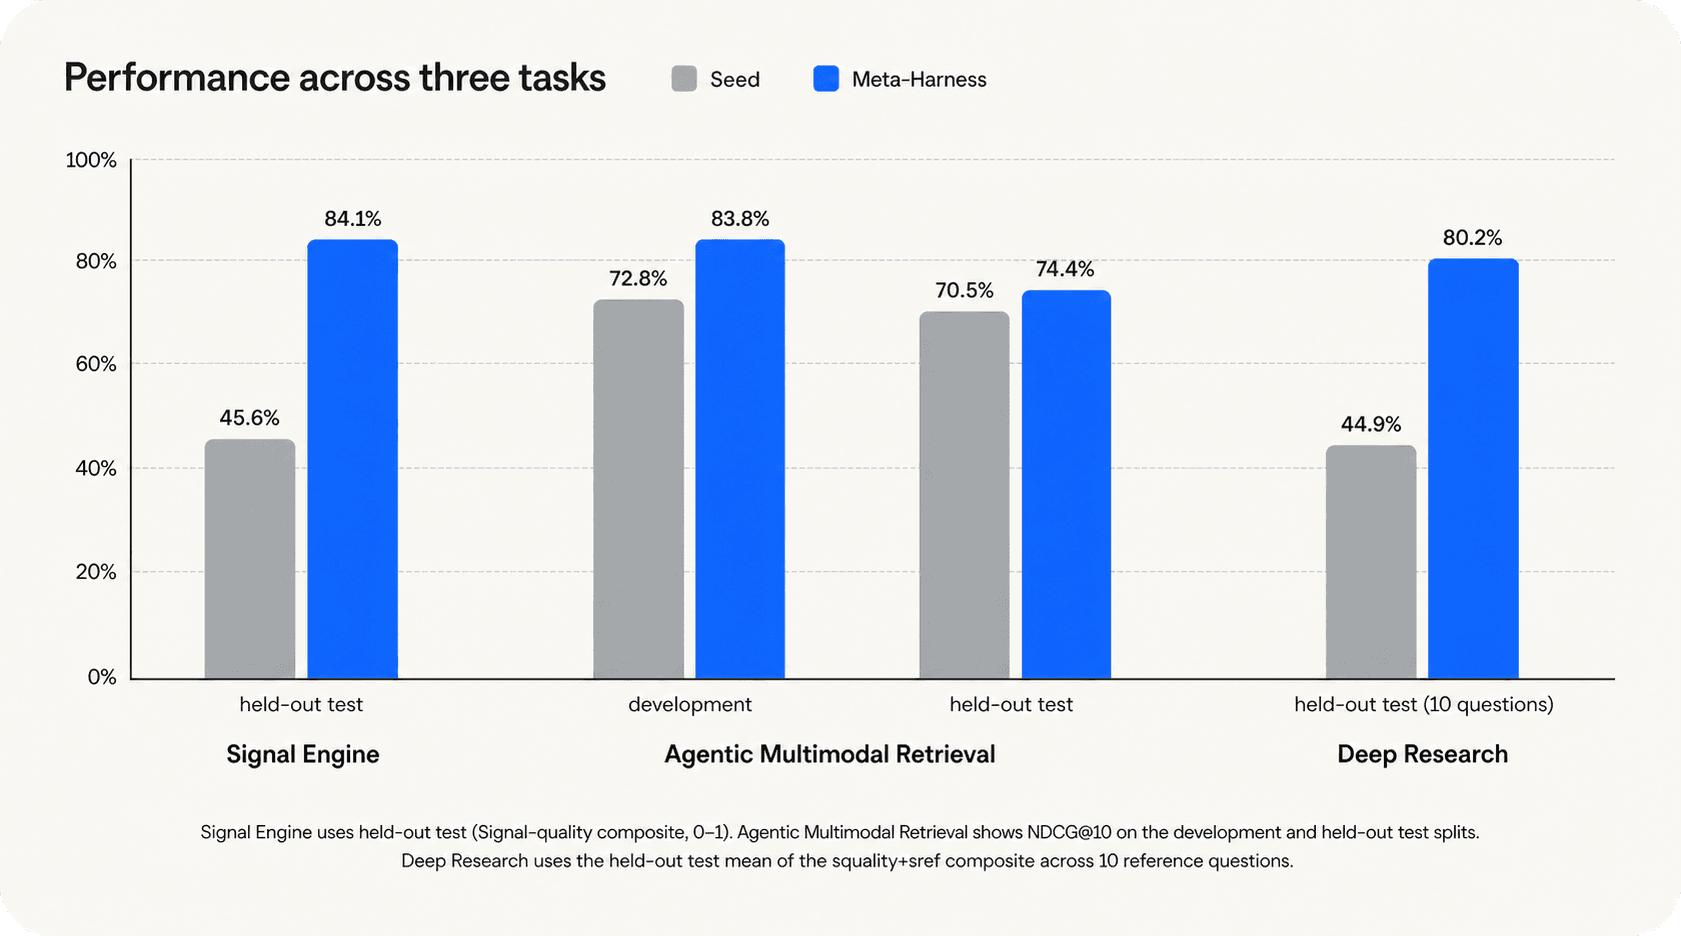
Signal Engine novērtēja LVM vērtētājs pēc aktualitātes, faktu pareizības, detalizācijas un toņa, izmantojot 150 mācību tvītus un 150 atliktā testa tvītus. Procesa gaitā labākās versijas kopējais mācību rezultāts pieauga no 0,431 līdz 0,756, bet atliktā testa rezultāts — no 0,456 līdz 0,841. Uzlabojumus nodrošināja paša izpildes ietvara izmaiņas, nevis tikai uzvedņu pielāgošana: veiksmīgākās iterācijas iemācījās filtrēt sociālo mediju troksni, pievienoja faktu savstarpējas pārbaudes posmus un pieprasīja katru rezultātu pamatot ar skaidriem pierādījumiem. Tālāk redzamajā shēmā parādīts iterāciju process.

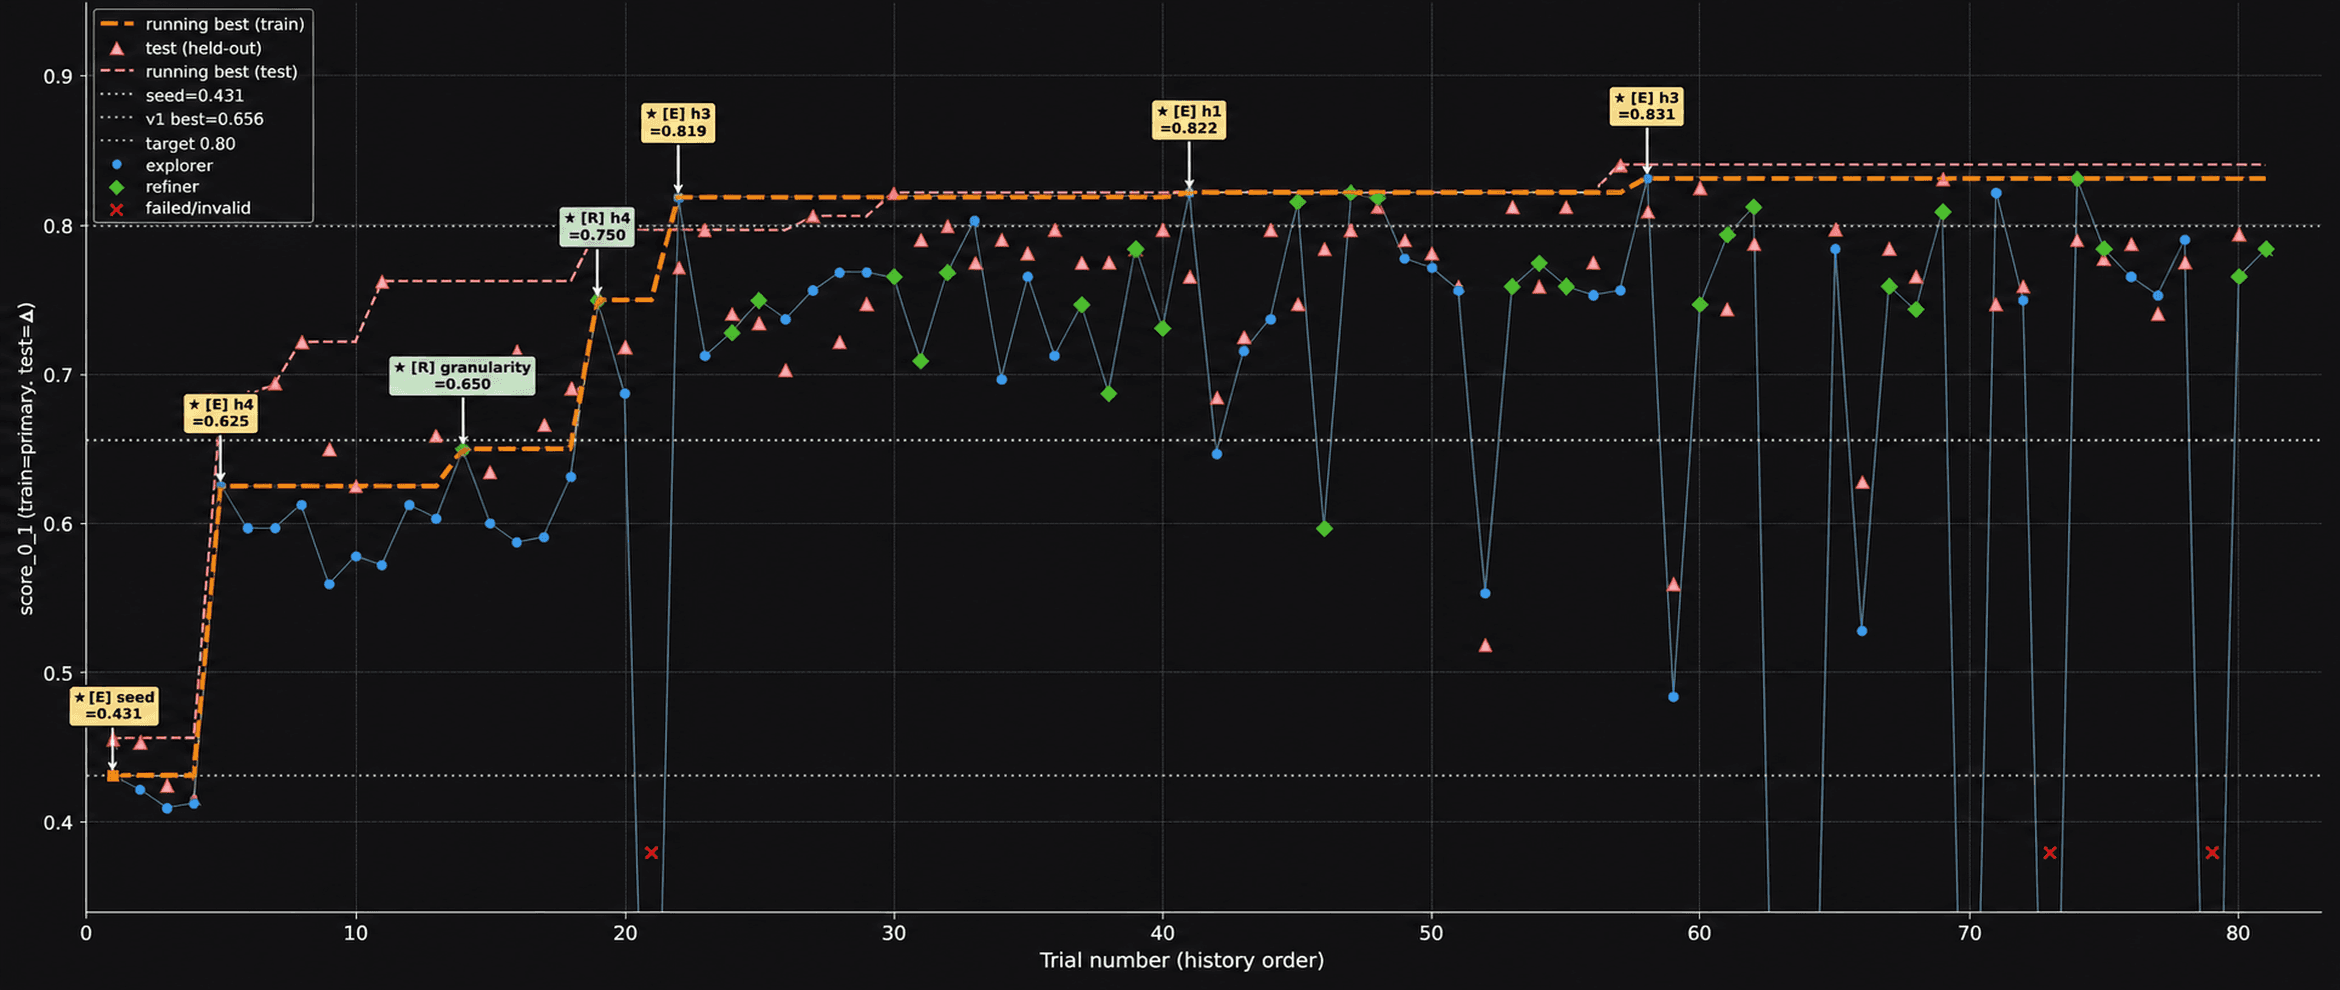
Izmēģinājumu vēsture parāda, kā šie ieguvumi uzkrājās. Agrīna strukturāla izmaiņa palielināja līdz tam labāko rezultātu līdz 0,625; detalizētāka pierādījumu apstrāde to paaugstināja līdz 0,679; savukārt pilnveidots secinājumu un vērtēšanas kritēriju cikls — līdz 0,819. Aptuveni puse visu kandidātu procesu uzrādīja sliktākus rezultātus vai pilnībā neizdevās, taču tie neietekmēja līderu tabulu: katrs sazarojums darbojās izolēti, zaudējušo versiju izmaiņas tika atmestas, bet kļūmes ierakstītas secinājumu krātuvē, lai nākamais priekšlikumu veidotājs neatkārtotu to pašu strupceļu.
Vissvarīgākais — atliktā testa līkne visā procesā pieauga līdztekus mācību līknei. Tas liecina, ka izpildes ietvars pilnveidoja darbplūsmu, nevis iegaumēja mācību korpusu. Atliktā testa rezultāti bija nedaudz labāki par mācību rezultātiem; mēs to skaidrojam ar parastu izlases troksni starp divām nelielām, savstarpēji nesaistītām datu kopām.
Aģentisko multimodālo izguvi mēra ar NDCG@10 publiskajā ViDoRe V3 datorzinātnes datu kopā, kas sadalīta 20 mācību, 10 izstrādes un 20 atliktā testa vaicājumos. Izpildes ietvars palielināja atliktā testa NDCG@10 no 0,705 līdz 0,744, vienlaikus samazinot kopējo novērtēšanas faktisko izpildes laiku no 869 sekundēm līdz 54 sekundēm.
Dziļo izpēti desmit atsauces jautājumos vērtē pēc LVM noteikta satura kvalitātes un atsauču kvalitātes kopējā rādītāja, ievērojot DeepResearch-Eval metodiku. Uzlabotais kods palielināja vidējo rezultātu no 0,449 līdz 0,802. Veiksmīgās izmaiņas bija viegli saskatāmas koda atšķirībās: sākotnējais plānošanas posms, kurā pieejas salīdzina pirms izpētes aģentu palaišanas, un noslēguma pārskatīšanas posms, kas pievēršas dimensijām, kurās pārskatu rezultāti iepriekš bijuši vāji. Tā kā šī kopa ir neliela un tās novērtēšana ir dārga, mēs to nedalījām un uzskatām rezultātu par iegūtu izmantotajā izlasē.
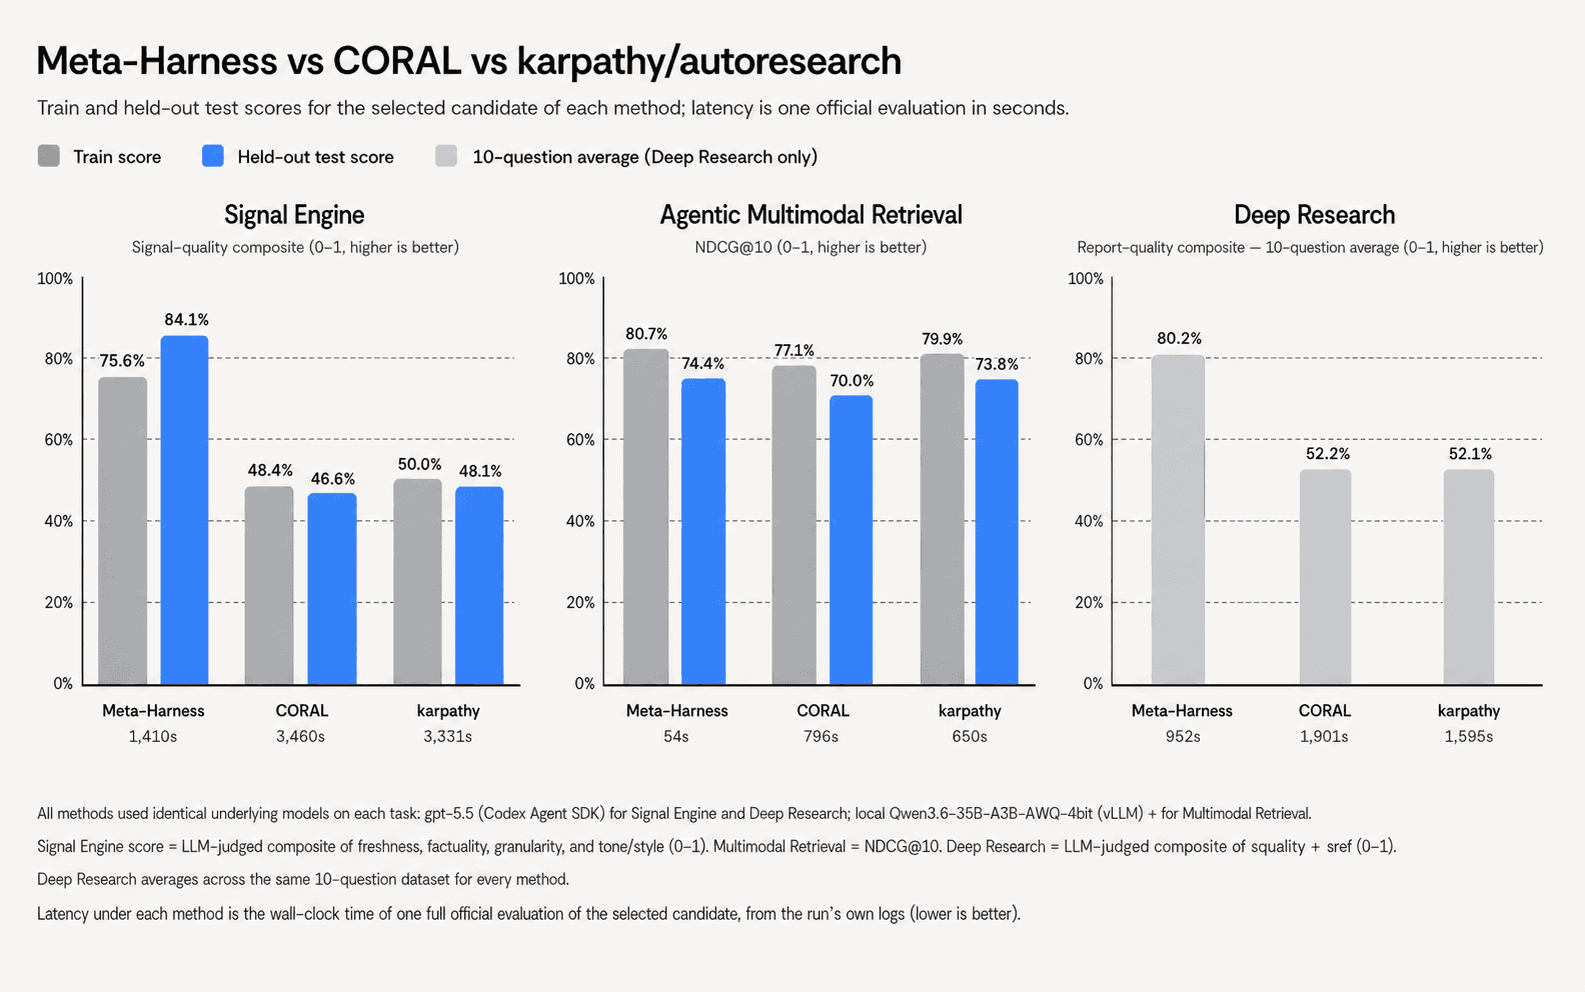
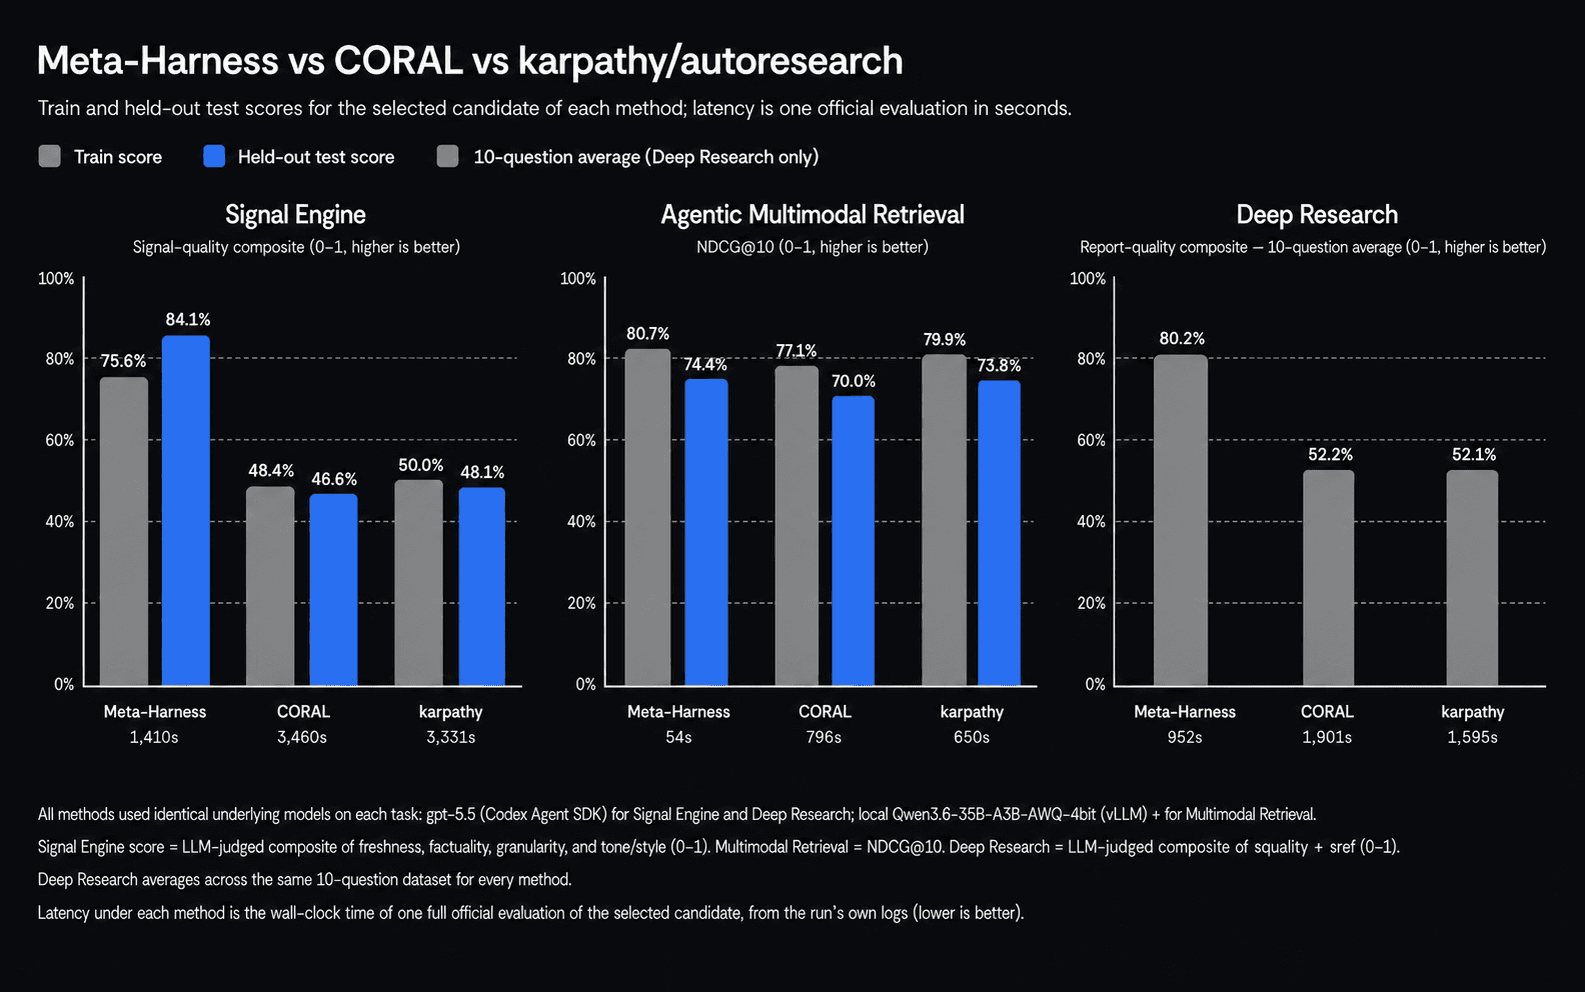
Visas trīs metodes salīdzinājām ar vienādu budžetu: tās pašas datu kopas, tie paši pamatā esošie modeļi, vienāds iterāciju limits un vienāds kopējais kandidātu novērtējumu skaits. Signal Engine atliktajā testā Meta-Harness sasniedz 0,841, bet abu bāzes risinājumu rezultāts palika zem 0,50. Aģentiskajā multimodālajā izguvē mūsu komanda sasniedza augstāko atliktā testa NDCG@10 — 0,744 salīdzinājumā ar CORAL 0,700 un karpathy 0,738 — un oficiālo novērtēšanu izpildīja 12–14 reižu ātrāk: 54 s salīdzinājumā ar 786 s un 650 s. Dziļajā izpētē mūsu komanda sasniedza 0,802, bet abu bāzes risinājumu rezultāts bija aptuveni 0,52. Visiem rezultātiem ir viens ierobežojums: mēs atkārtoti ieviesām CORAL un karpathy/autoresearch pēc to publicētajiem aprakstiem, tāpēc daļu atšķirības var radīt ieviešanas, nevis tikai metožu atšķirības.
Atšķirību nosaka četri projektējuma lēmumi. Pirmkārt, pirms koda rediģēšanas mūsu komanda sagatavo strukturētu projektējuma specifikāciju, tādējādi dodot priekšroku strukturālām izmaiņām, piemēram, jauniem konveijera posmiem, nevis uzvedņu pielāgošanai. Otrkārt, tā paralēli izpilda sazarojumus, kas balstīti uz kopīgu robežšķirtnes kandidātu, tāpēc uzlabojumi uzkrājas ātrāk nekā CORAL neatkarīgo aģentu vai karpathy stingri secīgajā ciklā. Treškārt, katrs izmēģinājums atstāj strukturētus artefaktus — rezultātus, notikumu žurnālus un četras LVM sagatavotas analīzes —, kurus pārlasa nākamais priekšlikumu veidotājs, savukārt bāzes risinājumi saglabā tikai vienkāršus mēģinājumu žurnālus. Ceturtkārt, pēc stagnācijas adaptīvs kontrolieris virza priekšlikumu veidotāju uz izpēti, bet pēc panākuma — uz pilnveidi; papildus prognozējošā hipotēžu pārkārtošana atmet vājas idejas, pirms tām tiek tērēts budžets.
Atliktā testa līknes pierāda vispārināšanu vienā jomā, nevis pārnesi starp jomām: nevajadzētu gaidīt, ka MI tirgus signālu ieguvei pielāgota darbplūsma tikpat labi darbosies ar juridiskiem vai biomedicīniskiem tekstiem, atkārtoti nepalaižot izpildes ietvaru. Izpildes ietvars virzās tikai uz vērtētāja noteikto mērķi, tāpēc tas apzinīgi pārmācīsies arī trokšņainai mācību kopai vai nepareizi kalibrētam vērtētājam. Pirms nopietna procesa iesakām izmantot vismaz 20 rūpīgi atlasītus mācību vienumus un atsevišķu izstrādes kopu. Izmaksas ir lielākais praktiskais ierobežojums. Katrā novērtējumā viss konveijers tiek atkārtoti izpildīts visās datu kopās; izvēlētais izguves kandidāts vien patērēja aptuveni 2,2 miljonus ievades tekstvienību, bet nopietna optimizācija ar gpt-5.5 klases modeli vienam uzdevumam izmaksā no vairākiem simtiem līdz nedaudz vairāk par tūkstoti dolāru. Visbeidzot, šie skaitļi iegūti atsevišķos procesos, nevis atkārtotos izmēģinājumos, tāpēc publicējam tos inženiertehniskā emuāra ierakstā, nevis formālā pētījumā.
Meta-Harness parāda, ka autonomu koda pilnveidi var padarīt pietiekami disciplinētu lietošanai uzņēmumos. Tam vajadzīgas strukturālas hipotēzes, prognozējoša priekšfiltrēšana, izolēta novērtēšana, atliktie testi visur, kur to ļauj dati, un pilnīga audita vēsture par katru apstiprināto izmaiņu. Kopā tie sniedz inženieru komandai prognozējamu ceļu no strādājoša sākotnējā konveijera līdz izmērāmi labākam risinājumam, bet darbības vadītājam — vienkāršu modeli: autonomās izpētes ieguvumi stingrā, budžetu ievērojošā sistēmā, kurā pirms jebkādas ieviešanas lēmumu pieņem cilvēks.