मौजूदा सिस्टम्स, जो अपने आप खुद में सुधार करते हैं, उनसे कोडिंग के टास्क में अच्छे नतीजे मिले हैं. लेकिन अभी यह साफ़ नहीं है कि वे असली एंटरप्राइज़ में इस्तेमाल होने वाले जटिल AI वर्कफ़्लोज़ को भी बेहतर बना सकते हैं या नहीं, जिनमें काम लंबे समय तक चलता है.
हमारा मेटा-हार्नेस रिसर्च, एजेंटिक रिट्रीवल, डीप रिसर्च और सिग्नल इंटेलिजेंस वर्कफ़्लोज़ में ऑटोनॉमस सेल्फ-इम्प्रूवमेंट का इस्तेमाल करता है. इसमें एंटरप्राइज़ की ज़रूरतों का भी ध्यान रखा गया है, जैसे अलग डेटा पर इवैल्यूएशन, ऑडिट की तैयारी, खर्च की सीमाएँ और इंसानी मंज़ूरी.
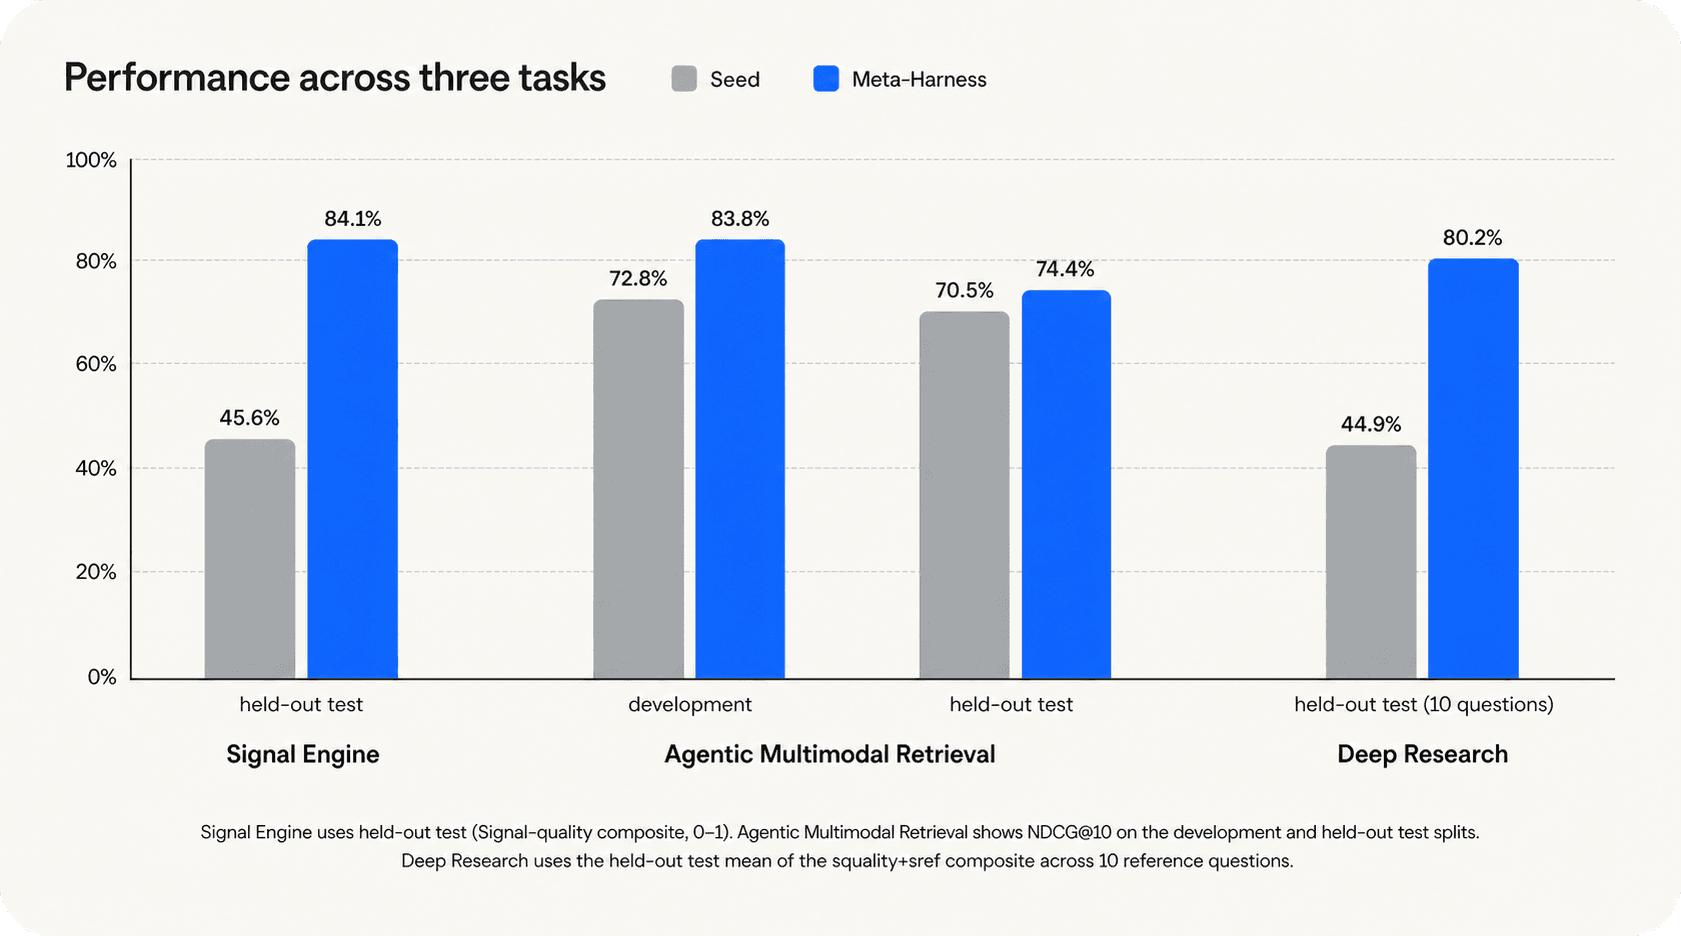
तीन तरह के कामों पर मेटा-हार्नेस ने परफ़ॉर्मेंस में काफ़ी सुधार किया. सिग्नल इंजन के लिए अलग डेटा पर किए गए टेस्ट में परफ़ॉर्मेंस 84% बेहतर हुई. एजेंटिक मल्टीमॉडल रिट्रीवल में ज़्यादा सही नतीजे मिले और काम 16 गुना तेज़ हुआ.
ज़्यादातर पुराने तरीकों से अलग, मेटा-हार्नेस जहाँ संभव हो वहाँ अलग रखे गए डेटासेट पर सफलता को मापता है. इससे पता चलता है कि सुधार सिर्फ़ उस डेटा तक सीमित हैं या नए डेटा पर भी काम करते हैं.
इन नतीजों से पता चलता है कि ऑटोनॉमस वर्कफ़्लो इम्प्रूवमेंट कोडिंग बेंचमार्क से आगे बढ़कर असली एंटरप्राइज़ AI सिस्टम्स में भी इस्तेमाल किया जा सकता है. इससे AI ऐप्लिकेशंस को लगातार बेहतर बनाने का एक प्रैक्टिकल तरीका मिलता है.
ऑटोनॉमस AI रिसर्च पर हाल के काम, जैसे मेटा-हार्नेस पेपर, CORAL फ़्रेमवर्क और karpathy/autoresearch, ने दिखाया है कि कोडिंग एजेंट किसी इवैल्यूएशन मेट्रिक के आधार पर बार-बार काम करके किसी सॉल्यूशन को बेहतर बना सकते हैं. लेकिन अभी यह सवाल बना हुआ है कि क्या ये तरीके कई स्टेप वाले जटिल AI वर्कफ़्लोज़ में भी काम करेंगे. उदाहरण के लिए, एजेंटिक मल्टीमॉडल रिट्रीवल में एजेंट को अलग-अलग तरह के डेटा में बार-बार सर्च करके किसी सवाल का जवाब देना होता है. इसी तरह, कुछ जटिल डेटा प्रोसेसिंग पाइपलाइंस में कई जुड़े हुए स्टेप्स, टूल कॉल्स और अलग-अलग स्थितियों के हिसाब से फ़ैसले लेने पड़ते हैं. बड़ा सवाल यह है कि क्या ये सुधार ऐसे डेटा पर भी बने रहते हैं, जिसे ऑप्टिमाइज़र ने कभी देखा ही नहीं.
हमारा मेटा-हार्नेस R&D इसी सवाल का जवाब देने की कोशिश है. इसमें हाल की रिसर्च से मिले आइडियाज़ को एंटरप्राइज़ की ज़रूरतों के हिसाब से तैयार किया गया है: अलग रखे गए डेटा का इवैल्यूएशन, हर काम का रिकॉर्ड, खर्च की तय सीमा और किसी भी चीज़ को इस्तेमाल में लाने से पहले किसी रिव्यूअर को काम सौंपने का साफ़ तरीका.
हमने इसे कस्टमर के ऐसे तीन टास्क पर टेस्ट किया, जो कई स्टेप में पूरे होते हैं. सिग्नल इंजन AI मार्केट से जुड़े X पोस्ट्स की लाइव स्ट्रीम पर नज़र रखता है और अच्छे से सोर्स करके ट्रेंड रिपोर्ट्स तैयार करता है. एजेंटिक मल्टीमॉडल रिट्रीवल टेक्स्ट और इमेज वाले सवालों को समझकर डॉक्यूमेंट में सबसे काम के पेज ढूँढता है. डीप रिसर्च कई एजेंट्स से वेब पर सर्च करवाता है, सोर्सेज़ को आपस में जाँचता है और लंबी रिसर्च रिपोर्ट्स लिखता है.
सिग्नल इंजन: अलग डेटा पर किए गए टेस्ट का कंपोज़िट स्कोर 0.456 से बढ़कर 0.841 हुआ. यानी 84% का सुधार. इसी खर्च की सीमा में CORAL और karpathy/autoresearch 0.50 से नीचे रहे.
एजेंटिक मल्टीमॉडल रिट्रीवल: अलग डेटा पर किए गए टेस्ट का NDCG@10 स्कोर 0.705 से बढ़कर 0.744 हुआ. हर इवैल्यूएशन में लगा समय 869 सेकंड से घटकर 54 सेकंड हो गया. यानी ज़्यादा सही नतीजों के साथ काम 16x तेज़ हुआ.
डीप रिसर्च: 10 रेफ़रेंस सवालों पर रिपोर्ट की क्वालिटी का कंपोज़िट स्कोर 0.449 से बढ़कर 0.802 हुआ. इसकी तुलना में दूसरे तरीकों का स्कोर करीब 0.52 रहा. इस टास्क में अलग रखा गया डेटा नहीं था, इसलिए इस स्कोर को सिर्फ़ उसी डेटा पर मिली परफ़ॉर्मेंस माना गया है.
सर्च की क्षमता: प्रीडिक्टिव हाइपोथेसिस रीरैंकिंग के साथ, सिग्नल इंजन ने उसी इवैल्यूएशन बजट में 20 की जगह सिर्फ़ 3 इटरेशंस में रेफ़रेंस रन के सबसे अच्छे स्कोर का 91% हासिल कर लिया.
ज़्यादातर ऑटोनॉमस-रिसर्च सिस्टम्स एक ही डेटासेट पर ऑप्टिमाइज़ और इवैल्यूएट होते हैं. इससे यह पता लगाना मुश्किल हो जाता है कि नतीजे नए डेटा पर भी काम करेंगे या नहीं. सिग्नल इंजन और एजेंटिक मल्टीमॉडल रिट्रीवल के लिए हमने डेटा को साफ़ तौर पर तीन हिस्सों में बाँटा है: एक ट्रेनिंग सेट, जिस पर कैंडिडेट्स स्कोर देख सकते हैं; एक डेवलपमेंट सेट, जिससे शुरुआती जाँच की जा सकती है; और एक अलग डेटा पर किया गया टेस्ट सेट, जिसे ऑप्टिमाइज़र कभी नहीं देखता. हर रिपोर्ट किया गया नतीजा एक खास कोड वर्ज़न पर सभी हिस्सों में की गई जाँच से आता है. इसलिए हम एक कैंडिडेट के सबसे अच्छे ट्रेनिंग स्कोर को दूसरे कैंडिडेट के सबसे अच्छे टेस्ट स्कोर के साथ कभी नहीं मिलाते.
हर राउंड में, कोड में बदलाव के लिए हार्नेस कई स्ट्रक्चर किए गए हाइपोथेसिस तैयार करता है. हर हाइपोथेसिस में बताया जाता है कि वह क्या बदलना चाहता है, वह किस पिछले वर्ज़न पर आधारित है और किस समस्या को ठीक करना चाहता है. महँगे इवैल्यूएशन शुरू करने से पहले रैंकिंग के ज़रिए इन हाइपोथेसिस में से बेहतर विकल्प चुनता है. चुने गए हाइपोथेसिस एक साथ काम करने वाले एजेंट्स के पास जाते हैं. ये एजेंट्स एक साझा नॉलेज बेस का इस्तेमाल करते हैं, लेकिन हर एजेंट अलग वर्कस्पेस में कोड एडिट करता है. इससे हर कैंडिडेट की अलग और बिना किसी भेदभाव के जाँच हो सकती है. राउंड के आखिर में, रनर एक विनर चुनता है: वह कैंडिडेट जिसका स्कोर सबसे ज़्यादा है और जो हर कसौटी पर खरा उतरता है. अगले राउंड में इसी विनर को आधार बनाया जाता है. हर ट्रायल अपने नतीजों का एक तय पैकेज एविडेंस स्टोर में सेव करता है: इसमें कोड पैच, हर हिस्से का स्कोर, इवेंट लॉग और LLM द्वारा लिखे गए चार छोटे एनालिसिस शामिल होते हैं. ये एनालिसिस ट्रायल के पूरे रिकॉर्ड, एरर्स, खर्च और उससे मिली सीख को कवर करते हैं. अगला राउंड शुरू करने वाला एजेंट इस पूरी हिस्ट्री को पढ़ता है. इससे हार्नेस पहले से सीखी गई बातों का इस्तेमाल करता है और काम न आने वाले तरीकों को दोबारा आज़माने से बचता है.

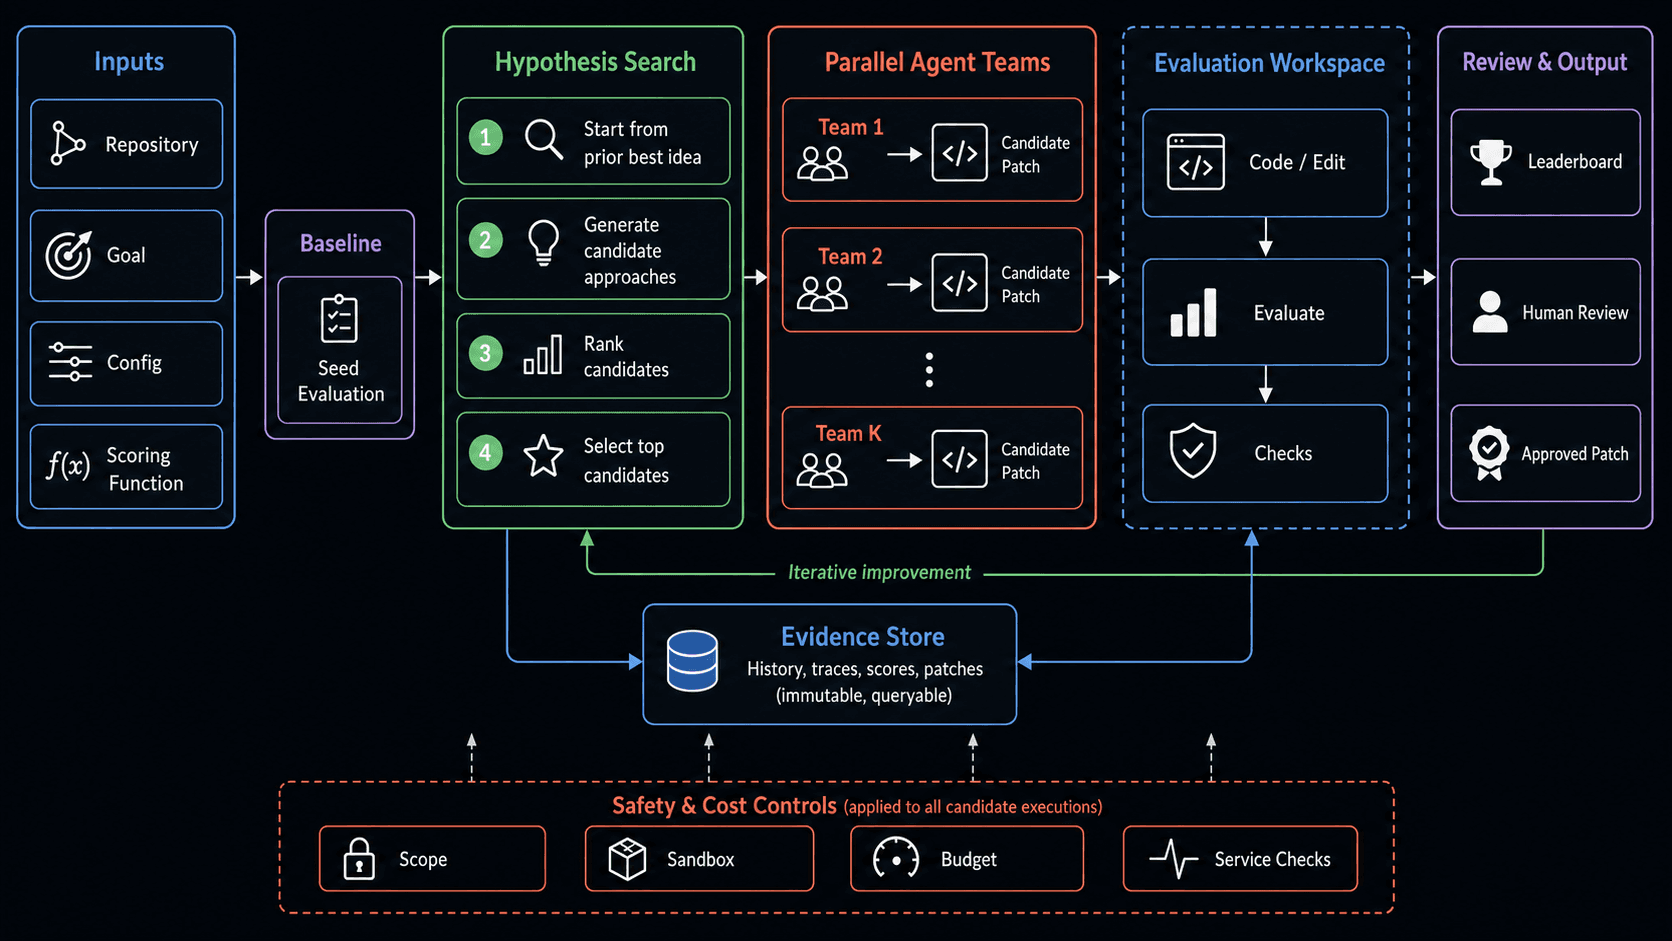
इस पूरे लूप को सुरक्षित रखने के लिए तीन गार्डरेल हैं. पहला स्कोप पॉलिसी तय करता है कि कैंडिडेट किन फ़ाइलों में बदलाव कर सकता है. इसके बाहर का कोई भी बदलाव वापस हटा दिया जाता है. टोकन और समय की सीमाएँ खर्च को एक तय लिमिट के अंदर रखती हैं. कॉन्करेंसी लिमिट्स यह ध्यान रखती हैं कि हार्नेस मॉडल और GPU की रेट लिमिट्स के अंदर रहे. और हार्नेस खुद कुछ भी प्रोडक्शन में नहीं भेजता. यह एक रैंक किया हुआ और पूरे डॉक्यूमेंट के साथ कैंडिडेट तैयार करता है. इसके बाद एक कोई इंजीनियर डिफ़ की जाँच करता है और तय करता है कि उसे प्रोडक्शन में भेजना है या नहीं.
लोकल स्टैक पर, ऊपर बताए गए लूप के हर राउंड के पीछे इंजीनियरिंग के पाँच ज़रूरी हिस्से काम करते हैं.
वर्कस्पेस आइसोलेशन. हर कैंडिडेट के लिए एक Git वर्कट्री होती है. फ़ोर्क एक ही ऑब्जेक्ट डेटाबेस शेयर करते हैं, लेकिन एक-दूसरे की फ़ाइलों को शेयर नहीं करते. इससे कैंडिडेट्स लगभग एक जैसे डिस्क खर्च पर एक साथ चल सकते हैं और मौजूदा फ़्रंटियर के साथ डिफ़ देखना आसान हो जाता है.
एक्ज़ीक्यूशन सैंडबॉक्स. सेटिंग के हिसाब से दो तरीके हैं: तेज़ इटरेशन के लिए नेटिव सबप्रोसेस या पूरी तरह अलग रनटाइम. कॉर्पोरा को सिर्फ़ पढ़ने के लिए माउंट किया जाता है और हर ट्रायल की अस्थायी डायरेक्टरी को जाँच के बाद हटा दिया जाता है. इससे कोई ट्रायल डेटासेट में बदलाव नहीं कर सकता और न ही अपना स्टेट अगले ट्रायल तक पहुँचा सकता है.
स्कोप पॉलिसी. एक्सपेरिमेंट की सेटिंग में उन फ़ाइलों की लोकेशन की लिस्ट होती है, जिनमें बदलाव किया जा सकता है. इसके बाहर किया गया कोई भी बदलाव ट्रायल की जाँच से पहले वापस हटा दिया जाता है और ट्रायल को फ़्लैग किया जाता है. इसलिए रिव्यूअर को दिखने वाला डिफ़ हमेशा तय किए गए स्कोप के अंदर रहता है.
बजट एनफ़ोर्समेंट. इसके तीन स्तर हैं: हर ट्रायल के लिए टोकन और समय की सीमा, पूरे रन के खर्च की कुल सीमा और एक साथ चलने वाले ट्रायल्स की सीमा. इससे खर्च का अंदाज़ा पहले से रहता है और हार्नेस मॉडल और इंफ़्रास्ट्रक्चर की रेट लिमिट्स के अंदर रहता है.
एविडेंस स्टोर. यह एक ऐसा JSONL स्टोर है जिसमें नया डेटा सिर्फ़ जोड़ा जाता है और पुराने डेटा को बदला नहीं जाता. इसमें कोड पैच, हर हिस्से का स्कोर, इवेंट लॉग और LLM द्वारा लिखे गए चार एनालिसिस सेव होते हैं. हर ट्रायल के बाद लीडरबोर्ड, फ़्रंटियर और फ़ेल्योर इंडेक्स जैसे व्यूज़ फिर से तैयार किए जाते हैं. इससे अगले राउंड पहले की हिस्ट्री के आधार पर आगे बढ़ सकते हैं और हर रन को बिल्कुल उसी तरह दोबारा चलाया जा सकता है.
इनमें से कोई भी हिस्सा छोड़ा नहीं जा सकता है. इस हार्नेस का मकसद है कि रन खत्म होने पर रिव्यूअर के पास ऐसी चीज़ हो, जिसे वह सच में मंज़ूरी दे सके: एक विनिंग कैंडिडेट, तय दायरे में रखा गया डिफ़, आज़माई गई हर चीज़ का पूरा रिकॉर्ड और ऐसा खर्च जिसका अंदाज़ा पहले से हो. इन पाँच में से किसी एक को हटा देने पर इनमें से एक गारंटी खत्म हो जाती है.
तीनों एक्सपेरिमेंट्स में हाइपोथेसिस चुनने का एक ही तरीका इस्तेमाल किया गया. हर इटरेशन में, प्रपोज़र बजट से ज़्यादा हाइपोथेसिस तैयार करता है. यहाँ M = 8 कैंडिडेट्स होते हैं, जबकि एक बार में सिर्फ़ K = 4 चलाए जा सकते हैं. इसके बाद एक अलग LLM रैंकर सभी 8 को एक ही 30 सेकंड की कॉल में क्रम देता है. उसके सामने पूरी जानकारी होती है: मौजूदा सबसे अच्छा स्कोर, उसमें कमज़ोर हिस्से, हाल के ट्रायल्स से मिली गड़बड़ियों की जानकारी और सभी 8 प्रपोज़ल. सबसे ऊपर के 4 कैंडिडेट्स को चलाया जाता है. हर कैंडिडेट को चलाने में 15 से 30 मिनट लगते हैं. बाकी 4 को किसी खर्च से पहले ही हटा दिया जाता है.
पूरे टेस्ट के दौरान इस्तेमाल किए गए मॉडल एक जैसे रखे गए. हार्नेस ने सिर्फ़ उनके आसपास के कोड में बदलाव किया. सिग्नल इंजन और डीप रिसर्च gpt-5.5 पर चले. एजेंटिक मल्टीमॉडल रिट्रीवल ओपन-वेट Qwen3.6-35B-A3B पर चला, जिसे लोकल तौर पर vLLM के ज़रिए चलाया गया. इसके साथ ColQwen3-4B इमेज रिट्रीवर इस्तेमाल किया गया. यह कॉम्बिनेशन इसलिए चुना गया क्योंकि इससे ऑन-प्रिम के खर्च का बेहतर अंदाज़ा लगाया जा सकता है.
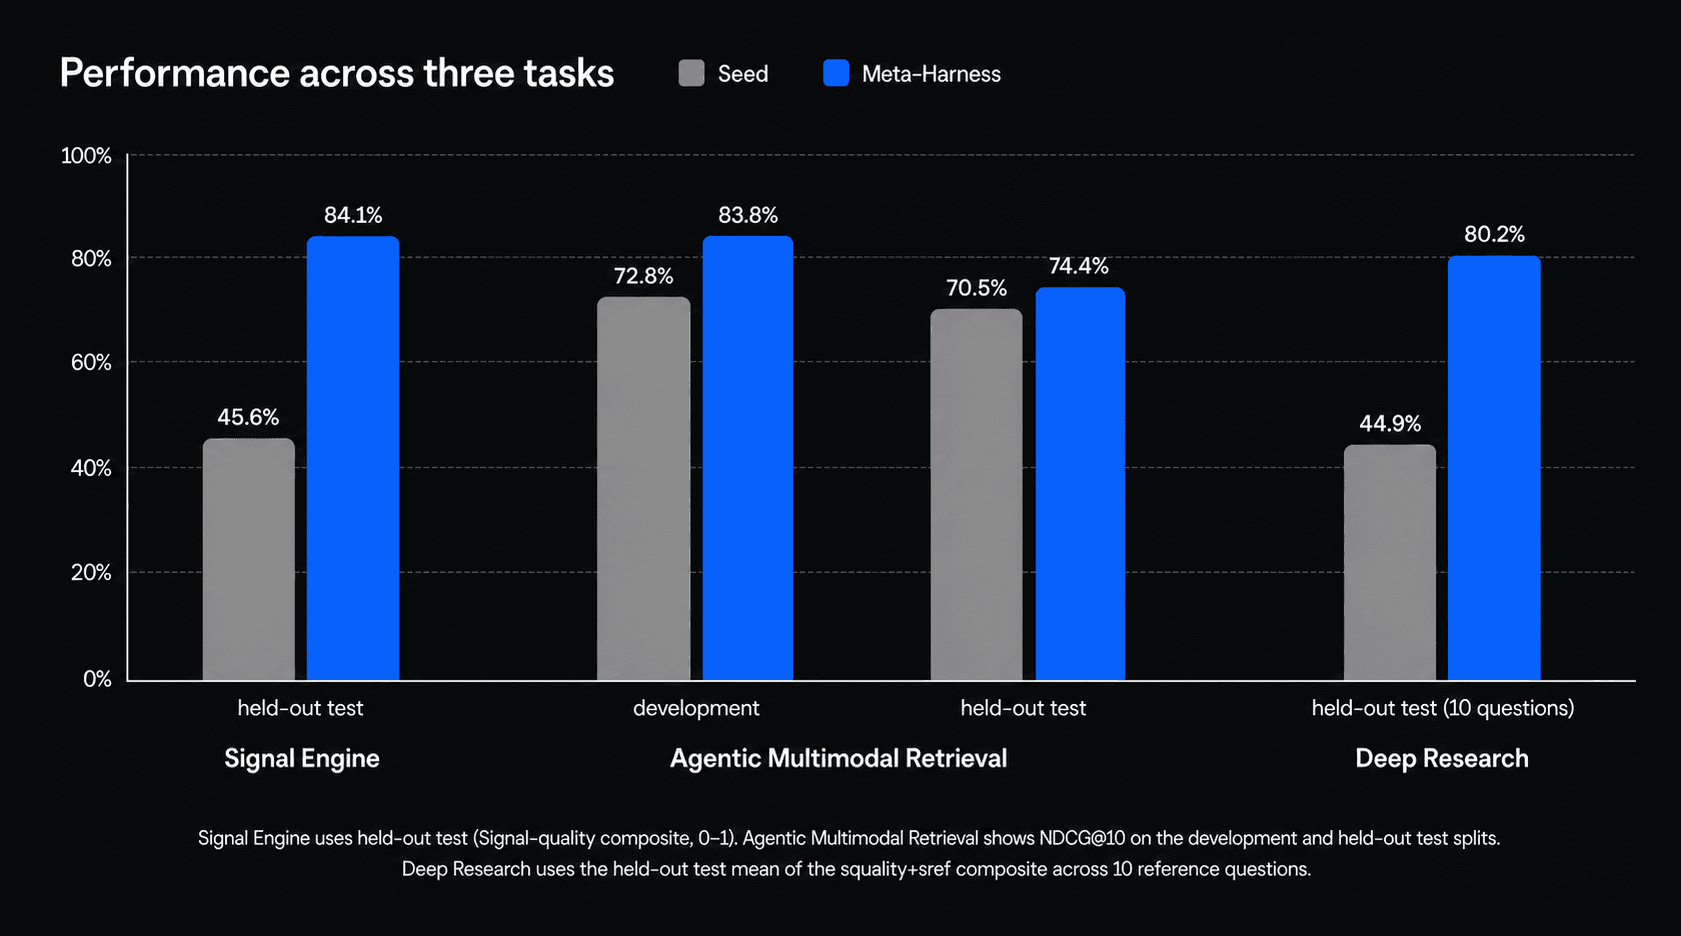
नीचे दिया गया चार्ट हमारे तीन मुख्य टास्क के स्कोर में हुए बदलाव दिखाता है. "सीड" वह शुरुआती कोड है जिसे एक इंजीनियर ने लिखा था. "मेटा-हार्नेस" वह सबसे बेहतर वर्ज़न है जो मेटा-हार्नेस को मिला. अलग डेटा पर किए गए टेस्ट में तीनों टास्क की परफ़ॉर्मेंस बेहतर हुई.
सिग्नल इंजन का इवैल्यूएशन एक LLM ने किया और इसमें ताज़गी, सही जानकारी, जानकारी का स्तर और भाषा के टोन के आधार पर फ़ैसला किया गया. इसके लिए 150 ट्रेनिंग ट्वीट्स और 150 अलग रखे गए टेस्ट ट्वीट्स इस्तेमाल किए गए. पूरे रन के दौरान, सबसे बेहतर वर्ज़न ने ट्रेनिंग कंपोज़िट स्कोर 0.431 से बढ़ाकर 0.756 और अलग डेटा पर किए गए टेस्ट का स्कोर 0.456 से बढ़ाकर 0.841 कर दिया. यह सुधार सिर्फ़ प्रॉम्प्ट में बदलाव से नहीं आया. बेहतर इटरेशंस में हार्नेस ने सोशल मीडिया की गैर-ज़रूरी जानकारी को छाँटना, तथ्यों को दोबारा जाँचना और हर नतीजे को साफ़ सबूत से जोड़ना सीखा. नीचे दिया गया डायग्राम इस पूरे प्रोसेस को दिखाता है.

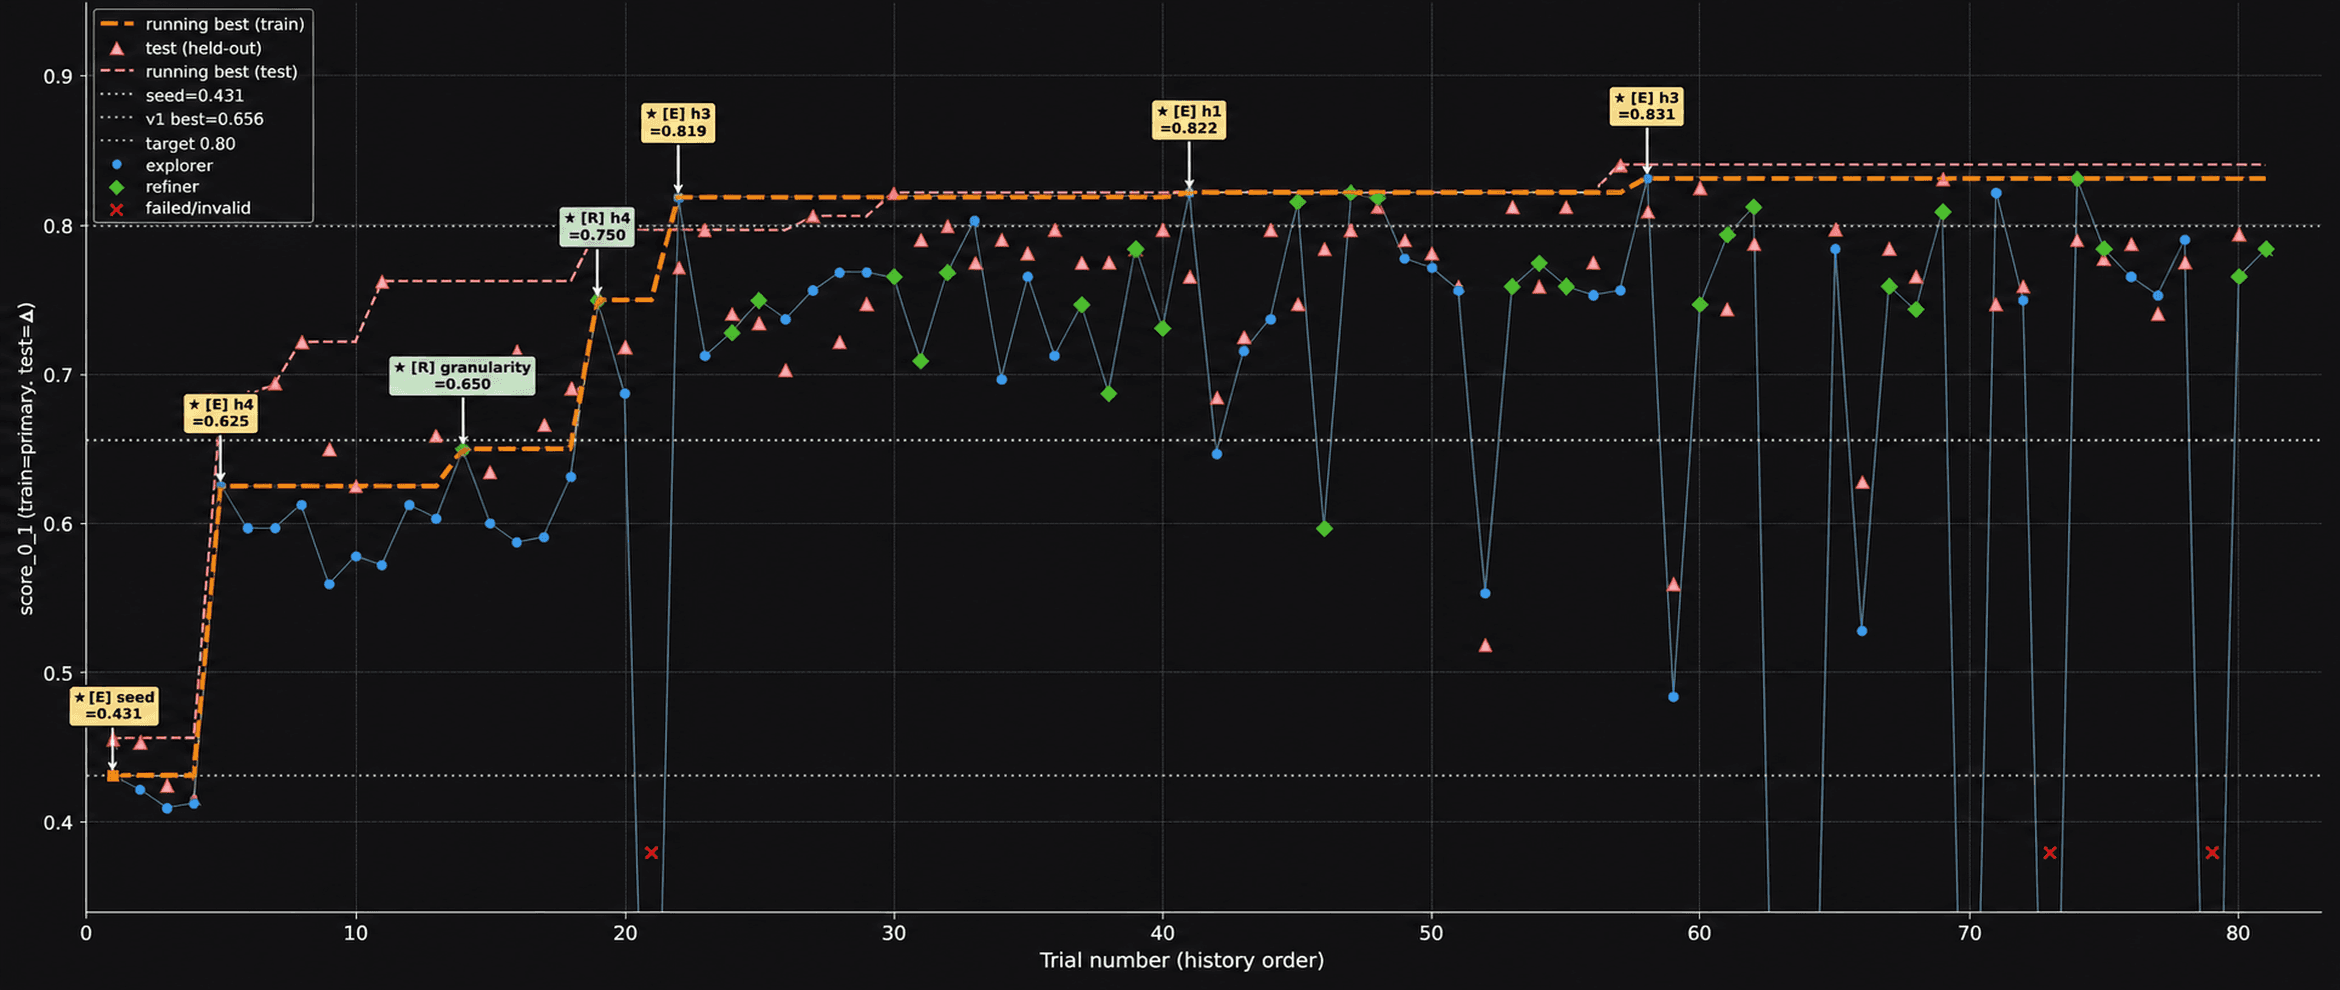
ट्रायल की हिस्ट्री से पता चलता है कि ये सुधार कैसे धीरे-धीरे हुए. शुरुआत में एक बड़े बदलाव से सबसे अच्छा स्कोर 0.625 तक पहुँचा. बेहतर तरीके से एविडेंस संभालने पर यह 0.679 हुआ. इसके बाद रिफ़्लेक्शन और रूब्रिक के बेहतर लूप से यह 0.819 तक पहुँच गया. करीब आधे कैंडिडेट रन उम्मीद के मुताबिक नहीं रहे या पूरी तरह फ़ेल हो गए. लेकिन इससे लीडरबोर्ड पर कोई असर नहीं पड़ा. हर फ़ोर्क अलग चला, कमज़ोर नतीजों वाले बदलाव हटा दिए गए और फ़ेलियर का रिकॉर्ड रिफ़्लेक्शन स्टोर में रखा गया. इससे अगला प्रपोज़र वही रास्ता दोबारा नहीं आज़माता.
सबसे अहम बात यह है कि पूरे रन के दौरान अलग डेटा पर किए गए टेस्ट का स्कोर भी ट्रेनिंग स्कोर के साथ बढ़ता गया. इससे लगता है कि हार्नेस सिर्फ़ ट्रेनिंग डेटा को याद नहीं कर रहा था, बल्कि वर्कफ़्लो को बेहतर बना रहा था. अलग डेटा पर किए गए टेस्ट के स्कोर ट्रेनिंग स्कोर से थोड़ा ज़्यादा थे. हम इसे दो छोटे और अलग-अलग डेटा हिस्सों के बीच सैम्पलिंग का अंतर मानते हैं.
एजेंटिक मल्टीमॉडल रिट्रीवल को पब्लिक ViDoRe V3 कंप्यूटर साइंस डेटा के एक हिस्से पर NDCG@10 से मापा गया. इसमें 20 ट्रेनिंग, 10 डेवलपमेंट और 20 अलग रखे गए टेस्ट सवाल थे. हार्नेस ने अलग रखे गए टेस्ट का NDCG@10 स्कोर 0.705 से बढ़ाकर 0.744 किया. साथ ही, पूरे इवैल्यूएशन में का समय 869 सेकंड से घटकर 54 सेकंड हो गया.
डीप रिसर्च की जाँच LLM के स्कोर से की जाती है. इसमें रिपोर्ट की क्वालिटी और रेफ़रेंस की क्वालिटी, दोनों को देखा जाता है. DeepResearch-Eval के तरीके के मुताबिक 10 रेफ़रेंस सवालों पर इसे टेस्ट किया गया. बेहतर कोड से औसत स्कोर 0.449 से बढ़कर 0.802 हो गया. बेहतर वर्ज़न में हुए बदलाव डिफ़ में साफ़ दिखते हैं: रिसर्च एजेंट्स को काम देने से पहले अलग-अलग तरीकों की तुलना करने वाला एक प्लानिंग स्टेप और आखिर में ऐसा रिव्यू स्टेप, जो उन हिस्सों पर ध्यान देता है जहाँ रिपोर्ट्स के स्कोर पहले कम रहे थे. यह डेटा छोटा है और इसके इवैल्यूएशन में ज़्यादा खर्च आता है, इसलिए इसे अलग हिस्सों में नहीं बाँटा गया. इस नतीजे को हमने उसी डेटा पर मिली परफ़ॉर्मेंस माना है.
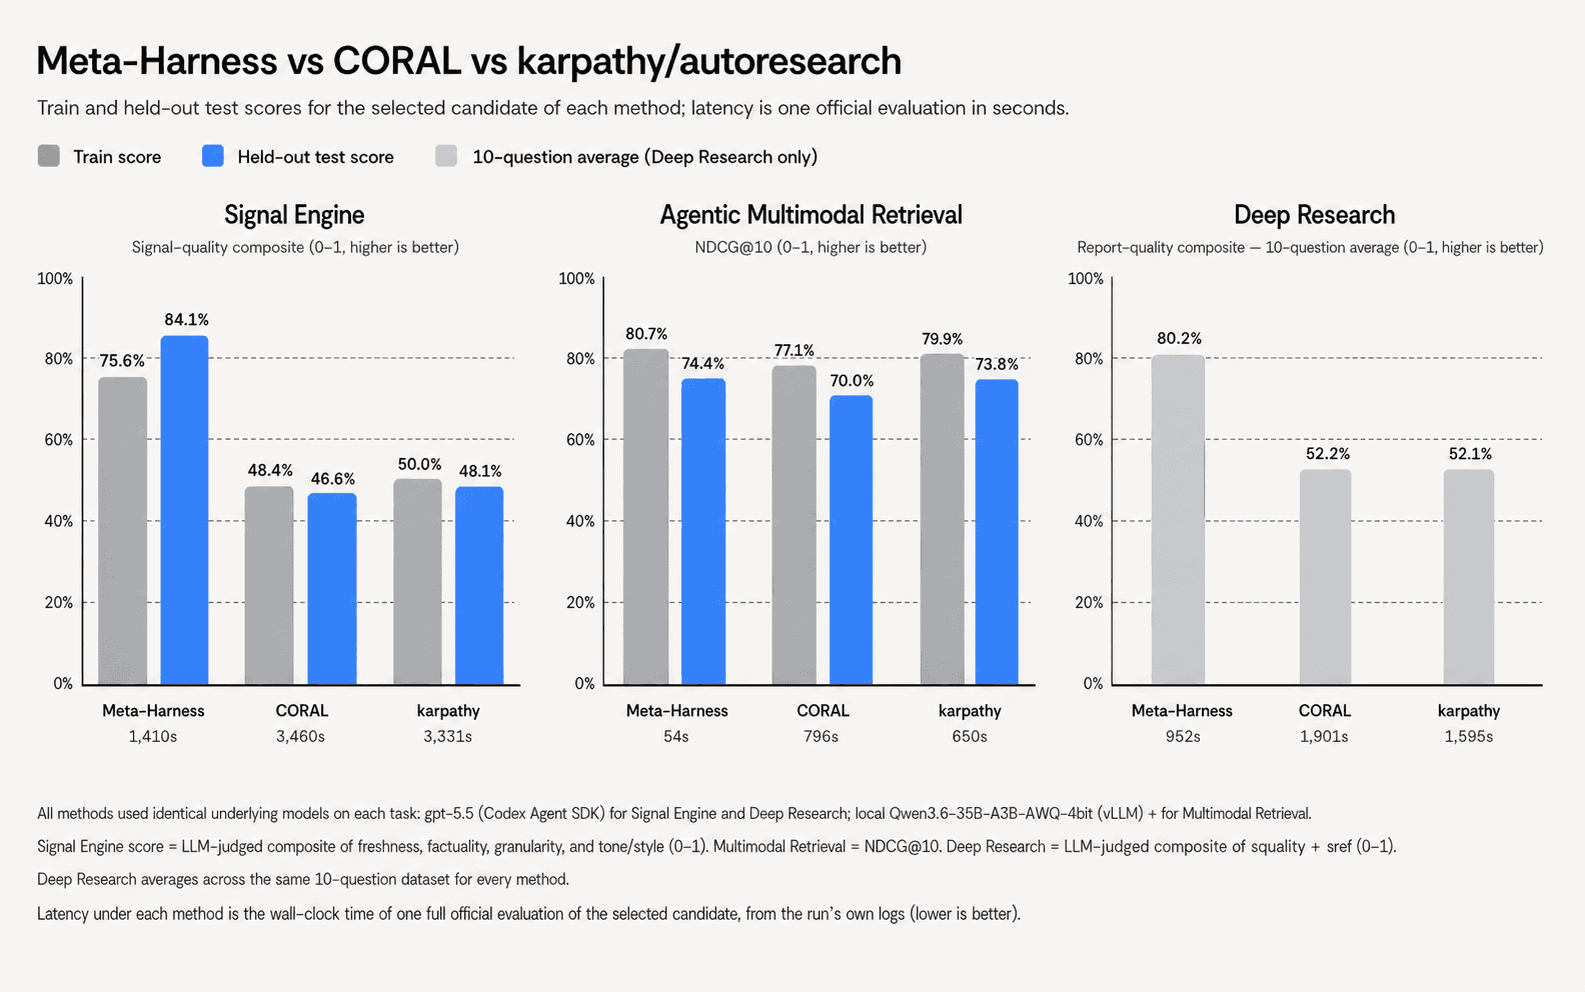
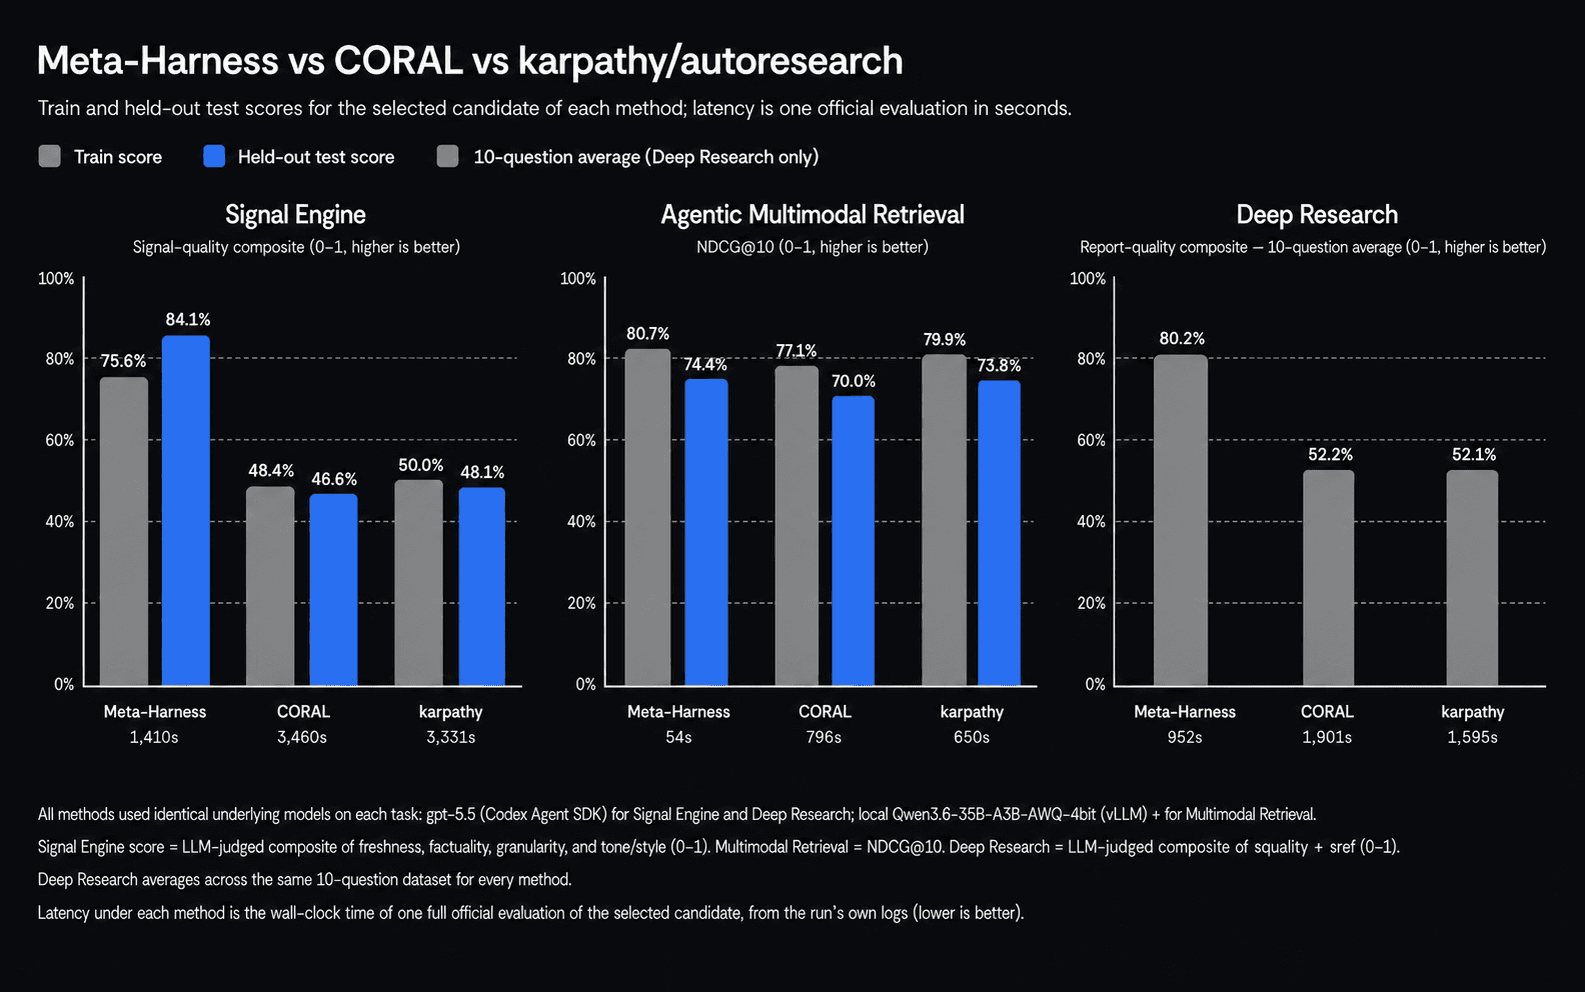
हमने तीनों तरीकों को एक ही बजट में टेस्ट किया: वही डेटासेट, वही मॉडल, उतनी ही इटरेशंस की सीमा और कैंडिडेट्स के उतने ही इवैल्यूएशंस. सिग्नल इंजन में मेटा-हार्नेस ने अलग रखे गए टेस्ट पर 0.841 का स्कोर हासिल किया, जबकि दोनों दूसरे तरीकों का स्कोर 0.50 से नीचे रहा. एजेंटिक मल्टीमॉडल रिट्रीवल में हमारी टीम का अलग रखे गए टेस्ट पर NDCG@10 स्कोर सबसे ज़्यादा रहा (0.744, जबकि CORAL का 0.700 और karpathy का 0.738 था). साथ ही, हमारी जाँच 12 से 14 गुना तेज़ चली: 54 सेकंड, जबकि CORAL में 786 सेकंड और karpathy में 650 सेकंड लगे. डीप रिसर्च में हमारी टीम ने 0.802 का स्कोर हासिल किया, जबकि दोनों दूसरे तरीकों का स्कोर करीब 0.52 रहा. एक बात ध्यान में रखनी चाहिए: हमने CORAL और karpathy/autoresearch को उनके दिए गए ब्यौरे के आधार पर ही तैयार किया था. इसलिए इनके बीच कुछ अंतर सिर्फ़ तरीके के अंतर की वजह से नहीं, बल्कि इन्हें तैयार करने के तरीके की वजह से भी हो सकता है.
इस अंतर के पीछे चार बड़े कारण हैं. पहला, कोड में बदलाव करने से पहले हमारी टीम एक स्ट्रक्चर्ड डिज़ाइन तैयार करती है. इससे सिर्फ़ प्रॉम्प्ट में छोटे बदलाव करने के बजाय पूरे सिस्टम में बड़े बदलाव करने पर ज़्यादा ध्यान जाता है, जैसे नई पाइपलाइन स्टेज जोड़ना. दूसरा, यह एक ही शुरुआती कैंडिडेट से जुड़े कई फ़ोर्क एक साथ चलाता है. इससे CORAL के अलग-अलग एजेंट्स या karpathy के एक-एक करके चलने वाले तरीके की तुलना में सुधार तेज़ी से जुड़ते जाते हैं. तीसरा, हर ट्रायल अपने नतीजे, इवेंट लॉग और LLM द्वारा लिखे गए चार एनालिसिस सेव करता है. अगला प्रपोज़र इन्हें पढ़कर आगे का काम तय करता है. दूसरे तरीकों में सिर्फ़ साधारण कोशिशों का रिकॉर्ड रखा जाता है. चौथा, एक एडैप्टिव कंट्रोलर यह तय करता है कि लंबे समय तक सुधार न होने पर नए तरीके आज़माए जाएँ और अच्छे नतीजे मिलने पर उसी तरीके को और बेहतर किया जाए. इसके ऊपर प्रीडिक्टिव हाइपोथेसिस रीरैंकिंग कमज़ोर आइडियाज़ को पहले ही हटा देता है, ताकि उन पर बजट खर्च न हो.
अलग रखे गए टेस्ट के स्कोर यह दिखाते हैं कि इसी तरह के डेटा पर सुधार बना रहता है. लेकिन इससे यह साबित नहीं होता कि यही सुधार दूसरे डोमेन में भी काम करेंगे. उदाहरण के लिए, AI मार्केट से सिग्नल निकालने के लिए बेहतर किया गया वर्कफ़्लो कानूनी या बायोमेडिकल टेक्स्ट पर भी उतना ही अच्छा काम करेगा, यह मानकर नहीं चल सकते. इसके लिए हार्नेस को फिर से चलाना होगा. हार्नेस वही चीज़ बेहतर करता है जिसे जाँचने के लिए स्कोर तय किया गया है. इसलिए अगर ट्रेनिंग डेटा में गड़बड़ी है या जज सही तरीके से काम नहीं कर रहा है, तो हार्नेस उसी के हिसाब से नतीजे बेहतर करता रहेगा. किसी गंभीर रन से पहले कम से कम 20 अच्छी तरह चुने गए ट्रेनिंग आइटम और एक अलग डेवलपमेंट सेट रखना बेहतर है. सबसे बड़ी व्यावहारिक दिक्कत खर्च है. हर जाँच में पूरे पाइपलाइन को सभी डेटा हिस्सों पर फिर से चलाया जाता है. सिर्फ़ चुने गए रिट्रीवल कैंडिडेट में करीब 22 लाख इनपुट टोकन लगे. gpt-5.5 जैसे मॉडल पर किसी टास्क को गंभीरता से ऑप्टिमाइज़ करने में सैकड़ों से लेकर कुछ हज़ार डॉलर तक खर्च हो सकते हैं. आखिर में, ये नतीजे बार-बार किए गए कई ट्रायल्स के बजाय एक-एक रन से मिले हैं. इसलिए हमने इन्हें फ़ॉर्मल स्टडी के बजाय एक इंजीनियरिंग ब्लॉग पोस्ट के तौर पर शेयर किया है.
मेटा-हार्नेस दिखाता है कि ऑटोनॉमस कोड इम्प्रूवमेंट को एंटरप्राइज़ में इस्तेमाल करने लायक बनाया जा सकता है. इसके लिए स्ट्रक्चर्ड हाइपोथेसिस, पहले से कमज़ोर आइडियाज़ को हटाने का तरीका, अलग-अलग इवैल्यूएशन, जहाँ डेटा उपलब्ध हो वहाँ अलग डेटा पर टेस्ट और हर बदलाव का पूरा रिकॉर्ड ज़रूरी है. इससे इंजीनियरिंग टीम अपने मौजूदा वर्कफ़्लो को धीरे-धीरे बेहतर कर सकती है और हर सुधार को माप सकती है. साथ ही, ऑपरेशंस टीम के लिए भी मॉडल आसान रहता है: ऑटोनॉमस तरीके से नए विकल्प आज़माने का फायदा मिलता है, लेकिन यह सब तय बजट और साफ़ नियमों के अंदर होता है और कुछ भी इस्तेमाल में लाने से पहले कोई व्यक्ति उसकी जाँच करता है.